NVIDIA Developer Blog
مصدر أخبار الذكاء الاصطناعي. تُختار المقالات وتُعدَّل من قِبَل تحرير Hamidun News.
أحدث المنشورات
NVIDIA DAQIRI: استدلال ذكاء اصطناعي في الوقت الفعلي أثناء جمع البيانات عالي السرعة
قدمت NVIDIA إطار DAQIRI الذي يدمج الذكاء الاصطناعي مباشرة في تدفق البيانات القادمة من المستشعرات والأجهزة العلمية دون تأخير.
NVIDIA تكشف عن Halos: منظومة للسلامة الوظيفية للروبوتات العاملة بالذكاء الاصطناعي
NVIDIA Halos حزمة متكاملة للسلامة الوظيفية في الذكاء الاصطناعي المادي، أي الروبوتات التي تعمل إلى جانب البشر في المصانع والمستودعات والمستشفيات.
NVIDIA تشرح كيفية تدريب نماذج Transformer بدقة منخفضة دون خسارة في الجودة
نشرت NVIDIA دليلًا لتحسين نماذج Transformer عبر FP8 وBF16: كيف يمكن تسريع التدريب وخفض استهلاك ذاكرة GPU دون فقدان الدقة.
NVIDIA تشرح كيفية إدارة الوكلاء المستقلين في مصانع الذكاء الاصطناعي المؤسسية
تجاوز وكلاء الذكاء الاصطناعي حدود الدردشة بكثير، فهم يعملون لساعات على بيانات الشركات وأنظمتها، وقد شرحت NVIDIA بالتفصيل كيفية بناء بيئة آمنة وقابلة للإدارة لنشرهم.
NVIDIA: كيف تُصمَّم أنظمة تخزين الطاقة بالبطاريات لمصانع الذكاء الاصطناعي
شرحت NVIDIA كيف تختلف مصانع الذكاء الاصطناعي عن مراكز البيانات التقليدية في استهلاك الطاقة، ووصفت متطلبات أنظمة BESS لهذه المنشآت.
NVIDIA TensorRT يحوّل نقاط FP8 المحفوظة إلى محرّكات للاستدلال السريع
شرحت NVIDIA كيفية تحويل نقطة محفوظة (checkpoint) مكمّمة بصيغة FP8 إلى محرّك TensorRT، وهي خطوة تحوّل النموذج المحسَّن إلى أداة جاهزة للإنتاج الفعلي.
NVIDIA JetPack 7.2: وكلاء الذكاء الاصطناعي على الأجهزة الطرفية بأمر نشر واحد
أطلقت NVIDIA الإصدار JetPack 7.2 لمنصة Jetson، وبأمر واحد عبر CLI يمكن نشر حزمة وكلاء كاملة مع ضوابط الخصوصية وتحسين استهلاك الذاكرة.
NVIDIA تسرّع التدريب المسبق لنماذج LLM: صيغة NVFP4 على رقائق Blackwell مع JAX وMaxText
أوضحت NVIDIA كيف تقلّص صيغة NVFP4 على رقائق Blackwell، مع JAX وMaxText، زمن التدريب المسبق لنماذج frontier وتكاليف الحوسبة.
NVIDIA BioNeMo تتيح ضبط نماذج الذكاء الاصطناعي البيولوجية بتقنية LoRA في غضون ساعات
أطلقت NVIDIA حزمة BioNeMo Recipes، وهي مسارات عمل جاهزة لضبط نموذجي ESM2 وEvo 2 اللغويين بتقنية LoRA. وبات تخصيصهما للمهام البيولوجية ممكنًا على وحدتي GPU فقط.
شبكات عصبية أسرع 15 مرة: تحسين الاستدلال من NVIDIA
نشرت NVIDIA تقنية DFlash Speculative Decoding لمعمارية Blackwell: ارتفعت سرعة استدلال النماذج اللغوية 15 مرة مع الدقة نفسها.
NVIDIA توضح الفرق بين VLA وWAM: نهجان لتحكم الروبوتات
NVIDIA تفرّق بين VLA وWAM، وهما فئتان من نماذج الروبوتات: الأولى تتعلم من اللغة والثانية من التنبؤ بفيزياء العالم. وهذا الفرق سيحدد معمارية الذكاء الاصطناعي الفيزيائي.
وكلاء الذكاء الاصطناعي للأعمال: نتائج الاختبار
أطلقت Artificial Analysis معيار AA-AgentPerf، أول معيار مفتوح متعدد الموردين لتقييم البرمجة القائمة على الوكلاء. وتصدّرت NVIDIA المقاييس الرئيسية.
DiffusionGemma: نموذج عصبي لتوليد النصوص بسرعة
حسّنت Google DeepMind نموذجها الجديد DiffusionGemma لمنصات NVIDIA، بهدف تسريع توليد النصوص في الوقت الفعلي ضمن روبوتات الدردشة والمساعدين البرمجيين (copilots) والوكلاء.
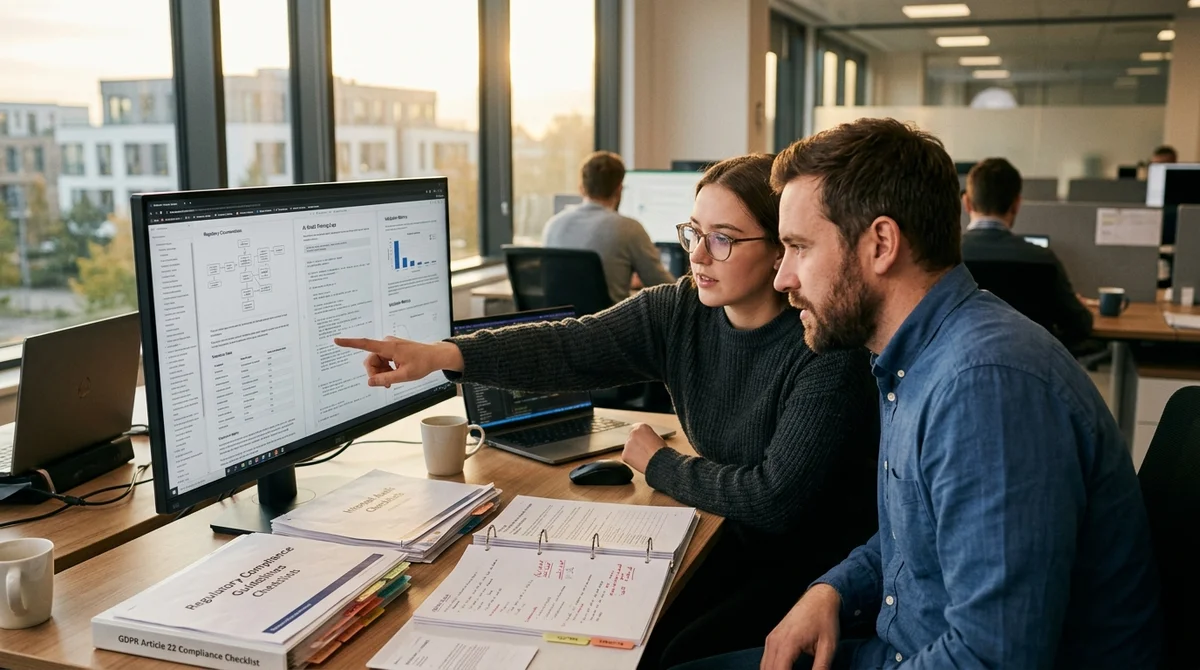
أداة MCG Toolkit من NVIDIA تؤتمت توثيق نماذج الذكاء الاصطناعي لمواكبة اللوائح الجديدة
تطلق NVIDIA أداة لأتمتة توثيق نماذج الذكاء الاصطناعي، تساعد الفرق على الامتثال لمتطلبات الجهات التنظيمية مثل EU AI Act وإعداد بطاقات نماذج (model cards) قابلة للتحقق دون جهد يدوي.
NVIDIA تطرح DynoSim لتحسين إعدادات خدمة نماذج LLM
قدّمت NVIDIA أداة DynoSim لتحسين إعدادات خدمة نماذج اللغة الكبيرة تلقائيًا عبر محاكاة حدود Pareto.
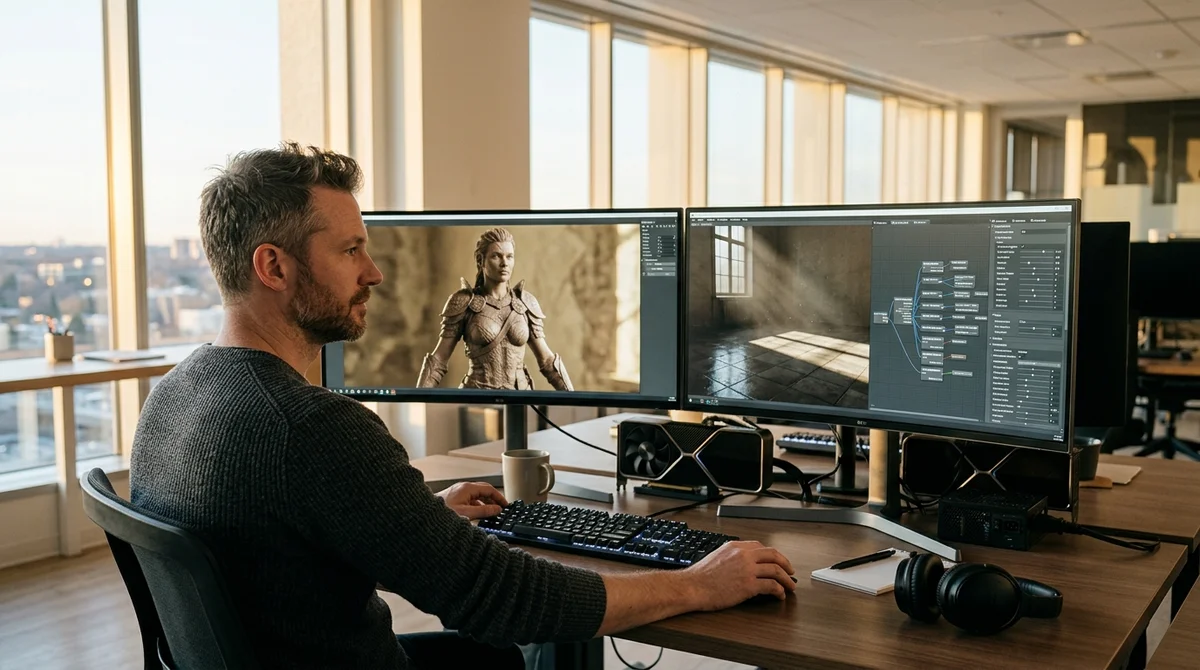
NVIDIA RTX تقدّم DLSS 4.5 وشخصيات ذكاء اصطناعي متعددة اللغات للألعاب
NVIDIA تطلق تحديثًا لـ RTX يدعم شخصيات ذكاء اصطناعي متعددة اللغات عبر ACE، ويضم DLSS 4.5 لمحرك Unreal Engine، بما يبسّط تطوير الألعاب بالذكاء الاصطناعي.
أداة CompileIQ الجديدة من NVIDIA تكشف الإمكانات الكامنة في نوى GPU عبر ضبط معاملات المترجم البرمجي
كشفت NVIDIA عن CompileIQ، أداة مدعومة بالذكاء الاصطناعي تختار تلقائيًا أفضل معاملات المترجم لرفع أداء نوى GPU، وتجد مكاسب في أداء تعذّر على التحسين اليدوي تحقيقها.
NVIDIA Blackwell تسجّل رقمًا قياسيًا في اختبار STAC-AI للذكاء الاصطناعي في التداول المالي
حققت معمارية NVIDIA Blackwell أفضل أداء في اختبار STAC-AI للذكاء الاصطناعي المالي، إذ عالجت حجمًا أكبر من البيانات بسرعة تفوق جميع المنافسين.
NVIDIA Dynamo Snapshot: تسريع تشغيل النماذج على Kubernetes
قدّمت NVIDIA أداة تختصر زمن تحميل نماذج الاستدلال على Kubernetes من دقائق إلى ثوانٍ، لتجنّب هدر وحدات GPU عند ارتفاع الطلب المفاجئ.
الشبكة العصبية Step 3.7 Flash للفيديو والنصوص والصور
أطلقت StepFun نموذج Step 3.7 Flash، وهو نموذج ذكاء اصطناعي متعدد الوسائط بحجم 198 مليار معامل، يعالج النصوص والصور والفيديو والمستندات في وقت واحد على مسرّعات NVIDIA.
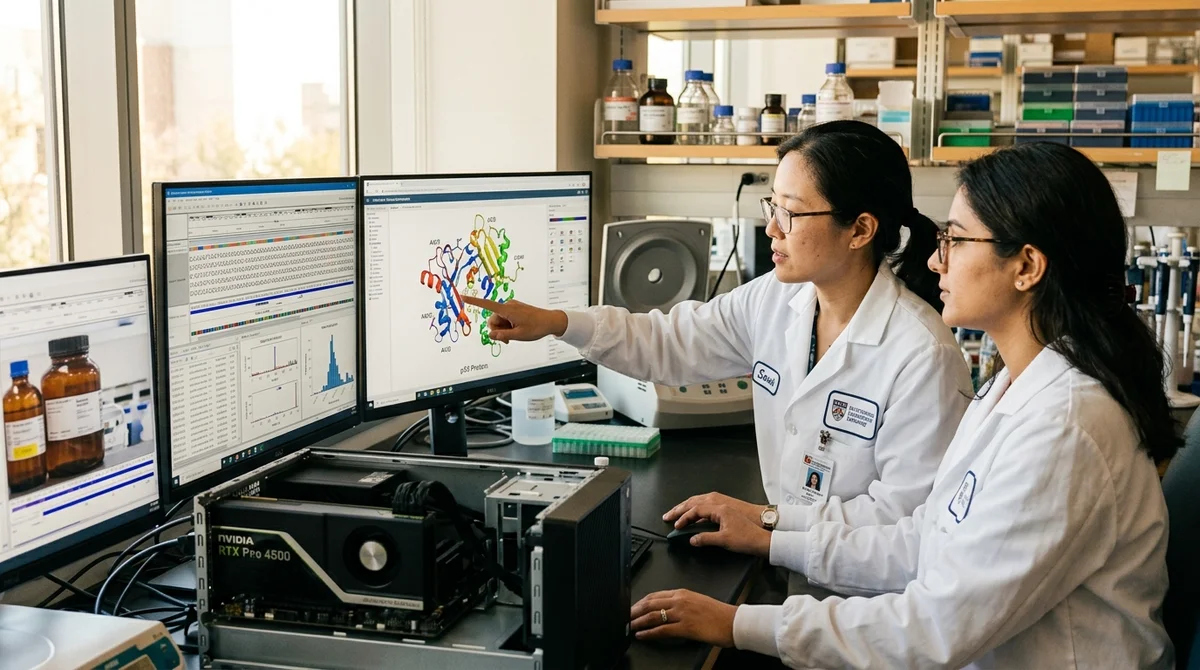
NVIDIA RTX PRO 4500 Blackwell: تسريع علم الجينوم ونمذجة البروتينات
أطلقت NVIDIA بطاقة الرسوميات RTX PRO 4500 Blackwell لتسريع حوسبة الجينوم ونمذجة البروتينات، وهما ركيزتان أساسيتان في الطب الدقيق.
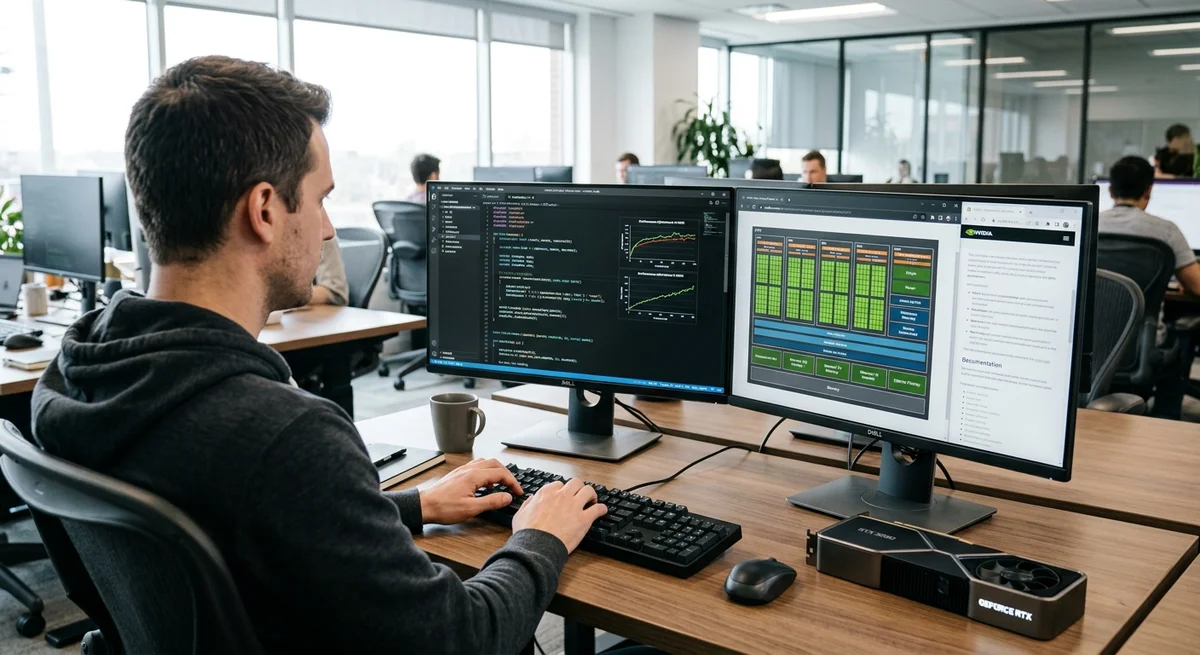
NVIDIA CUDA 13.3 تبسّط تطوير برمجيات GPU عبر البرمجة بالبلاطات (Tile programming) في C++
أطلقت NVIDIA الإصدار CUDA 13.3 مع البرمجة بالبلاطات (Tile programming) في C++، التي تُؤتمت تحسين عمليات الذاكرة منخفضة المستوى في GPU للمطورين.
NVIDIA تضيف CUDA Tile لتحسين أداء نوى GPU المكتوبة بلغة C++
قدّمت NVIDIA تقنية CUDA Tile المدمجة في لغة C++ لتطوير نوى GPU عالية الأداء اعتمادًا على نهج البرمجة القائم على البلاطات (tiles).
اعتماد الذكاء الاصطناعي في الشركات: كيف تُطلق حلّك السحابي الخاص
تبني شركات الاتصالات بنى تحتية سيادية للذكاء الاصطناعي على معمارية NVIDIA Cloud Partner، وتستخدم قياس الرموز (token-metering) للتحكم في الوصول، بما يتيح خدمات قابلة للتوسع وذات هوامش ربح مرتفعة للحكومات والمؤسسات.
تحسين حوسبة الذكاء الاصطناعي: كيف توسّع البنية التحتية على منصات NVIDIA
أوضحت NVIDIA كيفية رفع أداء GB200 NVL72 عبر Slurm مع مراعاة طوبولوجيا الشبكة، وتشير النتائج إلى حوسبة بمستوى الإكسا في حامل واحد.
تحسين مشاريع الذكاء الاصطناعي: مراقبة وحدات GPU في Kubernetes (NVIDIA)
تستخدم معظم الفرق وحدات GPU في عناقيد Kubernetes بأقل من طاقتها، لأنها ببساطة لا ترى من يستهلكها وكم من الذاكرة مشغول، وهل تتعطل الحاويات.
الذكاء الاصطناعي في القطاع المالي: كيف تكتشف الأنظمة متعددة الوكلاء إشارات التداول
تساعد أنظمة الذكاء الاصطناعي متعددة الوكلاء الباحثين على أتمتة البحث عن إشارات التداول في بيانات السوق، عبر تحليل الأسعار والمؤشرات الاقتصادية ومصادر بديلة لرصد الأنماط الخفية.
ذكاء اصطناعي للطب: NVIDIA تطلق مولّد صور ثلاثية الأبعاد
كشفت NVIDIA عن إطار NV-Generate-CTMR لتوليد صور طبية ثلاثية الأبعاد واقعية تلقائيًا، لمعالجة شحّ البيانات في الأشعة وتسريع تدريب نماذج الذكاء الاصطناعي الأكثر قدرة على التعميم.
NVIDIA Vera Rubin: كيف سيتمكن المطورون من توسيع نطاق الذكاء الاصطناعي الوكيلي دون تأخير
كشفت NVIDIA عن منصة Vera Rubin لتوسيع نطاق الذكاء الاصطناعي الوكيلي، وتجمع بين معالج Vera Rubin NVL72 ومسرّع Groq 3 LPX لبلوغ 400 رمز في الثانية على نماذج بحجم تريليون معامل.
NVIDIA توضّح الفرق بين تقييم النماذج وتقييم وكلاء الذكاء الاصطناعي
تختبر معايير النماذج فهم اللغة، بينما يقيس تقييم الوكلاء السلوك الفعلي للنظام أثناء العمل. والمهمتان مختلفتان جوهريًا.