NVIDIA تسرّع التدريب المسبق لنماذج LLM: صيغة NVFP4 على رقائق Blackwell مع JAX وMaxText
نشرت NVIDIA دليلًا تقنيًا للتدريب المسبق لنماذج LLM على رقائق Blackwell: فصيغة NVFP4 مع JAX وMaxText تقلّص زمن التدريب وتكاليف الحوسبة (compute). فكل نسبة مئوية من التسريع على آلاف المسرّعات تعني أيامًا من الوقت الموفَّر. تعتمد NVFP4 أوزانًا بدقة 4 بتات بدلًا من FP8، مع الحفاظ على الدقة في العمليات الحرجة. وهي تعمل الآن مع MaxText المفتوح المصدر دون الحاجة إلى إعادة كتابة الشيفرة.
معالج بواسطة الذكاء الاصطناعي من NVIDIA Developer Blog؛ بتحرير Hamidun News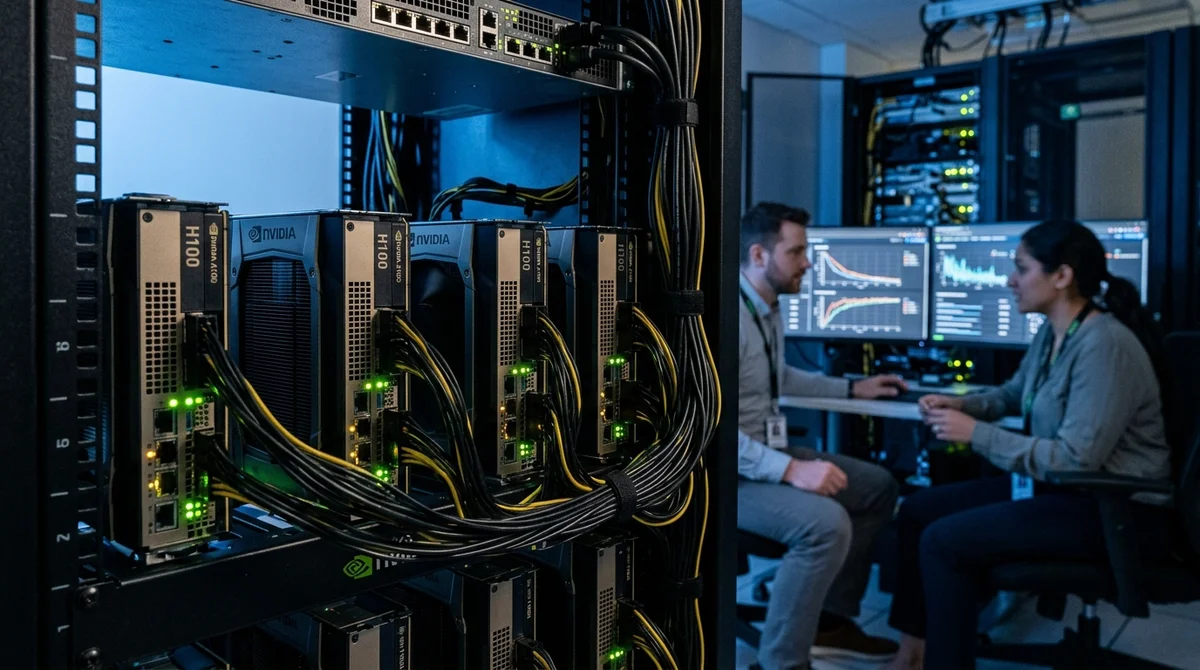
يصطدم التدريب المسبق لنماذج LLM من فئة frontier بحدود الإنتاجية في أنظمة الحوسبة. وقد بيّنت NVIDIA كيف تتيح حزمة JAX وMaxText وصيغة NVFP4 الجديدة على رقائق Blackwell تسريع هذه العملية بصورة ملحوظة دون خسارة في الجودة.
لماذا تهم كل نسبة مئوية؟
عندما يجري التدريب على تريليونات الرموز (tokens) عبر آلاف المسرّعات، فإن توفير نسبة واحدة فقط من الوقت في كل خطوة يتحول إلى عدة أيام من الزمن الفعلي (calendar-time). وعلى نطاق تدريب نماذج frontier، يُترجم ذلك مباشرة إلى ملايين الدولارات من تكاليف الحوسبة.
NVFP4 صيغة عشرية عائمة بأربعة بتات ظهرت لأول مرة في معمارية Blackwell، وأصبحت من الأدوات الرئيسية لتسريع عمليات المصفوفات. وهي تضغط الأعداد بكثافة تبلغ ضعف كثافة FP8، ما يخفف الضغط على الذاكرة ويرفع الإنتاجية الفعلية للنوى التنسورية.
أما التحدي الرئيسي فهو أن الشبكة العددية ذات الأربعة بتات متباعدة القيم. وعند ضبطها بشكل غير صحيح، تخرج التدرجات (gradients) بسهولة عن حدودها، ما يؤدي إلى تباعد التدريب. وقد عالجت NVIDIA وفريق MaxText هذه المشكلة عبر مخططات تحجيم مخصصة وloss scaling ديناميكي.
كيف يعمل mixed-precision مع NVFP4؟
التدريب بدقة مختلطة (mixed-precision) ليس نهجًا جديدًا: فقد أصبحت FP8 وBF16 معيارًا صناعيًا. وتمضي NVFP4 خطوة أبعد، إذ تتيح استخدام أوزان بأربعة بتات في عمليات ضرب المصفوفات الأكثر كثافة، مع الإبقاء على دقة أعلى حيث يكون ذلك مهمًا فعلًا.
- تُطبَّق NVFP4 على الأوزان والتنشيطات (activations) في عمليات GEMM
- يبقى BF16 أو FP32 للمجمِّعات (accumulators) وعمليات التطبيع
- يوجّه MaxText العمليات تلقائيًا إلى الصيغة المناسبة
- يحوّل JAX الرسم البياني للحسابات عبر XLA ويحسّن النوى لـ Blackwell
- النتيجة: ارتفاع في throughput مع استهلاك طاقة مماثل أو أقل
الحزمة التقنية وما الذي يجب تغييره في الشيفرة
MaxText إطار تدريب مفتوح المصدر عالي الأداء مبني على JAX، طورته Google. وقد صُمم في الأصل لوحدات TPU، لكنه يُكيَّف بنشاط لعناقيد GPU، ولذلك فإن الشراكة مع NVIDIA هنا أمر منطقي.
ضمّت NVIDIA نوى NVFP4 منخفضة المستوى إلى مكتبتي cuBLAS وcuDNN، وحصل JAX/XLA على دعم هذه العمليات عبر محوّلات (adapters) خاصة. ولا يحتاج المطورون إلى إعادة كتابة شيفرة التدريب يدويًا؛ يكفي تفعيل الأعلام (flags) اللازمة في إعدادات MaxText والتأكد من أن العنقود يضم رقائق Blackwell (B100 وB200 وGB200).
«الدقة العددية من أكثر المعاملات تأثيرًا، لكن تنفيذ التدريب المسبق بدقة مختلطة منخفضة البتات بالشكل الصحيح أمر معقّد»، بحسب فريق NVIDIA
Developer Blog.
ماذا يعني ذلك؟
بالنسبة إلى الفرق التي تتولى التدريب المسبق لنماذج frontier، تمثل NVFP4 على Blackwell تسريعًا شبه مجاني: فالحزمة الحالية القائمة على JAX وMaxText تتطلب تغييرات طفيفة جدًا في الإعدادات. وعلى نطاق مئات وآلاف وحدات GPU، فإن حتى نمو throughput بنسبة 10–15% يقلّص مباشرة زمن الوصول إلى نقطة الحفظ (time-to-checkpoint) وميزانية الحوسبة الإجمالية.
وينتقل سباق كفاءة التدريب المسبق إلى مرحلة المنافسة على الدقة العددية.
- 12 نوفمبر 2026جوجل تفتح الطلب المسبق على نظارات Gemini بسعر يبدأ من 395 دولارًا وتمنع التصوير الخفي
- 12 نوفمبر 2026جوجل تجلب Gemini Intelligence إلى Android Auto — لهواتف Pixel فقط حتى الآن
- 12 نوفمبر 2026بحسب الدعوى: تلميذة تحدثت مع Gemini عن الانتحار ثلاثة أشهر، وأنظمة المراقبة التزمت الصمت أسابيع
- 12 نوفمبر 2026غوغل وأدوبي تقرّبان منتجاتهما: Acrobat قادم إلى Gmail وDrive وGemini
أسئلة وأجوبة حول الخبر
لماذا تهم كل نسبة مئوية؟
عندما يجري التدريب على تريليونات الرموز (tokens) عبر آلاف المسرّعات، فإن توفير نسبة واحدة فقط من الوقت في كل خطوة يتحول إلى عدة أيام من الزمن الفعلي (calendar-time). وعلى نطاق تدريب نماذج frontier، يُترجم ذلك مباشرة إلى ملايين الدولارات من تكاليف الحوسبة. NVFP4 صيغة عشرية عائمة بأربعة بتات ظهرت لأول مرة في معمارية Blackwell، وأصبحت من الأدوات الرئيسية لتسريع عمليات المصفوفات. وهي تضغط الأعداد بكثافة تبلغ ضعف كثافة FP8، ما يخفف الضغط على الذاكرة ويرفع الإنتاجية الفعلية للنوى التنسورية.
كيف يعمل mixed-precision مع NVFP4؟
التدريب بدقة مختلطة (mixed-precision) ليس نهجًا جديدًا: فقد أصبحت FP8 وBF16 معيارًا صناعيًا. وتمضي NVFP4 خطوة أبعد، إذ تتيح استخدام أوزان بأربعة بتات في عمليات ضرب المصفوفات الأكثر كثافة، مع الإبقاء على دقة أعلى حيث يكون ذلك مهمًا فعلًا.
ماذا يعني ذلك؟
بالنسبة إلى الفرق التي تتولى التدريب المسبق لنماذج frontier، تمثل NVFP4 على Blackwell تسريعًا شبه مجاني: فالحزمة الحالية القائمة على JAX وMaxText تتطلب تغييرات طفيفة جدًا في الإعدادات. وعلى نطاق مئات وآلاف وحدات GPU، فإن حتى نمو throughput بنسبة 10–15% يقلّص مباشرة زمن الوصول إلى نقطة الحفظ (time-to-checkpoint) وميزانية الحوسبة الإجمالية. وينتقل سباق كفاءة التدريب المسبق إلى مرحلة المنافسة على الدقة العددية.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.