ميرا موراتي تكشف عن أول نظام للحوار الطبيعي مع الذكاء الاصطناعي في الزمن الحقيقي
كشف مختبر Thinking Machines بقيادة ميرا موراتي عن TML-Interaction-Small، وهو نموذج يضم 276 مليار معامل. يعالج النظام الصوت والفيديو والنص في وقت واحد، على شكل مقاطع (chunks) مدة كل منها 200 مللي ثانية. ولأول مرة يستطيع الذكاء الاصطناعي الاستماع إلى المستخدم والرد عليه بالتوازي، دون تجميد الإدراك. وتمثل هذه الخطوة تقدماً نحو حوار طبيعي مع الذكاء الاصطناعي.
معالج بواسطة الذكاء الاصطناعي من MarkTechPost؛ بتحرير Hamidun News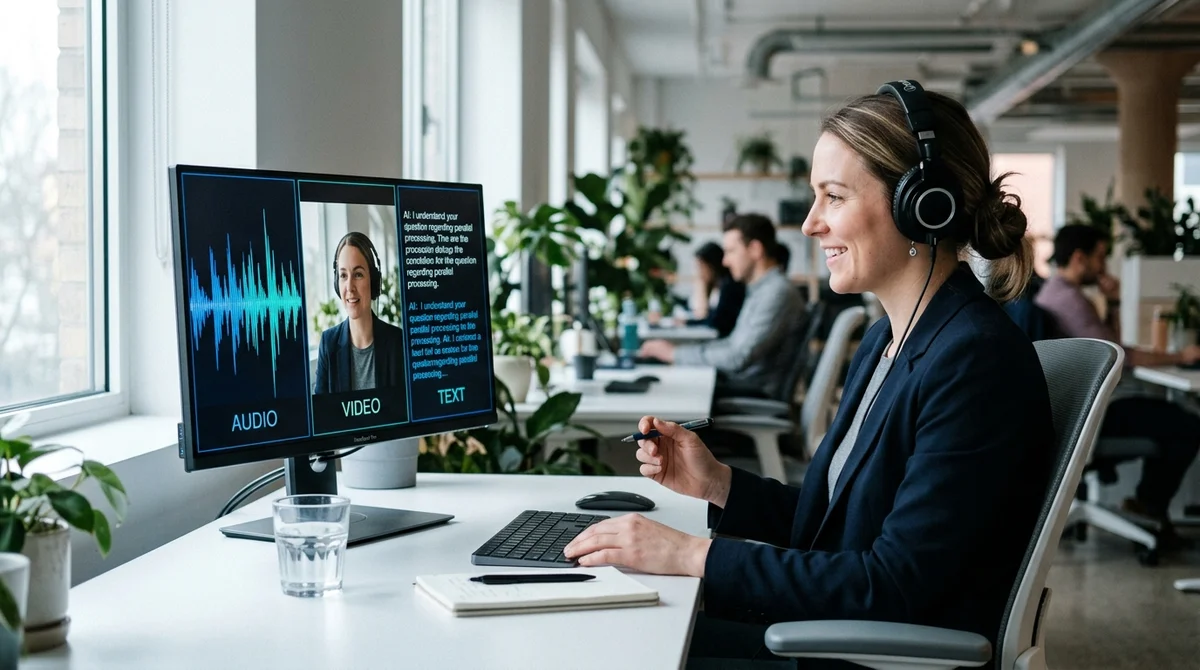
التفكير والاستماع في آن واحد أمر عجزت عنه حتى الآن معظم أنظمة الذكاء الاصطناعي. وقد عرض مختبر Thinking Machines Lab، الذي تقوده ميرا موراتي، أول نموذج أولي يغيّر هذه القاعدة. يعمل نموذج TML-Interaction-Small كما يجري الحوار الحقيقي بين شخصين: يستمع إليك ويُعدّ الرد في الوقت نفسه.
كيف تعمل البنية متعددة المسارات
يضم TML-Interaction-Small نحو 276 مليار معامل، يُفعَّل منها 12 مليار فقط (بصيغة Mixture-of-Experts). أما الفارق المعماري الأبرز فهو أن النظام يعالج الصوت والفيديو والنص في آن واحد ضمن تدفق بيانات موحّد. وتُقسَّم كل المدخلات إلى مقاطع مدة كل منها 200 مللي ثانية، وهو الزمن الذي يكفي ليبقى النموذج متزامناً مع الحوار الفعلي ولا يتخلف عن وتيرة كلام الإنسان.
وثمة تفصيل آخر: يعمل النظام دون وحدات خارجية لرصد النشاط الصوتي (voice-activity detection). وغالباً ما تشكّل هذه الوحدات نقطة اختناق، إذ تضيف تأخيراً وتعقّد البنية. أما هنا فقد دُمج كل شيء داخل الشبكة العصبية نفسها. وبذلك تزول التأخيرات الزائدة ويصبح النظام أكثر استجابة وحيوية بكثير.
محركان متوازيان لمهام مختلفة
يعمل النظام بمكوّنين متوازيين. الأول هو real-time interaction model، وهو مسؤول عن الحوار المباشر مع المستخدم ويوفّر تبادلاً كامل الازدواج (full-duplex) للمعلومات، بحيث يمكنك مقاطعة النظام والتحدث في الوقت نفسه. أما المكوّن الثاني، asynchronous background model، فيفكّر في الخلفية خلال ذلك، ويعمل مع أدوات خارجية وقواعد بيانات، ويتاح له دائماً الوصول الكامل إلى سياق المحادثة.
- المحرك الأول مسؤول عن الردود السريعة في الزمن الحقيقي
- المحرك الثاني يتولى التفكير العميق والعمليات المعقدة
- يرى المكوّنان ويفهمان السياق الكامل للمحادثة بأكملها
- لا يتجمد الإدراك أثناء توليد الرد
- تجري معالجة المعلومات في تدفق مستمر، لا على مراحل منفصلة
ثورة من المعالجة التسلسلية إلى المعالجة المتوازية
تعمل معظم المساعدات الذكية الحديثة وفق مخطط تسلسلي: تنهي كلامك ← يجمّد النظام إدراكه ← يعالج الكلمات ← يقدّم ردّاً جاهزاً. أما TML-Interaction-Small فتخرق هذا المنطق. فهي تستمع إلى المستخدم وتُعدّ الرد في الوقت نفسه، كما في حوار حقيقي بين شخصين.
ويتطلب هذا النهج بنية مختلفة تماماً. فبدلاً من لحظات منفصلة، يعالج النظام البيانات متعددة الوسائط بوصفها تدفقاً مستمراً. وهذا يتيح للنموذج التقاط نبرة الصوت والوقفات والمشاعر وسياق المحادثة. ونتيجة لذلك، لا يبدو المساعد الذكي آلياً، بل يبدو محاوراً حياً.
ماذا يعني ذلك للتفاعل
هذه أول خطوة عملية نحو حوار طبيعي حقاً بين الإنسان والذكاء الاصطناعي. فبدلاً من انتظار الرد التالي، ستتمكن من المقاطعة والاستيضاح والجدال، أي التفاعل كما تتفاعل مع مستشار حقيقي. وبالنسبة إلى الشركات، يعني ذلك إمكانات جديدة لبناء مساعدين يبدون أحياءً، لا باردين ومنفصلين.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.