البنتاغون قد يستعين بروبوتات الدردشة المدعومة بالذكاء الاصطناعي لتحديد أولويات الأهداف في الضربات العسكرية
يجيز البنتاغون استخدام الذكاء الاصطناعي التوليدي لترتيب الأهداف العسكرية والتوصية بأولوية الضربات. وبحسب وصف أحد المسؤولين، يعمل النظام في بيئة مغلقة: يحلل قائمة الأهداف مع مراعاة الوضع الميداني، ثم يرسل استنتاجاته إلى البشر للتحقق منها. وفي ضوء ذلك، تتزايد التساؤلات حول Project Maven، وحول مدى واقعية التحقق من نصائح الذكاء الاصطناعي في ظروف القتال الفعلية.
معالج بواسطة الذكاء الاصطناعي من MIT Technology Review؛ بتحرير Hamidun News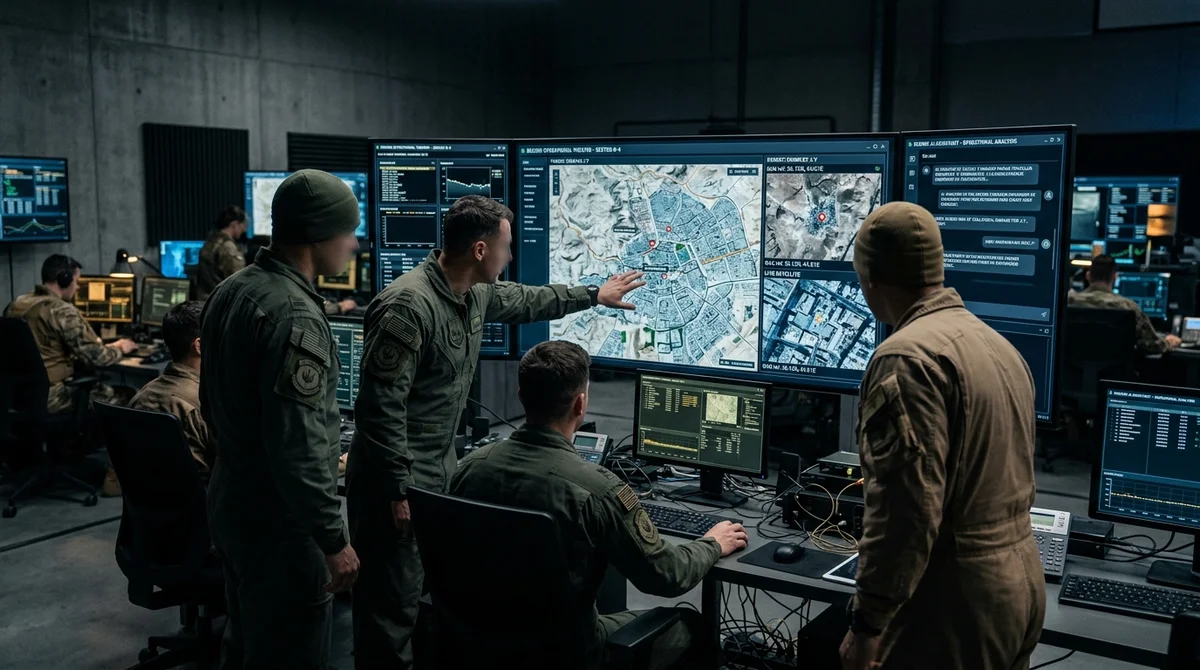
وصف البنتاغون للمرة الأولى بصورة مباشرة إلى حد كبير سيناريو يساعد فيه الذكاء الاصطناعي التوليدي العسكريين لا في البحث عن البيانات فحسب، بل في ترتيب الأولويات ضمن قائمة الأهداف. ورسميًا يبقى القرار النهائي بيد الإنسان، لكن اقتراب روبوتات الدردشة من تحديد أولوية الضربات يرفع بشدة سقف الجدل حول الاستخدام العسكري للذكاء الاصطناعي.
كيف يمكن أن يعمل هذا النظام
بحسب مسؤول في وزارة الدفاع الأمريكية مطلع على الملف، يمكن للعسكريين تحميل قائمة بالأهداف المحتملة في نظام توليدي يعمل ضمن بيئة سرية مغلقة. بعد ذلك يطلب المشغّل من النموذج تحليل المدخلات وتقديم توصيات: أي الأهداف أهم، وأيها يمكن تأجيله، وأي الأهداف يكون من الأنسب ضربه أولًا. ولا يقتصر التحليل على الأهداف نفسها، بل يأخذ في الحسبان عوامل تشغيلية مثل مواقع الطائرات والوضع القتالي العام.
ومن المهم أن المسؤول وصف ذلك بأنه سيناريو عمل ممكن، لكنه لم يؤكد ولم ينفِ أن هذا المخطط مستخدم بالفعل في عمليات حقيقية. وهذا يترك السؤال الأساسي بلا إجابة: أين يقع الحد الفاصل اليوم بين التلميح التحليلي وتأثير الذكاء الاصطناعي في قرار استخدام القوة؟ فمن الناحية النظرية يظل الإنسان المرشّح الأخير، لكن في ظروف الحرب لا تقتصر الأهمية على من يملك حق الضغط الأخير، بل تشمل أيضًا من يحدد ترتيب الإجراءات.
على أي بنية تحتية
لدى البنتاغون أرضية جاهزة لهذا النهج. فمنذ عام 2017 يستخدم الجيش الأمريكي Project Maven، وهو نظام يساعد في تحليل كميات ضخمة من بيانات الاستخبارات، ومنها مقاطع الفيديو من الطائرات المسيّرة والمواد الفضائية، من أجل رصد الأهداف المحتملة بسرعة أكبر. وفي البداية كان الأمر يتعلق أساسًا بالرؤية الحاسوبية: تساعد الآلة في رصد جسم ما، ثم يتحقق منه المشغّل يدويًا.
والآن قد تُضاف فوق هذه المنظومة طبقة حوارية على غرار ChatGPT أو Claude أو Grok. والفارق جوهري: فبعد أن كان الذكاء الاصطناعي يكتشف الأجسام ويضع عليها علامات في الغالب، بات بإمكانه أيضًا الشرح والمقارنة والترتيب والتوصية بالخطوات التالية بلغة طبيعية. ونظريًا يسرّع ذلك عمل هيئات الأركان والمحللين، خاصة مع تدفق كبير للبيانات ونافذة زمنية قصيرة للرد. وفي مثل هذه المنظومة يمكن للنموذج:
- جمع بيانات الاستخبارات المتعلقة بعدة أهداف وتلخيصها
- ترتيب قائمة الأهداف بحسب أولوية الضرب
- مراعاة سياق مثل مواقع الطيران وتوافر الموارد
- اقتراح الهدف الأنسب للتحرك ضده أولًا
- تقديم التوصيات إلى البشر الذين يُفترض أن يتحققوا منها
ومن المهم كذلك أن OpenAI وxAI أبرمتا اتفاقيات تتيح استخدام نماذجهما في بيئات مغلقة تابعة لوزارة الدفاع الأمريكية. وهذا لا يثبت أن أنظمتهما تشارك بالفعل في الاستهداف القتالي، لكنه يبيّن مدى سرعة تشكل القاعدة التقنية والتعاقدية لمثل هذه السيناريوهات. وفي الوقت نفسه ربطت منشورات أخرى المنصات العسكرية بـ Claude أيضًا، رغم أن الدور المحدد للنماذج التوليدية في عمليات بعينها لم يُؤكَّد علنًا.
لماذا احتدم الجدل
جاء الكشف عن هذا النهج في وقت يتعرض فيه البنتاغون أصلًا لضغوط بسبب الضربة التي استهدفت مدرسة للبنات في ميناب الإيرانية. ووفق منشورات مرافقة، قُتل في الضربة أكثر من 100 طفل، وأشار تحقق أولي إلى مشكلة تتعلق ببيانات قديمة استُخدمت في التوجيه. وفي هذا السياق، لم تعد أي تصريحات بأن الذكاء الاصطناعي يكتفي بمساعدة البشر تبعث على الطمأنينة، بل صارت دعوة إلى أسئلة أكثر صرامة.
وأهم هذه الأسئلة بسيط: إلى أي حد يمكن أن تكون المراجعة البشرية حقيقية إذا كان النظام يقدم إجابات مقنعة في ثوانٍ، بينما الوقت المتاح لإعادة التحقق ضيق؟ فإذا احتاج المشغّل إلى وقت يقارب ما يحتاجه النموذج للتحقق المستقل من توصياته، يتقلص المكسب في السرعة. أما إذا بدأ الناس يثقون بالنظام افتراضيًا، فإن خطر الخطأ يصبح منهجيًا. وهذا خطير بصورة خاصة في القرارات العسكرية، لأن ثمن «الهلوسة» أو الترتيب الخاطئ لا يُقاس بتقرير عن خلل برمجي، بل بأرواح البشر.
ماذا يعني ذلك
لا يدخل الذكاء الاصطناعي التوليدي إلى العمليات المكتبية فحسب، بل إلى أكثر أجزاء الآلة العسكرية حساسية: إعداد قرارات استخدام القوة. وحتى لو ظل الإنسان رسميًا «ضمن الحلقة»، فإن السؤال الحقيقي صار مختلفًا: هل يستطيع هذا الإنسان فعلًا التحقق من نصيحة النموذج قبل أن تتحول إلى ضربة؟
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.