OpenAI وGrok يتراجعان أمام RAG مخصص في تحدي Agentic RAG Legal Challenge القانوني
في تحدي Agentic RAG Legal Challenge القانوني، قارن فريق بين قواعد المعرفة الجاهزة من OpenAI وGrok وCAG وBM25 وخط معالجة هجين طوّره بنفسه. تبيّن أن النماذج القوية نفسها تخسر من دون إسناد مرجعي دقيق: فالحاسم ليس الإجابة وحدها، بل الإحالة الصحيحة إلى الصفحة. وتعامل جهاز Mac Studio M3 Ultra المحلي مع تحليل الملفات والتضمينات (embeddings) بنجاح، لكن توليد السياق للمقاطع (chunks) اضطر الفريق إلى إجرائه عبر واجهة API خارجية.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News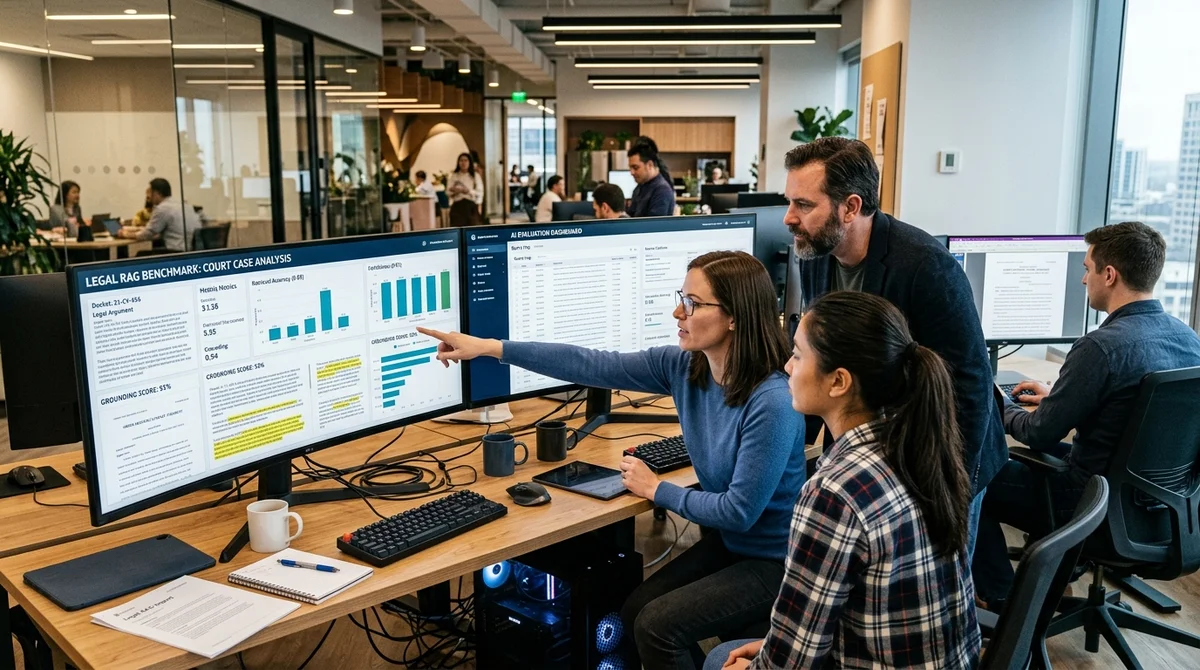
استعرض مؤلفو المقال كيف خاض فريقهم تحدي Agentic RAG Legal Challenge، وهو مسابقة دولية للإجابة عن الأسئلة استنادًا إلى ملفات PDF قانونية. وكان الاستنتاج الرئيسي عمليًا بصورة مزعجة: لا يحسم الفوز اسم النموذج اللامع، بل القدرة على ربط الإجابة بدقة بالصفحة الصحيحة من الوثيقة.
كيف جرى اختبار الأنظمة
شارك في التحدي أكثر من 300 فريق، وتألفت المادة المعتمدة من أحكام قضائية حقيقية وقوانين وأنظمة تنظيمية صادرة عن DIFC باللغة الإنجليزية. في البداية حصل المشاركون على 30 وثيقة و100 سؤال لمرحلة warm-up، ثم على نحو 300 وثيقة و900 سؤال للمرحلة النهائية. وتنوعت الأسئلة: تواريخ وأرقام وأسماء وقوائم وأسئلة بنعم أو لا وإجابات حرة قصيرة. لكن الأهم لم يكن دقة الصياغة وحدها، بل مقياس Grounding، أي ما إذا كانت الصفحات المذكورة تتطابق مع الموضع الذي أُخذت منه الإجابة فعلًا.
«حتى الإجابة المثالية تُصفَّر إذا أشارت إلى صفحة خاطئة.»
وعلى هذا الأساس بنى الفريق خط معالجة خاصًا به: حُوّلت ملفات PDF إلى Markdown، وقُسّمت إلى مقاطع (chunks) ذات معنى متماسك، وأُضيف لكل مقطع سياق مُولَّد، ثم حُسبت تضمينات كثيفة (dense) وتضمينات متفرقة (sparse) وخُزّنت كلها في Qdrant. ونُفذ جزء من العمل محليًا على Mac Studio M3 Ultra. وأنجز الجهاز بسرعة تحليل 30 ملف PDF وحساب التضمينات محليًا، لكن توليد السياق للمقاطع كان بطيئًا للغاية: فبسبب طول مرحلة prefill كان المقطع الواحد يستغرق من 15 إلى 20 ثانية، ولذلك اضطر الفريق إلى نقل هذه المرحلة إلى API خارجي.
من أخفق أولًا
بدأ المؤلفون بأكثر الطرق كسلًا: رفع الوثائق ببساطة إلى قاعدة المعرفة المدمجة في OpenAI. بدا الحل مقبولًا للوهلة الأولى، لكنه حقق في المقاييس Total 0.362: كانت الإجابات في كثير من الأحيان جيدة، بينما أفسد الاستشهاد بالصفحات كل شيء. ثم اختبروا CAG، حيث يُرسَل إلى النموذج المادة كلها تقريبًا دفعة واحدة، من دون بحث في المقاطع. وأظهرت التجربة مع Qwen 3.5 Flash وسياق يصل إلى 1 مليون رمز (token) أن CAG ليس عديم الفائدة: فقد كانت الدقة مرتفعة، لكن Grounding خذله مجددًا. أما BM25 الصرف فكان أداؤه أسوأ، وكان أضعف المحاولات.
خرجت من هذه الجولة عدة استنتاجات مزعجة لكنها مفيدة:
- قواعد المعرفة المدمجة لدى اللاعبين الكبار لا تضمن استشهادًا جيدًا؛
- قد يجيب CAG بدقة، لكنه يخسر في التقييم النهائي إذا لم يربط الإجابة بالصفحات بعناية؛
- لم يعد BM25 الكلاسيكي وحده كافيًا للأسئلة القانونية المعقدة؛
- تفوّق RAG الهجين المزوَّد بإعادة ترتيب (reranking) جيدة على الحلول المدمجة في OpenAI وGrok.
كما أن نظام MORAG الخاص بالفريق لم يترك انطباعًا قويًا في البداية: فقد عجز Qwen المحلي الصغير عن الحفاظ على الدقة، وانهار بصورة خاصة في الأسئلة متعددة الوثائق. وجاء التحول بعد الانتقال إلى Grok عبر OpenRouter واعتماد انتقاء أكثر صرامة للمقاطع. ففي مرحلة warm-up ارتفع أداء الفريق من Total 0.362 في المحاولات الأولى إلى 0.780 في المحاولة النهائية، وارتفع Grounding من نحو 0.45 إلى 0.90. وهذا النمو بالذات، لا استبدال نموذج رائج بآخر، كان العامل الرئيسي في التقدم.
ما الذي ساعد فعلًا
لم يأتِ أبرز المكاسب من «تحسينات جودة» مجردة، بل من عدد من القرارات الهندسية المحددة جدًا. فقد فصل الفريق بين وضعي reasoning وnon-reasoning بحسب نوع السؤال، وأضاف حلقة وكيلية (agentic loop) تعيد البحث إذا لم تكفِ البيانات، وبنى على حدة مجموعة مرجعية (gold set) للتحقق من الإجابات على الأسئلة الـ900. وأتاح ذلك عدم الرماية عشوائيًا في المرحلة النهائية، والعثور سريعًا على أخطاء منهجية، مثل التفسير الخاطئ لصياغة تتعلق باستئناف قُدِّم لكنه رُفض.
- أُبقي نموذج reasoning لأسئلة boolean وname وnames، حيث فقد وضع non-reasoning ما بين 8 و16% من الدقة؛
- استُخدم وضع non-reasoning الأسرع لأسئلة date وnumber وfree_text من دون تراجع ملحوظ؛
- أُضيفت إلى البحث الصفحات من 1 إلى 3 الأولى من الوثائق المذكورة في السؤال، لأن البيانات الأساسية للقضية غالبًا ما تقع هناك؛
- أُعيد بناء الملخصات (summaries) والمتجهات المتفرقة (sparse vectors) لتلائم المجال القانوني؛
- قُلّص حجم المقاطع لتناسب حد مُضمِّن FRIDA، الذي يقتطع كل ما يتجاوز 512 رمزًا.
في المرحلة النهائية، تخلّف MORAG عن golden submission المُعدّ مسبقًا في إجمالي Total، بنتيجة 0.603 مقابل 0.631، لكنه تفوق عليه في ثلاثة من المقاييس الخمسة: دقة الإجابات المحددة سلفًا (deterministic)، وجودة الإجابات الحرة، والسرعة. وجاءت الخسارة مرة أخرى من Grounding. وهذه نقطة مهمة: فنظام RAG نفسه كان يجيب أفضل من المرجع «اليدوي»، لكن الربط التقني للإجابة بالصفحة الصحيحة ظل متأخرًا.
ماذا يعني هذا
تُظهر هذه القصة بوضوح أن CAG لم يقضِ على RAG، وأن Mac Studio يصلح لجزء من خط المعالجة المحلي، وأن قواعد OpenAI وGrok الجاهزة لا تغني عن الضبط وفق مادة محددة. وحين تكون البيانات معقدة، لا تفوز العلامة التجارية الأعلى صوتًا، بل الفريق القادر على قياس الأخطاء، والتحكم في تقسيم المقاطع (chunking)، وإيصال Grounding إلى حالة صالحة للعمل.
Delegate Deep Research, Coding & Workflows to an AI Agent
Deploy autonomous multi-step execution with NomadNet Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and complex task orchestration.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.