Habr AI يوضّح: لماذا لا تجري نماذج LLM العمليات الحسابية ولا تتعلم أثناء المحادثة وتعتمد على الأدوات الخارجية
فنّد Habr AI خرافتين رئيسيتين عن نماذج LLM: فهي لا تتعلم مباشرة داخل الدردشة، ولا تستطيع «فعل كل شيء بنفسها». فالنموذج اللغوي قوي في التعامل مع النصوص، لكنه يحتاج إلى RAG وfunction calling ومنسّق (orchestrator) كي ينفّذ حسابات دقيقة ويصل إلى بيانات محدّثة ويحتفظ بالذاكرة وينفّذ إجراءات. ومن هذه المنظومة المتكاملة تنشأ لاحقًا وكلاء الذكاء الاصطناعي (AI agents) وأدوات copilots والتوائم الرقمية.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News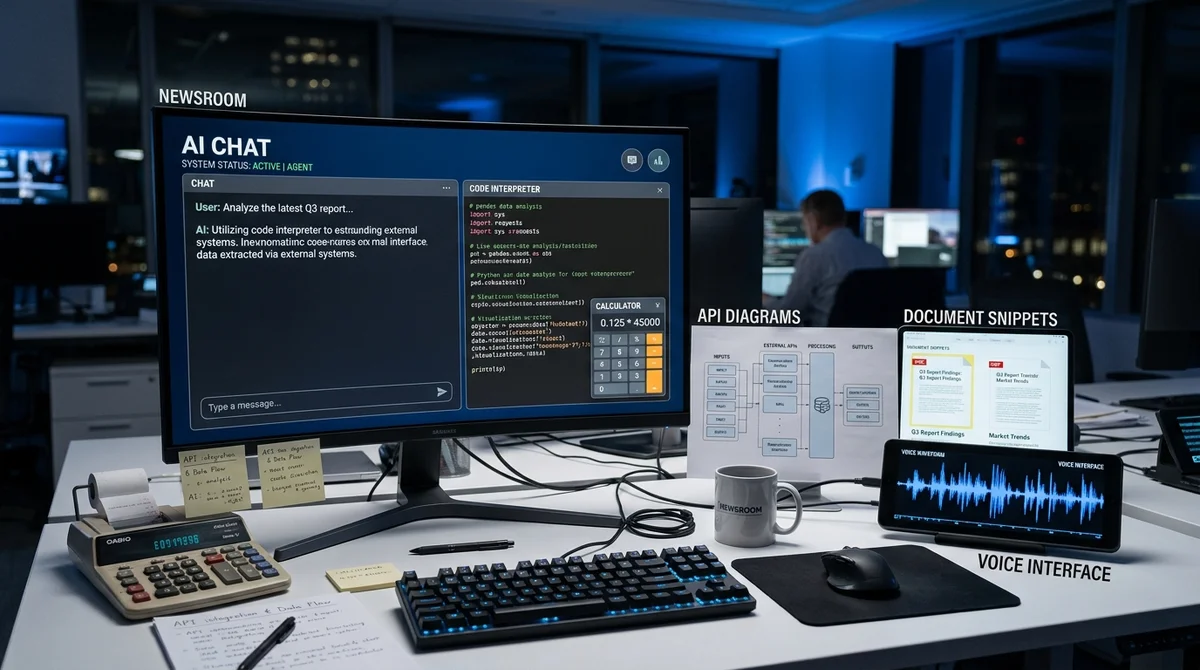
يتناول مقال على Habr AI خرافة شائعة مفادها أن روبوت الدردشة الحديث يمثّل بحد ذاته ذكاءً شاملًا. وخلاصة طرح الكاتب بسيطة: نموذج LLM الأساسي لا يستطيع بطبيعته سوى العمل مع النصوص، أي استقبال طلب نصي وتوليد ردّ نصي. أما كل ما عدا ذلك مما يراه المستخدم «قدرات سحرية» للنموذج، فتوفّره في العادة أدوات خارجية وتكاملات وطبقة تنسيق. ولهذا يمكن لواجهات المستخدم نفسها أن ترسم الصور وتبحث في الإنترنت وتجري العمليات الحسابية، مع أن النموذج اللغوي ذاته لا يتحول بذلك إلى فنان أو محرك بحث أو آلة حاسبة.
يرتبط الوهم الأول بالانطباع بأن LLM «تجيد كل شيء». فإذا طلبتَ منها إنشاء صورة، فإنها تصوغ طلبًا موجّهًا إلى نموذج توليد منفصل. وإذا تحدثتَ معها صوتيًا، فإن سلسلة المعالجة تضم التعرّف على الكلام وتركيب الصوت. وإذا احتجتَ إلى حساب دقيق، فإن النتيجة الموثوقة لا تظهر في الغالب إلا بعد استدعاء مفسّر شيفرة (code interpreter) أو أداة حسابية أخرى. وبدون هذه الإضافات، تعتمد LLM على إعادة إنتاج احتمالية للأنماط التي تعلّمتها أثناء التدريب: فقد تحلّ مسألة بسيطة بشكل صحيح، لكنها تخطئ بسهولة مع الأعداد الطويلة والمعادلات والمسائل التي تتطلب دقة عالية. ومن ذلك تنبع حدود عملية مهمة: فنقطة قوة النموذج ليست الرياضيات في ذاتها، بل صياغة وصف المسألة نصيًا واختيار الأداة المناسبة.
أما الخرافة الثانية فهي الاعتقاد بأن النموذج يتعلم مباشرة أثناء المحادثة. ويذكّر الكاتب بأن الاستدلال (inference) والتدريب عمليتان مختلفتان. فعندما يكتب المستخدم طلبه، يولّد النموذج الرموز (tokens) تباعًا اعتمادًا على أوزان ثابتة مسبقًا، ولا تتغير هذه الأوزان في تلك اللحظة. وهذا يعني أن نموذج LLM بعينه في جلسة بعينها لا «يحفظ الدرس» ولا يصبح أذكى بسبب ملاحظة من المستخدم. صحيح أن بإمكان مزوّدي الخدمة لاحقًا استخدام محادثات مجهولة الهوية لتدريب إصدارات مستقبلية، لكن ذلك دورة تدريب إضافي منفصلة، وليس تحديثًا ذاتيًا سحريًا داخل الدردشة. ويترتب على ذلك استنتاج آخر: فالذاكرة عن المستخدم بين المحادثات ليست في العادة تدريبًا للنموذج، بل سياق محفوظ يُدمج مجددًا في الطلب.
بعد ذلك يشرح المقال بإيجاز مكوّنات نموذج LLM العام. فأساسه المحوّل (transformer) الذي يرى كامل السياق المتاح دفعة واحدة، ويبني الردّ على هيئة سلسلة من الرموز المحتملة، محافظًا على تماسك النص العام بفضل القوالب التي استوعبها. وفوق ذلك تعمل تقنية RLHF، وهي ضبط النموذج على صيغة المساعد واللباقة واتباع التعليمات وقيود السلامة. لكن RLHF لا تحوّل النموذج إلى آلة منطقية، ولا تعالج نقاط الضعف الجوهرية. لذلك تجيد النماذج اللغوية تحليل النصوص والتلخيص وتغيير الأسلوب وكتابة التعليمات خطوة بخطوة والتعامل مع صيغ مثل JSON واختيار الأدوات. وتضعف في الحسابات الدقيقة ومعالجة الجداول الكبيرة والاحتفاظ بحجم هائل من البيانات في السياق ومعرفة الوضع الراهن للعالم بعد تاريخ التدريب. ويُضاف إلى ذلك الطابع الاحتمالي للإجابة وحساسيتها لصياغة الـ prompt وخطر الهلوسة (hallucinations).
ولكي تصبح LLM مفيدة في بيئة الإنتاج، تُبنى حولها طبقة إضافية. فللمعارف الثابتة تُستخدم RAG: تُقسَّم المستندات إلى مقاطع، ويُبحث عند الطلب عن المقاطع الأقرب دلاليًا، فلا يتلقى النموذج إلا السياق ذا الصلة. وللبيانات الديناميكية والإجراءات يُستخدم function calling: إذ تقرّر LLM متى تستدعي API أو قاعدة بيانات أو آلة حاسبة أو محاكاة، بينما يتحقق المنسّق (orchestrator) من صحة الاستدعاءات، ويضيف ردود الأدوات إلى سجل المحادثة، ويدير الدورة بأكملها. ويتولى المنسّق نفسه أيضًا ذاكرة المحادثة وموجّهات النظام (system prompts) والتحقق من صيغة المخرجات وتشغيل الوكلاء الفرعيين (subagents).
وعلى هذا الأساس تنشأ المفاهيم الأكثر رواجًا: وكلاء الذكاء الاصطناعي (AI agents) و«الموظفون الرقميون» وأدوات copilots والتوائم الرقمية. وهي في جوهرها ليست سحرًا مستقلًا، بل توليفات من LLM وقواعد المعرفة وواجهات API والأتمتة ومحرّكات الحوسبة التقليدية. وهذا يعني أن الحديث عن «الذكاء الاصطناعي» دون التمييز بين التقنيات لم يعد كافيًا.
فإذا احتاجت الشركة إلى حساب دقيق أو أتمتة صارمة أو توقّع قائم على بيانات منظمة، فإن LLM وحدها لا تكفي. أما إذا كانت الحاجة إلى العمل مع الرسائل والمستندات والتعليمات والبحث في المعرفة وواجهة حوارية لنظام معقد، فإن LLM تحقق بالفعل قفزة قوية. وتكمن فائدة النظرة المتزنة في المقال في أنها تخفّض التوقعات المبالغ فيها: فلا ينبغي أن نعزو إلى النموذج اللغوي قدرات خارقة، لكن لا ينبغي كذلك الاستهانة بقيمته بوصفه واجهة ومنسّقًا لأدوات أخرى.
Delegate Deep Research, Coding & Workflows to an AI Agent
Deploy autonomous multi-step execution with NomadNet Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and complex task orchestration.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.