Google وOpenAI أمام سقف البيانات: ماذا سيحدث إذا نفد النص البشري من الإنترنت
وقع الذكاء الاصطناعي التوليدي في اعتماد غريب: تحتاج النماذج إلى النصوص البشرية، لكنها تقلّص الحافز على إنتاجها. فملخصات AI في البحث تحدّ من الانتقال إلى المواقع، فيما يمتلئ الإنترنت بسرعة متزايدة بمحتوى مولَّد آليًا. وإذا ترسّخت هذه الحلقة، فسيحصل المطوّرون في النهاية على كمية أقل من البيانات الجيدة للتدريب، وستبدأ إجابات النماذج الجديدة بالتراجع بشكل ملحوظ.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News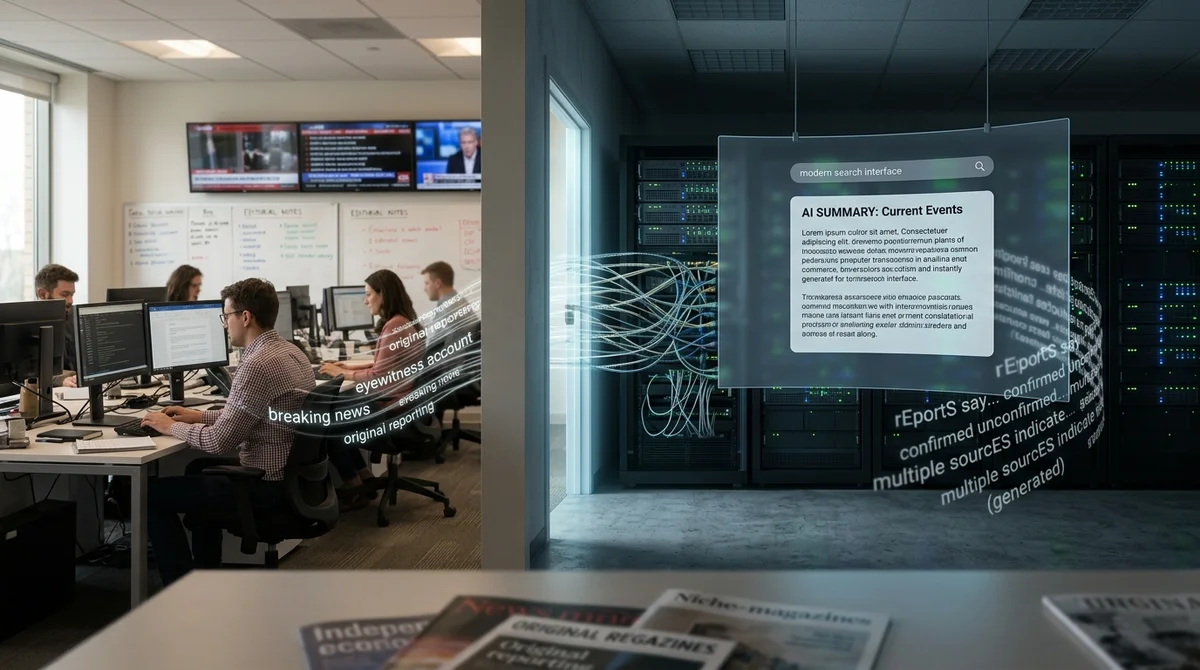
نقطة الضعف الرئيسية في الذكاء الاصطناعي التوليدي أنه يعيش على النص البشري، وفي الوقت نفسه يهدم الظروف التي يظهر فيها هذا النص. فمحركات البحث وروبوتات الدردشة وملخصات AI تَعِد المستخدم بإجابة سريعة دون الانتقال إلى أي موقع، وبذلك تخفض إيرادات من ينتجون المادة الأصلية. وعلى المدى القصير تكسب النماذج بفضل سهولة الاستخدام، لكنها على المدى الطويل تخاطر بالبقاء بلا قاعدة جيدة للتدريب، وبأن تبدأ التعلّم من انعكاسات نفسها.
المشكلة الأولى هي اقتصاديات النشر. فبعد إطلاق Google AI Overviews في مايو 2024، صار البحث يجيب مباشرة في صفحة النتائج بوتيرة متزايدة، دون أن يحيل القارئ إلى المصدر الأصلي. ووفق بيانات Chartbeat التي نشرتها Axios في 17 مارس 2026، فقدت المواقع الصغيرة التي تتراوح زياراتها بين 1 و10 آلاف مشاهدة يوميًا نحو 60% من الزيارات القادمة من البحث خلال عامين.
وتراجعت المواقع المتوسطة بنسبة 47%، والكبيرة بنسبة 22%. وأظهرت دراسة لمركز Pew Research Center في 22 يوليو 2025 أثرًا مشابهًا على مستوى سلوك المستخدمين: فعندما تتضمن النتائج ملخصًا من AI، ينقر الناس على الروابط العادية بدرجة أقل بشكل ملحوظ. وبالنسبة إلى وسائل الإعلام والمنتديات والمدونات المتخصصة والكتّاب المستقلين، ليس هذا مؤشرًا مجردًا، بل ضربة مباشرة للإعلانات والاشتراكات والدافع إلى مواصلة الكتابة.
المشكلة الثانية هي البيانات نفسها. فقد نمت النماذج اللغوية الكبيرة في الأصل على مجموعات ضخمة من نصوص الإنترنت. ففي أنظمة مبكرة مثل GPT-3، جُمع الجزء الأكبر من مدوّنة التدريب من الويب والمصادر المرتبطة به. لكن حجم المحتوى البشري الجيد ليس لا نهائيًا. ففي يونيو 2024 قدّر باحثو Epoch AI أن الصناعة قد تبلغ، إذا استمرت وتيرة التوسّع السابقة، سقف النصوص المتاحة للعموم والصالحة للتدريب في نافذة زمنية بين عامي 2026 و2032. ولهذا بدأ كبار اللاعبين توقيع صفقات مع Reddit والناشرين وغيرهم من مالكي الأرشيفات الكبيرة: فقد تحوّلت مسألة الوصول إلى البيانات من تفصيل تقني إلى أصل استراتيجي.
في هذا السياق، يبدو إغراء التحوّل إلى البيانات الاصطناعية شبه حتمي. فإذا لم يكن النص الحي كافيًا، فمن المنطقي أن يُطلب من نموذج توليد مادة للنموذج التالي. غير أن هذا الأسلوب يُضعف الجودة تدريجيًا. فالدراسة المنشورة في Nature في 25 يوليو 2024 تصف ظاهرة model collapse: عند التدريب المتكرر على بيانات مولَّدة آليًا، تبدأ النماذج بفقدان الحقائق النادرة، وتسطيح الأنماط المعقدة، وتضخيم الأخطاء والانحيازات الموجودة أصلًا. ويشبه ذلك نسخ الصفحة نفسها مرات عديدة: يظل المعنى العام مرئيًا، لكن التفاصيل تبهت مع كل نسخة. وحتى OpenAI أقرّت علنًا بأن البيانات الاصطناعية قد تفيد في حالات محددة، لكنها لا تبدو بديلًا كاملًا عن المدوّنة البشرية المتنوعة.
وهناك فخ آخر: فصل النص البشري عن النص الآلي أصعب بكثير في الممارسة مما يبدو. فكاشفات محتوى AI ما زالت تخطئ، خصوصًا في النصوص القصيرة أو المحرَّرة أو المحايدة أسلوبيًا. وأظهرت دراسات منفصلة نسبة عالية من الإنذارات الكاذبة على نصوص كتبها أشخاص لغتهم الأم ليست الإنجليزية. وهذا يعني أنه سيكون من الصعب على الصناعة أن «تنظّف الإنترنت» ببساطة وتنتقي البيانات البشرية الموثوقة فقط. بل إن تقييمات أكاديمية حديثة ترصد أن حصة مساعدة AI في المنشورات الجديدة تنمو بسرعة، وأن المحتوى على الإنترنت نفسه يزداد تشابهًا في المعنى وتعقيمًا في النبرة. وبعبارة أخرى، لا تتعلق المشكلة بكمية النص فقط، بل بتنوعه أيضًا.
وإذا لم تُكسر هذه الحلقة، فسيعمل الإنترنت بصورة أسوأ لجميع الأطراف في آن واحد. سيقلّ نشر الكتّاب للمواد المعمّقة، لأن تحقيق دخل منها يزداد صعوبة. وستواصل المنصات ملء صفحات النتائج بملخصات AI الموجزة، فتوفّر نقرة المستخدم لكنها تُفقر منظومة المصادر. أما مطوّرو النماذج فسيحصلون على قدر متزايد من المحتوى الثانوي الذي يبدو واثقًا لكنه يحمل معرفة جديدة أقل. ويبدو أن المخرج لا يكمن في مزيد من التوليد، بل في الحفاظ على الحوافز للكتابة البشرية: بدفع رسوم التراخيص، وإسناد المحتوى إلى مصادره بشفافية، واستخدام ملخصات AI بحذر أكبر، وتقديم جودة البيانات على الحجم المجرد. وإلا فسيجد الذكاء الاصطناعي نفسه فعلًا في الفخ الذي نصبه لنفسه.
- 30 أكتوبر 2026Mistral تفتح أوزان Large 4: قوي في البرمجة، لكن النماذج الصينية تسجل 32 نقطة مقابل 26
- 30 أكتوبر 2026Google: وكلاء الذكاء الاصطناعي مع Android CLI ينجزون مهام الواجهات أسرع بنسبة 77%
- 30 أكتوبر 2026Gemini 4 Carbon من Google تسجّل 88,2% في اختبار اكتشاف الثغرات، والوصول إليه مقيّد حتى الآن
- 29 أكتوبر 2026Google تفتح Android Studio أمام وكلاء ذكاء اصطناعي من جهات أخرى: Claude وCodex وأكثر من 40 وكيلًا آخر
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.