هرم الاختبار كأداة لتفكيك المهام لوكلاء الذكاء الاصطناعي في QA Assist
واجه نظام QA Assist المؤلف من 11 وكيل ذكاء اصطناعي مشكلة كلاسيكية: النموذج اللغوي لا يستطيع استيعاب المشروع بأكمله في طلب واحد بسبب نافذة السياق. والحل هو هرم الاختبار. تأتي أولاً اختبارات الوحدة، ثم اختبارات التكامل، ثم اختبارات E2E. وتتسع كل طبقة داخل السياق وتُولَّد بمعزل عن غيرها. يشرح ميخائيل فيدوروف كيف يمكن إطعام الشبكة العصبية «الفيل» على قطع صغيرة، ولماذا تبدو نظرية ضمان الجودة (QA) الكلاسيكية أكثر أهمية من أي وقت مضى.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News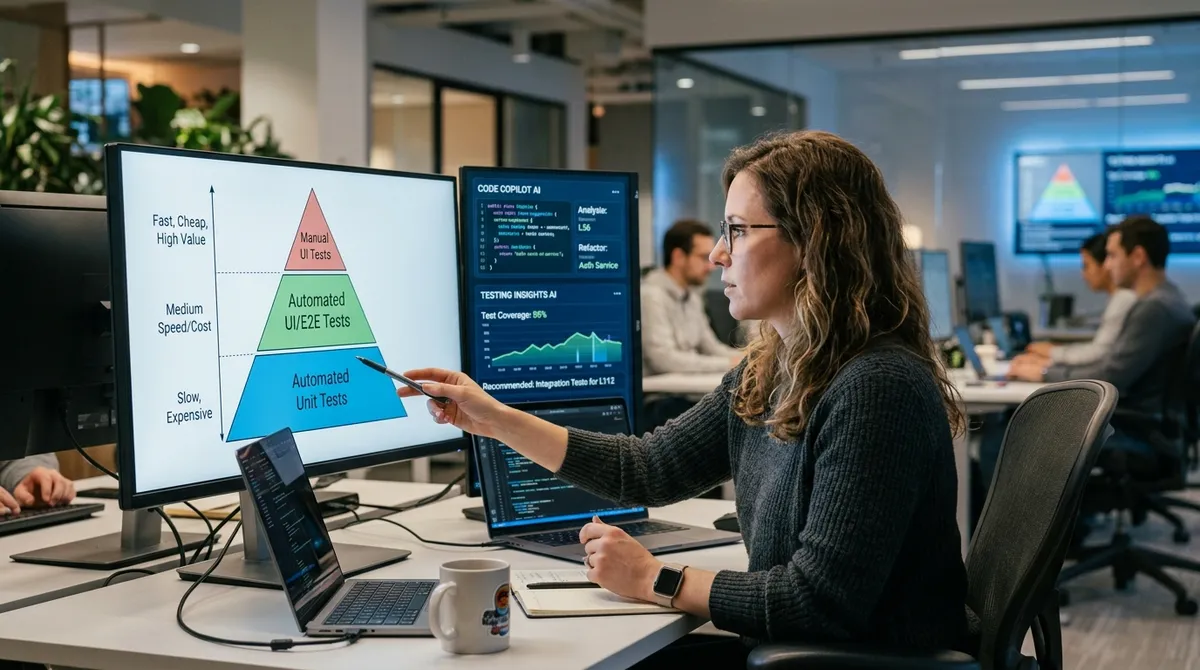
عندما يتحول النموذج اللغوي إلى مصمم اختبارات، تكتسب نظرية ضمان الجودة (QA) الكلاسيكية بُعداً جديداً على نحو غير متوقع. هذا هو موضوع المقال الثالث لميخائيل فيدوروف ضمن سلسلته عن نظام QA Assist، المنشور على موقع «خابر» (Habr). وفي هذا المقال يشرح المؤلف لماذا يصبح هرم الاختبار، الذي ابتُكر قبل عصر الشبكات العصبية بوقت طويل، عنصراً بالغ الأهمية لوكلاء الذكاء الاصطناعي ذوي نافذة السياق المحدودة.
QA Assist نظام يضم 11 وكيل ذكاء اصطناعي متخصصاً لأتمتة اختبار البرمجيات. وصف فيدوروف في المقال الأول من السلسلة البنية المعمارية للنظام: كيف تُوزَّع المسؤوليات بين الوكلاء، وكيف يتفاعلون، وما الذي يستطيعون القيام به. أما في المقال الثاني فعرض بصراحة واقع التطبيق العملي: مهمة تبدو على الورق عمل أربع ساعات، لكنها تتحول في البيئة المؤسسية إلى أسبوع كامل من الموافقات والاجتماعات مع فرق الأمن وتعديلات ملفات إعدادات البنية التحتية. ويرتقي المقال الثالث بمستوى النقاش إلى سؤال أعمق: كيف تُصاغ المهام للذكاء الاصطناعي بالشكل الصحيح للحصول على نتيجة عالية الجودة وقابلة لإعادة الإنتاج.
يُعد هرم الاختبار أحد المبادئ الأساسية في تطوير البرمجيات. في قاعدته توجد اختبارات الوحدة (unit tests) السريعة والرخيصة، التي تفحص الدوال والطرائق بمعزل عن غيرها. وفي الوسط توجد اختبارات التكامل التي تفحص تفاعل المكونات. وفي القمة توجد اختبارات end-to-end البطيئة والمكلفة، التي تحاكي سيناريو حقيقياً للمستخدم. والنسبة الكلاسيكية هي: اختبارات وحدة كثيرة، واختبارات تكامل أقل، وأدنى قدر ممكن من اختبارات E2E. وتوفر هذه البنية وقت تشغيل الاختبارات وتسهّل تصحيح الأخطاء: فعندما يفشل اختبار وحدة، يتضح فوراً ما الذي تعطّل بالضبط.
تظهر المشكلة حين يتولى نموذج لغوي تصميم الاختبارات بدلاً من المهندس. يعمل النموذج اللغوي الكبير (LLM) ضمن نافذة سياق، أي حجم ثابت من الرموز (tokens) يحتفظ به النموذج خلال جلسة توليد واحدة. وهذا لا يمثل مشكلة في المهام الصغيرة. لكن إذا طُلب من الشبكة العصبية كتابة مجموعة اختبارات كاملة لتطبيق كبير في طلب واحد، فالنتيجة متوقعة: إما أن يضيع جزء من منطق الأعمال خارج حدود السياق، أو يقدّم النموذج سيناريوهات سطحية دون التعمق في التبعيات الفعلية والحالات الحدّية.
وهنا بالتحديد يتوقف هرم الاختبار عن كونه نظرية من الكتب الدراسية ويصبح أداة عملية لتفكيك المهام. ويصف تشبيه المؤلف، أي إطعام الشبكة العصبية «الفيل» على قطع صغيرة، جوهر هذا النهج بدقة. فالمهمة الكبيرة تُقسَّم إلى طبقات وفق الهرم: يولّد الوكلاء أولاً اختبارات الوحدة على مستوى الدوال، ثم ينتقلون إلى سيناريوهات التكامل، ولا يصلون إلى E2E إلا في المرحلة الأخيرة. وتتسع كل طبقة داخل نافذة سياق النموذج وتُعالَج بمعزل عن غيرها، دون تراجع في الجودة بسبب امتلاء السياق.
يحقق هذا النهج عدة مزايا ملموسة. يصبح كل طلب إلى النموذج مركّزاً: يحصل الوكيل على نطاق واضح، وعقد محدد للمدخلات، ومخرج ملموس بعينه. وتبقى الأخطاء محصورة في موضعها: فإذا كُتب اختبار وحدة بشكل خاطئ، يظهر ذلك فوراً، وليس بعد عدة تكرارات يكون قد بُني فوقه فيها سيناريو تكامل. وأخيراً، يفرض الهرم ترتيباً طبيعياً للتبعيات: تُبنى اختبارات E2E فوق أساس جرى التحقق منه، لا بالتوازي معه.
لا يدّعي فيدوروف أنه اخترع العجلة. فالمؤلف نفسه يقر بأن ما يقدمه هو تطبيق لمبدأ هندسي معروف منذ زمن طويل على سياق جديد. لكن هذه هي الفكرة الرئيسية بعينها: الذكاء الاصطناعي لا يلغي المبادئ الأساسية للتطوير، بل يزيدها أهمية. فلم يعد فهم هرم الاختبار ضرورياً لمهندس ضمان الجودة وحده، بل أيضاً لمن يصمم بنية الطلبات الموجهة إلى النماذج اللغوية.
وبالنسبة إلى الفرق التي تدرس أدوات الذكاء الاصطناعي لأتمتة الاختبار، فهذا درس عملي: صمّم أولاً تفكيك المهمة، ثم أوكلها إلى النموذج. يُؤكل الفيل قطعة قطعة، وهذا ليس قيداً في التقنية، بل هو البنية المعمارية الوحيدة التي تعمل فعلاً.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.