كيف نقيس أداء وكيل الذكاء الاصطناعي في اختبار الجودة: قصة معيار قياسي واحد
بنى ميخائيل فيدوروف معيارًا قياسيًا موضوعيًا لنظام QA Assist، وهو منظومة من 11 وكيلًا من وكلاء الذكاء الاصطناعي تؤتمت عملية الاختبار. وبدلًا من التقييم الذاتي لعمل الوكيل، بات بالإمكان المقارنة بإنصاف بين الإصدارات وبين التحسينات المنفردة وتجارب النماذج اللغوية الكبيرة (LLM) المختلفة. وقد نُشر المشروع بالكامل، ومعه مخرجات خط المعالجة (pipeline)، في متناول الجميع.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News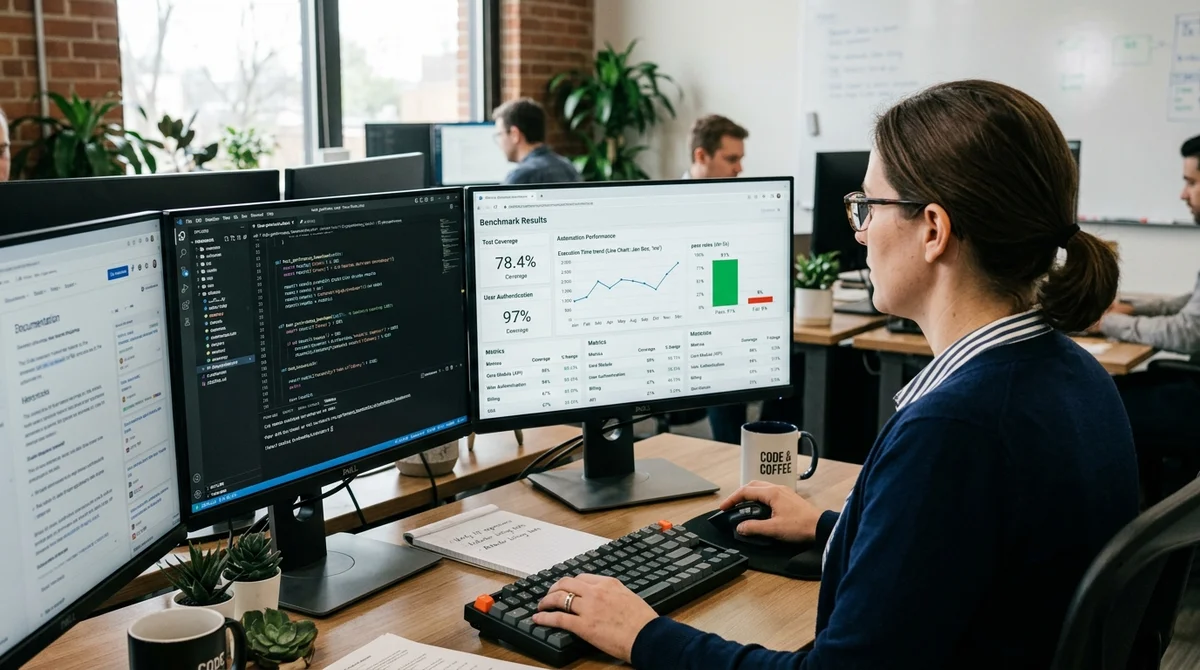
عندما يعمل وكيل ذكاء اصطناعي على مهام الاختبار، يصبح السؤال الأهم مؤلمًا: هل هو أفضل فعلًا مما كان عليه بالأمس؟ لا يمكن الإجابة عن هذا السؤال بسهولة، فالأمر يتطلب أرقامًا. وقد واجه ميخائيل فيدوروف، مطوّر QA Assist، هذه المشكلة وجهًا لوجه.
QA Assist نظام يضم 11 وكيلًا من وكلاء الذكاء الاصطناعي، تغطي معًا دورة الاختبار كاملة: من تفكيك المتطلبات إلى إنتاج الاختبارات الآلية الجاهزة. لكن كيف يمكن تقييم ما إذا تحسّن النظام بعد كل تحديث؟ الاعتماد على الانطباع الشخصي غير موثوق.
لماذا لا يصلح التقييم بالانطباع الشخصي
قد يكون التقييم الذاتي مضللًا في أي اتجاه: وجد الوكيل بالأمس 5 أخطاء، واليوم وجد 7، لكن هل يمكنكم التأكد من أن النظام هو الذي تحسّن فعلًا، لا أن مجموعة الاختبار هي التي تغيّرت؟ إصدارات مختلفة من النموذج، وموجّهات (prompts) مختلفة، وقيم مختلفة لمعامل الحرارة (temperature) في النموذج اللغوي الكبير، وكل ذلك يؤثر في النتيجة. وبدون معيار قياسي منهجي يصعب تحديد ما الذي يساعد فعلًا.
وقد عالج فيدوروف المشكلة بشكل جذري: فبنى مشروعًا مستقلًا للمعيار القياسي، يعمل فيه الوكيل وفق قواعد متطابقة، وعلى متطلبات متطابقة، ومع حالات حدّية متطابقة.
ما الذي يستطيع المعيار القياسي فعله
- مقارنة إصدارات مختلفة من الوكيل على مجموعة البيانات نفسها
- اختبار تأثير التحسينات المنفردة في خط المعالجة (prompt-engineering، والتغييرات في منطق التفكيك)
- تجربة نماذج مختلفة: GPT-5.5 مقابل Claude ونماذج أخرى
- تتبّع التقدم عبر الزمن مع عرض مرئي للتحسينات
- توليد تقرير كامل بنسبة الأخطاء المكتشفة، والأخطاء الفائتة، والإنذارات الكاذبة
من المهم التنبيه: المعيار القياسي لا يعني «مجموعة اختبار مثالية». إنه يعني مجموعة اختبار خاضعة للتحكم، تكون فيها المتغيرات أقل ما يمكن، ويمكن إعادة إنتاج كل تشغيل منها.
المخرجات في تشغيل واحد
في كل تشغيل، يعدّ الوكيل حزمة كاملة: المتطلبات المستخرجة وتفكيكها، وسيناريوهات الاختبار مع خطواتها، وشيفرة الاختبارات الآلية الجاهزة، وتقريرًا عن التغطية والحالات الفائتة، وسجلًّا بالقرارات المقبولة والمرفوضة. وتُحفظ جميع هذه المخرجات في مستودع عام، ما يتيح الاطلاع على طريقة استدلال الوكيل في أمثلة مختلفة.
وهذا مفيد لا لتتبّع التقدم فحسب، بل لتصحيح الأخطاء أيضًا: فعندما يخطئ الوكيل، يتضح في أي خطوة من خط المعالجة وقع الخطأ ولماذا.
ماذا يعني ذلك
بالنسبة لمطوّري أدوات اختبار الجودة، أصبحت المعايير القياسية أمرًا لا غنى عنه، فهي السبيل الوحيد إلى الصدق مع النفس بشأن جودة العمل. ويُظهر الوصول المفتوح إلى مشروع فيدوروف أن هذه الشفافية ممكنة. وباتت الفرق الأخرى التي تعمل مع وكلاء الذكاء الاصطناعي في الاختبار تعرف ما ينبغي فعله منذ البداية.
- 29 أكتوبر 2026Anthropic تكشف في نموذج S-1: 11 900 عميل يدفعون 100 ألف دولار سنويًا فأكثر
- 28 أكتوبر 2026شبكة CNN من عام 2015 تتفوق على GPT-6 Astra وClaude Fable 5.1 في تشخيص سرطان الجلد
- 28 أكتوبر 2026Keystone تُخرج اسم النموذج من الشيفرة: بوابة LLM مفتوحة المصدر تضيف 0.64 مللي ثانية فقط
- 28 أكتوبر 2026Wired تختبر 6 وكلاء ذكاء اصطناعي خلال يوم: Dots في الصدارة وGemini Spark يفشل في طلب الغداء
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا لا يصلح التقييم بالانطباع الشخصي؟
قد يكون التقييم الذاتي مضللًا في أي اتجاه: وجد الوكيل بالأمس 5 أخطاء، واليوم وجد 7، لكن هل يمكنكم التأكد من أن النظام هو الذي تحسّن فعلًا، لا أن مجموعة الاختبار هي التي تغيّرت؟ إصدارات مختلفة من النموذج، وموجّهات (prompts) مختلفة، وقيم مختلفة لمعامل الحرارة (temperature) في النموذج اللغوي الكبير، وكل ذلك يؤثر في النتيجة. وبدون معيار قياسي منهجي يصعب تحديد ما الذي يساعد فعلًا. وقد عالج فيدوروف المشكلة بشكل جذري: فبنى مشروعًا مستقلًا للمعيار القياسي، يعمل فيه الوكيل وفق قواعد متطابقة، وعلى متطلبات متطابقة، ومع حالات حدّية متطابقة.
ما أبرز التفاصيل حول ما الذي يستطيع المعيار القياسي فعله؟
مقارنة إصدارات مختلفة من الوكيل على مجموعة البيانات نفسها اختبار تأثير التحسينات المنفردة في خط المعالجة (prompt-engineering، والتغييرات في منطق التفكيك) تجربة نماذج مختلفة: GPT-5.5 مقابل Claude ونماذج أخرى تتبّع التقدم عبر الزمن مع عرض مرئي للتحسينات توليد تقرير كامل بنسبة الأخطاء المكتشفة، والأخطاء الفائتة، والإنذارات الكاذبة من المهم التنبيه: المعيار القياسي لا يعني «مجموعة اختبار مثالية». إنه يعني مجموعة اختبار خاضعة للتحكم، تكون فيها المتغيرات أقل ما يمكن، ويمكن إعادة إنتاج كل تشغيل منها.
ما أبرز التفاصيل حول المخرجات في تشغيل واحد؟
في كل تشغيل، يعدّ الوكيل حزمة كاملة: المتطلبات المستخرجة وتفكيكها، وسيناريوهات الاختبار مع خطواتها، وشيفرة الاختبارات الآلية الجاهزة، وتقريرًا عن التغطية والحالات الفائتة، وسجلًّا بالقرارات المقبولة والمرفوضة. وتُحفظ جميع هذه المخرجات في مستودع عام، ما يتيح الاطلاع على طريقة استدلال الوكيل في أمثلة مختلفة. وهذا مفيد لا لتتبّع التقدم فحسب، بل لتصحيح الأخطاء أيضًا: فعندما يخطئ الوكيل، يتضح في أي خطوة من خط المعالجة وقع الخطأ ولماذا.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.