هلوسات الذكاء الاصطناعي في كتابة الشيفرة: لماذا تتفوق أداة البحث والاستبدال على الوكلاء
وصف مطوّر على موقع Habr مفارقة لافتة: وكيل CLI يعمل بنموذج Qwen Code أمضى ساعتين في مهمة تنجزها أداة IDE في 20 دقيقة. وأثناء بحثه عن أسباب الهلوسات، اكتشف أنه كلما كان الأمر (prompt) أكثر تفصيلًا و«ذكاءً»، زادت أخطاء النموذج. يشرح المقال آلية حدوث ذلك، ويقدّم خلاصات عملية لمن يبني خطوط عمل (pipelines) قائمة على الذكاء الاصطناعي.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News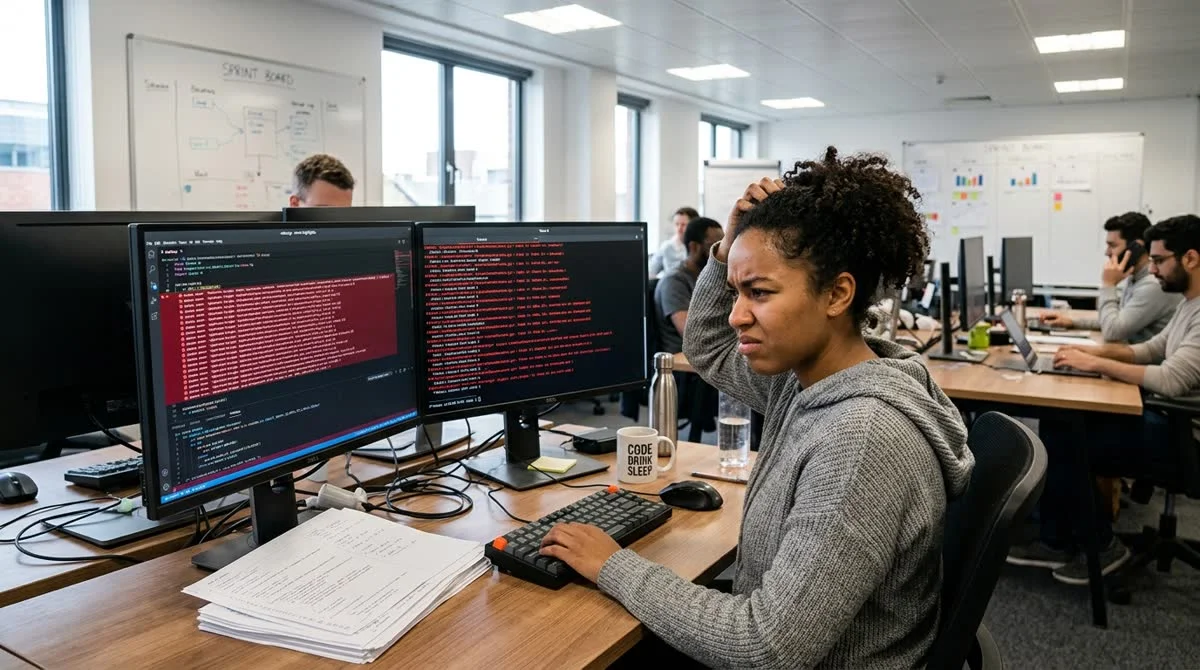
أمضى وكيل CLI يعمل بنموذج Qwen Code ساعتين في مهمة كانت أداة «البحث والاستبدال» في IDE ستنجزها خلال 20 دقيقة، بسبب هلوسات متواصلة وإضافات غير ضرورية.
حين يتفوق البحث والاستبدال البسيط على الوكيل
بدت المهمة بسيطة: إجراء تعديلات متشابهة في قاعدة الشيفرة باستخدام وكيل CLI. كان من المفترض أن ينجزها Qwen Code بسرعة، وهو نموذج متخصص في البرمجة أتيح للمطوّر في بيئة عمله بدلًا من Claude الذي يفضّله. لكن الوكيل عمل نحو ساعتين: أضاف تراكيب غير ضرورية، وفقد سياق المهمة، واحتاج إلى تصحيح يدوي مستمر.
واصل المؤلف محاولات توجيه النموذج «من باب التحدي الرياضي» فحسب، وهذه التجربة تحديدًا هي التي دفعته أخيرًا إلى فهم طبيعة الهلوسات بدلًا من الاكتفاء بتغيير الأداة.
أبرز معطيات الحالة:
- المهمة: تعديلات متشابهة على الشيفرة عبر وكيل CLI
- الوقت المتوقع: 20 دقيقة بأداة يدوية
- الوقت الفعلي: نحو ساعتين مع الوكيل
- النموذج: Qwen Code
- الأعراض: هلوسات وإضافة عناصر زائدة غير مطلوبة
لماذا تفاقم الأوامر «الذكية» الهلوسات؟
المفارقة المحورية في المقال أن كتابة أوامر (prompts) أكثر تفصيلًا و«ذكاءً» لا تقلّل الهلوسات، بل كثيرًا ما تزيدها.
الحمل الزائد على السياق. يرفع الأمر الطويل، المليء بالشروط والاستثناءات، احتمال أن يفقد النموذج الخيط ويبدأ باستكمال المنطق من أوزانه الداخلية بدلًا من اتباع التعليمات.
تعارض القيود. قد تتناقض الشروط المفصّلة فيما بينها بصورة ضمنية. ولا يُرجع النموذج خطأً في هذه الحالة، بل يختار بين الشروط المتعارضة ويخطئ في الاختيار، فيولّد نتيجة تبدو مقنعة لكنها غير صحيحة.
الخروج عن نطاق التوزيع. تدرّبت النماذج المتخصصة في البرمجة على نوع معيّن من الطلبات. وتدفع الأوامر غير المعتادة أو المركّبة النموذج إلى منطقة لم يتعرض فيها لأمثلة كافية أثناء التدريب، وهناك تزداد الهلوسات بحدّة.
وهم الفهم. يمنح التوجيه المفصّل المطوّر إحساسًا بأن النموذج فهم المهمة. أما النموذج فيكتفي بتوليد الرمز (token) التالي استنادًا إلى أنماط مشابهة في بيانات التدريب.
ماذا يفعل المطوّر مع وكيل الذكاء الاصطناعي؟
تشير التجربة الموصوفة في المقال إلى عدة خلاصات عملية:
- جزّئ المهام: استدعاء واحد للوكيل لعملية واحدة محددة، لا لمجموعة خطوات مترابطة
- تحقق من المخرجات: يجب التحقق من نتيجة كل خطوة قبل تمريرها إلى المرحلة التالية في خط العمل
- بسّط ولا تعقّد: إذا هلوس النموذج، جرّب أمرًا أقصر وأكثر تحديدًا
- اختر الأداة المناسبة للمهمة: في التعديلات الميكانيكية المتشابهة، كثيرًا ما يكون grep أو سكربت أكثر موثوقية من الوكيل
«بعد هذه التجربة الرائعة فقط قررت أخيرًا أن أقرأ التعليمات»، يكتب المؤلف.
ماذا يعني ذلك
هلوسات LLM ليست علّة (bug) يمكن التغلب عليها بأمر أذكى. إنها خاصية بنيوية في النماذج ذاتية الانحدار (autoregressive)، وتشتد عند الخروج عن توزيع بيانات التدريب. وإدراك ذلك مرة واحدة يعني بناء خطوط عمل الذكاء الاصطناعي بما يراعي القيود الفعلية للأداة، لا بما يتجاهلها.
متى يكون وكيل الذكاء الاصطناعي للشيفرة أقل كفاءة من
Find & Replace؟ عندما يهلوس الوكيل ويولّد شيفرة خاطئة بدلًا من تطبيق التعديلات المتشابهة ببساطة. ففي مثال Qwen Code، استغرقت مهمة تنجزها أداة Find & Replace في 20 دقيقة ساعتين بسبب الإضافة المتواصلة لعناصر غير ضرورية.
لماذا يكون وكلاء الذكاء الاصطناعي أحيانًا أسوأ من الأدوات البسيطة؟
في مثال Qwen Code، أضاف الوكيل عناصر غير ضرورية وهلوس بدلًا من تنفيذ استبدال متشابه للشيفرة، وهي مهمة تنجزها IDE في 20 دقيقة.
Build & Ship Production AI Apps with Vibe Coding
Join Zhemal Khamidun's hands-on Vibe Coding Intensive at hamidun.com/vibecoding — master Claude Code, Cursor, and autonomous agentic workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.