Hugging Face تنشر Ecom-RLVE — بيئة تدريب لوكلاء الذكاء الاصطناعي في المتاجر الإلكترونية
أطلقت Hugging Face بيئة Ecom-RLVE لتدريب وكلاء الذكاء الاصطناعي الذين يساعدون في شراء السلع من المتاجر الإلكترونية. تضم البيئة ثمانية سيناريوهات، من البحث وتجميع السلة إلى المرتجعات وتتبع الطلبات، إضافة إلى مكافآت قابلة للتحقق تقيس الدقة والكفاءة وغياب الهلوسات. تشير الاختبارات الأولى إلى أن هذا النهج يكشف الإخفاقات الحقيقية بصورة أفضل من اختبارات الدردشة التقليدية.
معالج بواسطة الذكاء الاصطناعي من Hugging Face Blog؛ بتحرير Hamidun News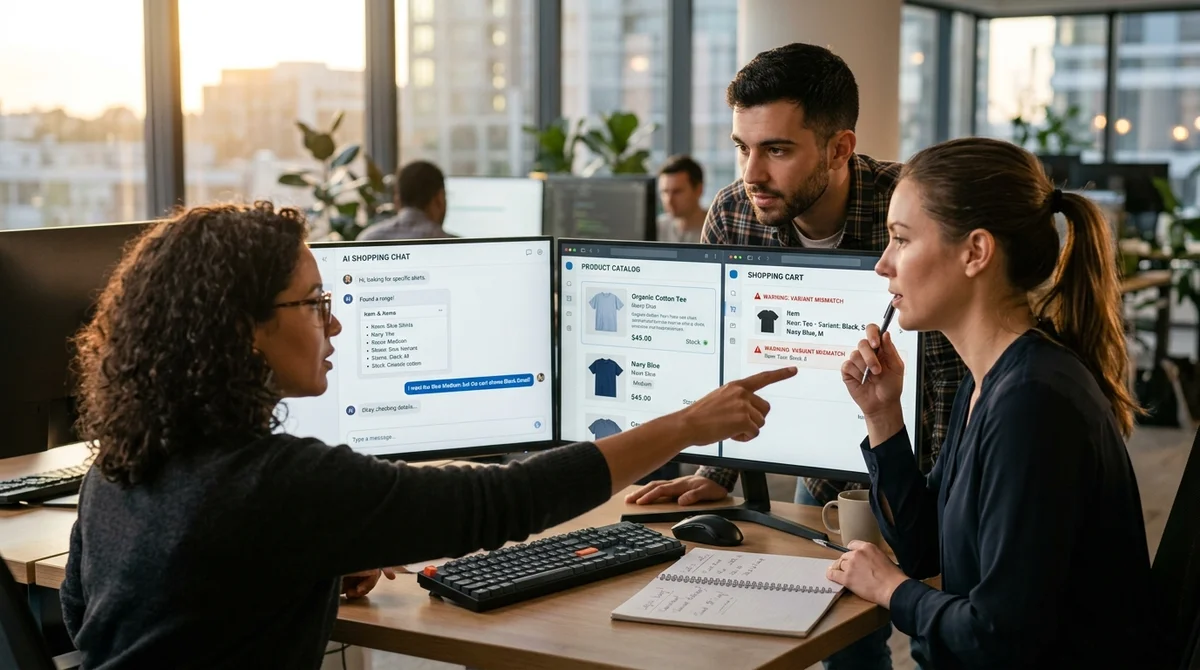
نشرت Hugging Face مشروع Ecom-RLVE، وهو مجموعة من البيئات القابلة للتحقق لتدريب وكلاء الذكاء الاصطناعي الحواريين الذين يساعدون في شراء السلع من المتاجر الإلكترونية. ينقل المشروع التعلم المعزز من عالم المهام المجردة إلى سيناريوهات واقعية متعددة الخطوات: البحث عن منتج، واختيار بديل، وتجميع السلة، والمرتجعات، وتتبع الطلب.
لماذا لا تكفي الاختبارات القديمة
تعلمت النماذج اللغوية الكبيرة منذ وقت طويل أن تبدو مقنعة في كلامها، لكن هذا لا يكفي في التجارة الإلكترونية. فقد لا يطلب المستخدم ببساطة «ابحث عن شاحن»، بل يريد طرازاً بسعر لا يتجاوز 25 دولاراً، بمنفذ USB-C، مع توصيل خلال يومين وتوافق مع جهاز بعينه. وهنا لا يكون المطلوب من الوكيل ردّاً في الدردشة، بل سلسلة إجراءات: العثور على بطاقة المنتج، والتحقق من القيود، واختيار النسخة المناسبة، وعدم الخلط في الكمية، وعدم اختلاق ما لا يوجد في الكتالوج.
«الطلاقة في الكلام لا تساوي إنجاز المهمة». على هذه الفجوة تحديداً يقوم
Ecom-RLVE.
يطوّر المؤلفون فكرة RLVE-Gym التي تدرّبت فيها النماذج على مهام قابلة للتحقق مع مكافأة دقيقة، وينقلونها إلى التجارة الحوارية. وبدلاً من التقييم الذاتي عبر إنسان أو عبر LLM-as-a-judge، تتحقق البيئة من النتيجة برمجياً: هل وصل الوكيل إلى المنتج الصحيح، وهل اختار المقاس أو النسخة الصحيحة، وهل أنشأ المرتجع للبند المطلوب، وهل التزم بحد الخطوات.
كيف تعمل البيئة
كل حلقة (episode) في Ecom-RLVE تتكوّن من مهمة مخفية ومستخدم محاكى ومجموعة أدوات يعمل بها الوكيل. فهو لا يكتب نصاً فحسب، بل يستدعي دوال، ويبحث في الكتالوج، ويضيف البنود إلى السلة، ويطرح أسئلة توضيحية، ولا ينهي السيناريو إلا عندما يتحقق الهدف فعلاً. وتقوم البيئة على ثمانية أنواع من المواقف: من product discovery وproduct substitution إلى bundle planning وpolicy QA وorder tracking وmulti-intent journey.
تتكوّن المكافأة من عدة مكونات، كي يتعلم النموذج ألا يكتفي بأن «يبدو مفيداً»، بل أن ينجز المهمة حتى نهايتها:
- مكافأة على التنفيذ الصحيح للمهمة
- مكافأة إضافية على قلة عدد الخطوات وتوفير استدعاءات الأدوات
- عقوبة على الهلوسات، مثل رموز SKU أو نسخ غير موجودة
- إخفاق صارم عند الإجراءات غير الصالحة أو مخالفة صيغة الاستدعاء
وتبرز أهمية خاصة للصعوبة التكيفية. فبدلاً من مستويات ثابتة (easy/medium/hard)، تعتمد البيئة رقم الصعوبة d الذي يتحكم في 12 محوراً دفعة واحدة، منها: عدد القيود، والتفاصيل المفقودة، والمنتجات المتشابهة، والأخطاء الإملائية، ونفاد المخزون، وتغيّر النية أثناء الحوار، وغيرها من العوائق. وهذا يتيح بناء curriculum learning دون وسم يدوي، ودون إبقاء النموذج طويلاً على مهام صارت بديهية.
أين ينهار النموذج
تتناول المقالة بالتفصيل سيناريو Cart Building، الذي يجب فيه على الوكيل تجميع سلة من عدة منتجات بنسخ وكميات دقيقة. ولمنع الحفظ عن ظهر قلب بحسب القوالب، يولّد المطورون النسخ أثناء التشغيل: في الإلكترونيات قد يكون نوع المنفذ، وفي الملابس المقاس، وفي أدوات المطبخ الخامة أو اللون. ولذلك لا يكفي أن «يتعرّف» النموذج على المنتج، بل عليه أن يربط طلب المستخدم فعلاً بالتعديل الصحيح داخل الكتالوج.
درّب الفريق على هذه البيئة نموذج Qwen 3 8B بطريقة DAPO على مدى 300 خطوة على المجموعة C1، بينما يتيح الاختبار نفسه أنماط C2 وC4 وC8 للتدريب على بيئتين وأربع وثماني بيئات. وجرى توسيع الكتالوج إلى مليوني منتج عبر فهرس FAISS ونماذج التضمين gte-modernbert-base، وبُني محاكي المستخدم على Qwen3.5-9.7B. وبحسب النتائج، تمكّن الوكيل من الارتقاء بثبات نحو حلقات أكثر تعقيداً، كما أصبحت الأخطاء نفسها واضحة للعيان: قد يختار النموذج المنتج الصحيح لكنه يخطئ في النسخة، أو ينسى أحد بنود الطلب، أو يعلن أن النسخة المطلوبة غير موجودة مع أنه رآها قبل بضع خطوات.
ماذا يعني ذلك
بالنسبة إلى سوق التسوق بالذكاء الاصطناعي، هذا تحول مهم: فالمنافسة لم تعد على مدى سلاسة حديث الروبوت، بل على مدى موثوقيته في إنجاز مهمة الشراء. وإذا ترسخت مثل هذه البيئات المفتوحة، فسيمتلك القطاع طريقة أكثر نزاهة لتدريب وكلاء التجارة الإلكترونية ومقارنتهم، بحسب جودة الأفعال الفعلية لا بحسب الانطباع الذي يتركه الحوار.
Delegate Deep Research, Coding & Workflows to an AI Agent
Deploy autonomous multi-step execution with NomadNet Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and complex task orchestration.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.