النماذج العالمية: كيف يتعلم الذكاء الاصطناعي فهم الواقع بدلاً من النص
نظّمت MIT نقاشاً حول النماذج العالمية، وهي اتجاه جديد في الذكاء الاصطناعي. تعمل الشركات على تطوير أنظمة ترى العالم المادي وتفهمه كما يفعل البشر. وتمثّل هذه المحاولة سعياً لتجاوز القيد الرئيسي الذي تعاني منه نماذج اللغة الكبيرة الحالية.
معالج بواسطة الذكاء الاصطناعي من MIT Technology Review؛ بتحرير Hamidun News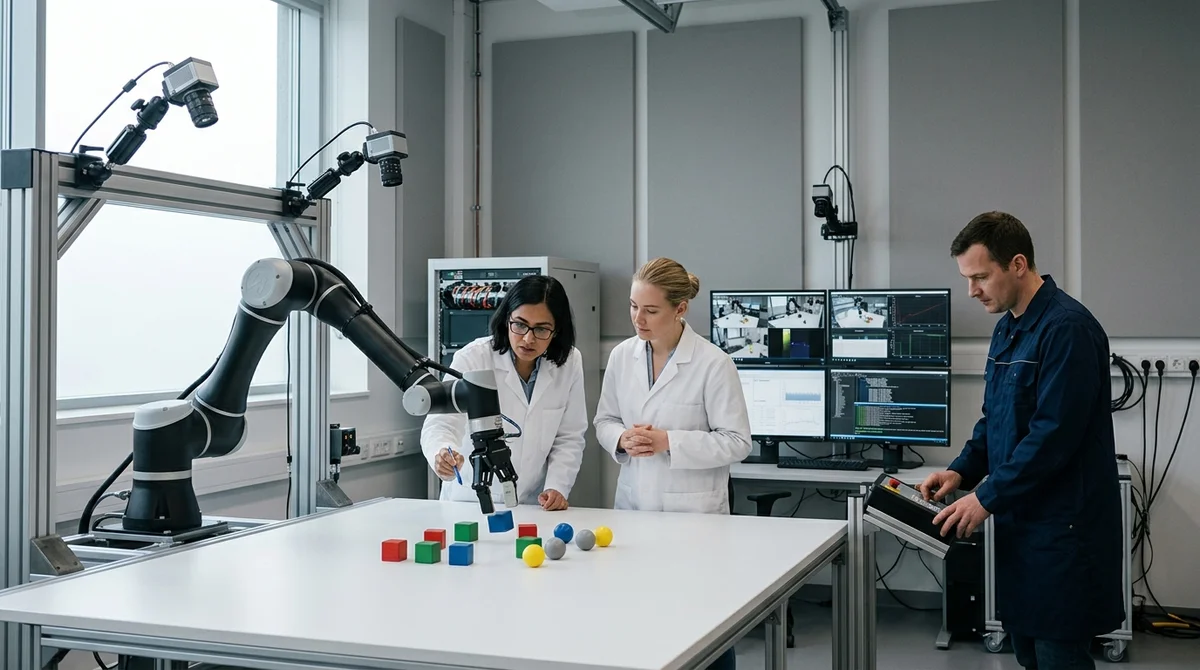
ناقش مؤتمر MIT Technology Review الذي عُقد في مايو النماذج العالمية (world models)، وهي ما قد يشكّل القفزة الكبرى التالية في تطوّر الذكاء الاصطناعي. وتناول رئيس التحرير مات هونان وكبير محرري الذكاء الاصطناعي ويل دوغلاس هيفن كيف تحاول الشركات تعليم الشبكات العصبية ليس معالجة النص فحسب، بل فهم الواقع المحيط فهماً حقيقياً.
ما هي النماذج العالمية
النموذج العالمي ليس مجرد إصدار جديد من LLM. إنه نظام مختلف جذرياً، يستطيع مشاهدة الفيديو وتحليل الصور والتفاعل مع البيئة المحيطة والتنبؤ بعواقب الأفعال. وهو يشبه الإنسان الذي يرى مكعباً على حافة طاولة ويدرك أنه سيسقط. على الشبكة العصبية أن تكتسب هذا الفهم دون تعليمات صريحة، بل بتعلّمه من مراقبة العالم المادي.
تغيّر هذه النماذج نموذج التدريب نفسه. فبدلاً من المخطط الكلاسيكي «هذا نص، أجب عن السؤال»، يظهر مخطط جديد: «شاهد الفيديو وتنبّأ بما سيحدث بعد ذلك». ويتطلب ذلك بنية مختلفة تماماً ومجموعة بيانات مختلفة وطريقة مختلفة لتقييم أخطاء النموذج.
لماذا لا يكفي النص بوضوح
نماذج اللغة الكبيرة الحالية بارعة في معالجة المعلومات، لكنها عمياء بالمعنى الحرفي للكلمة. فهي تعرف شيئاً عن الجاذبية لمجرد أن الناس كتبوا عنها ملايين المرات على الإنترنت. لكنها لم ترَ يوماً جسماً يسقط، ولم تشعر بالقصور الذاتي، ولم تجرِ تجارب في الفيزياء. وينتج عن ذلك نقاط عمياء محددة:
- لا تستطيع التنبؤ بالتفاعلات الفيزيائية انطلاقاً من المبادئ الأولى
- تخلط في العلاقات المكانية بين الأجسام في الفيديو
- لا تستطيع فهم العلاقات السببية في تسلسل الإطارات
- لا تقدر على تخطيط الأفعال بالاستناد إلى الفيزياء الحقيقية
- تخطئ في التنبؤ بالمسارات والتصادمات
ويبرز هذا القيد بوضوح خاص حين يحاول الذكاء الاصطناعي التحكم في روبوت، أو تخطيط عمليات لوجستية، أو التنبؤ بنتائج التعامل مع الأشياء في الواقع.
من يعمل على النماذج العالمية
تستثمر OpenAI وDeepMind وTesla وشركات كبرى أخرى موارد كبيرة في تطوير النماذج العالمية، وتتنوع المقاربات. تعمل OpenAI وDeepMind على مجموعات بيانات فيديو من YouTube وعلى محاكاة اصطناعية. أما Tesla فتستخدم ملايين الساعات من فيديو كاميرات سياراتها لتعليم النظام رؤية العالم كما يراه البشر على الطريق.
وتبدأ بعض الشركات بالتعلّم الخاضع للإشراف (supervised learning) على فيديو موسوم. وتستخدم شركات أخرى التعلّم المعزَّز (reinforcement learning) في محاكاة خاضعة للتحكم، حيث يمكن للنموذج أن يخطئ مليون مرة دون عواقب حقيقية، فيحسّن فهمه تدريجياً.
ماذا يعني ذلك
إذا نجحت الشركات في توسيع نطاق النماذج العالمية بالنجاح نفسه الذي وسّعت به LLM، فسينتقل الذكاء الاصطناعي إلى مستوى جديد: من المعالجة الرمزية للمعلومات إلى ما هو أقرب إلى فهم حقيقي للواقع المادي. ستخرج الروبوتات من المختبرات، وستصبح الأنظمة المستقلة أكثر موثوقية، وسيتسارع تخطيط العمليات المعقدة.
لكن الطريق ما زال في بدايته. وتلفت MIT Technology Review الانتباه إلى ذلك لأن النماذج العالمية هي على الأرجح أهم اتجاه في الذكاء الاصطناعي خلال السنوات القليلة المقبلة. وستحصل الشركات التي تنجح أولاً في تعليم الشبكات العصبية رؤية العالم وفهمه على ميزة تنافسية هائلة.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.