#LLM
Подборка материалов по теме «LLM»: релизы, исследования, бенчмарки, опенсорс.

Свой сервер для нейросетей: хватит мучить домашний ноутбук и слушать коучей
Перестаньте верить в сказки о мощных нейросетях на старых лэптопах. Разбираемся, как собрать железный фундамент для своего ИИ, который действительно работает.
OpenAI против вашей занятости: три новости, которые меняют всё
OpenAI штормит, но релизы выходят по расписанию. Три обновления могут превратить ваш ИИ в врача, коллегу или вовсе заменить вас на рабочем месте. Разбираемся, стоит…
Tesla Optimus Gen 3: миллион железных рабочих и конец эры ручного труда
Илон Маск готовит армию гуманоидов. Третье поколение Optimus учится, просто глядя на нас, и готовится к массовому десанту на заводы.

Grok хочет «Оскар»: зачем Илону Маску лучшие писатели планеты

Oracle идет ва-банк: $50 миллиардов ради облаков для ИИ
Увольнения или «AI-washing»: как корпорации прячут кризис за нейросетями
Deep Intelligent Pharma: «бионический мозг» вместо армии лаборантов

Kimi K2.5: Китайский «умник» обставил OpenAI и пошёл за долларами
Стартап Moonshot AI выпустил K2.5. Модель уже в топе OpenRouter, а зарубежная выручка компании впервые превысила домашнюю. Похоже, 300 человек могут победить тысячи.

NVIDIA ставит всё на OpenAI, пока инженеры Apple бегут к конкурентам
Дженсен Хуанг готовит крупнейшую сделку в истории, Apple раздает кадры Meta и Google, а Илон Маск хочет построить дата-центры в космосе. Главное из мира…
Qianxun AI: китайские алгоритмы забирают работу у HR-департаментов
Битва за юани: китайские техногиганты сжигают миллиарды ради ИИ-трафика
Китайский маржин-колл: почему ИИ-пузырь в Поднебесной начал сдуваться

Qwen App: Alibaba сжигает 30 миллиардов на новогоднее наступление
Grok в Индонезии: Илон Маск учится договариваться с цензурой
Индонезия открывает двери для Grok. Почему бунтарскому ИИ Маска пришлось пойти на условия властей и как это изменит расклад сил в Юго-Восточной Азии. Без цензуры не…
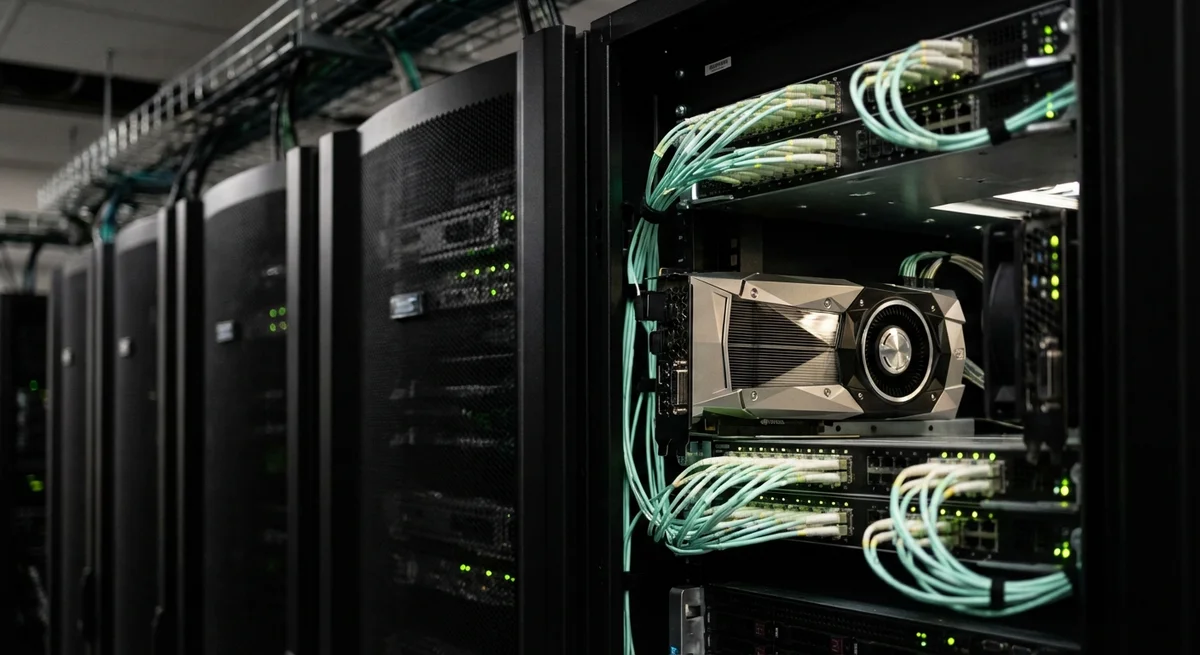
NVIDIA QAD: как сжать модель в 4 бита и не потерять мозги
Новый метод QAD от NVIDIA решает проблему деградации LLM при квантовании. Теперь 4-битные модели сохраняют точность в математике и коде, работая на обычном железе.