#Железо
Подборка материалов по теме «Железо»: релизы, исследования, бенчмарки, опенсорс.
Nvidia выпустила Nemotron 3 Nano Omni — открытую мультимодальную модель для edge-агентов
Nvidia представила Nemotron 3 Nano Omni — открытую мультимодальную модель с 30 млрд параметров и 3 млрд активных на инференсе, рассчитанную на автономных AI-агентов…
OpenAI не дотянула до внутренних целей роста, и рынок списал десятки миллиардов
После сообщения о том, что OpenAI не выполнила внутренние цели по выручке и росту ChatGPT, инвесторы резко продавали акции партнёров компании — от Oracle до…
NVIDIA вывела Nemotron 3 Nano Omni в Amazon SageMaker JumpStart в день релиза
NVIDIA добавила Nemotron 3 Nano Omni в Amazon SageMaker JumpStart в день релиза, чтобы компании могли быстрее запускать мультимодальные AI-сценарии для текста…
OpenAI, MiniMax и Nvidia задали тон марту в ИИ: Sora, GPT-5.4 и ставка на Миру Мурати
Глава Anthropic Дарио Амодей обещает «хороший ИИ», но критики требуют замедлить гонку
Как TGS и AWS сократили обучение сейсмической ИИ-модели с полугода до пяти дней
OpenAI купила техношоу TBPN, чтобы сильнее влиять на публичный разговор об ИИ
Google Gemma 4, NVIDIA и OpenClaw: локальные AI-агенты без оплаты за каждый токен
Google и NVIDIA продвигают локальный запуск Gemma 4 на RTX, Jetson и DGX Spark, чтобы всегда активные AI-агенты вроде OpenClaw работали быстрее, дешевле и без…
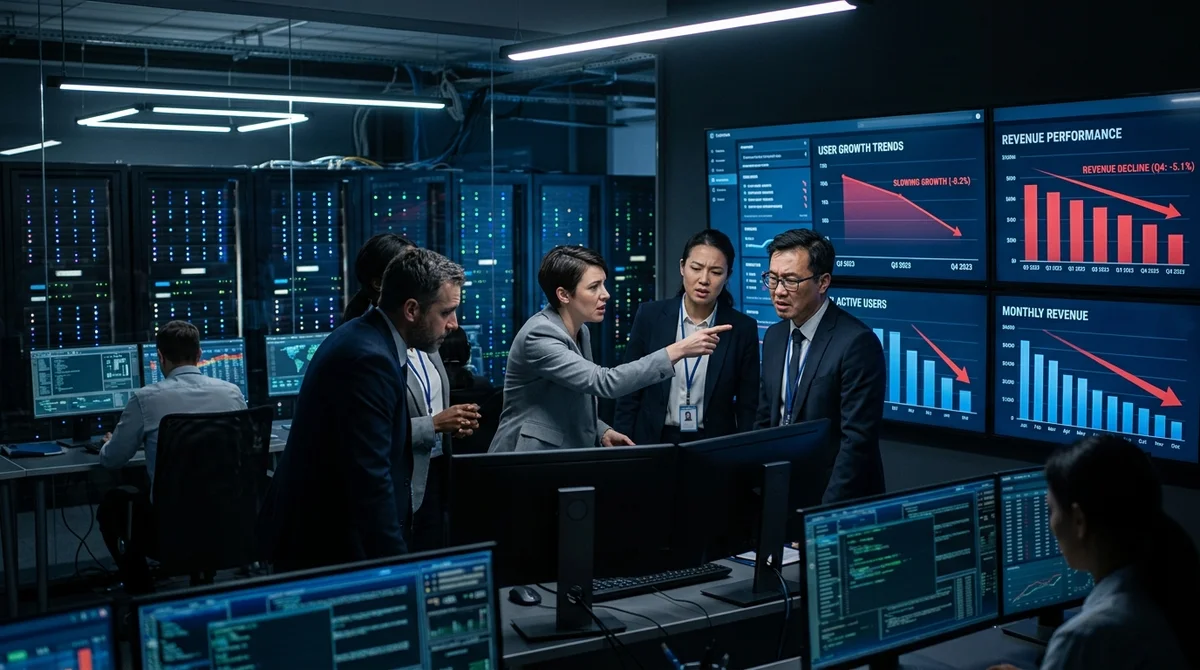
OpenAI замедляет рост выручки и новых пользователей на фоне дорогой ИИ-инфраструктуры
OpenAI сталкивается с ростом затрат на вычисления, более слабой выручкой и замедлением притока пользователей, пока часть аудитории уходит к альтернативным…
OpenAI покупает техшоу TBPN: это первая медийная сделка компании в истории
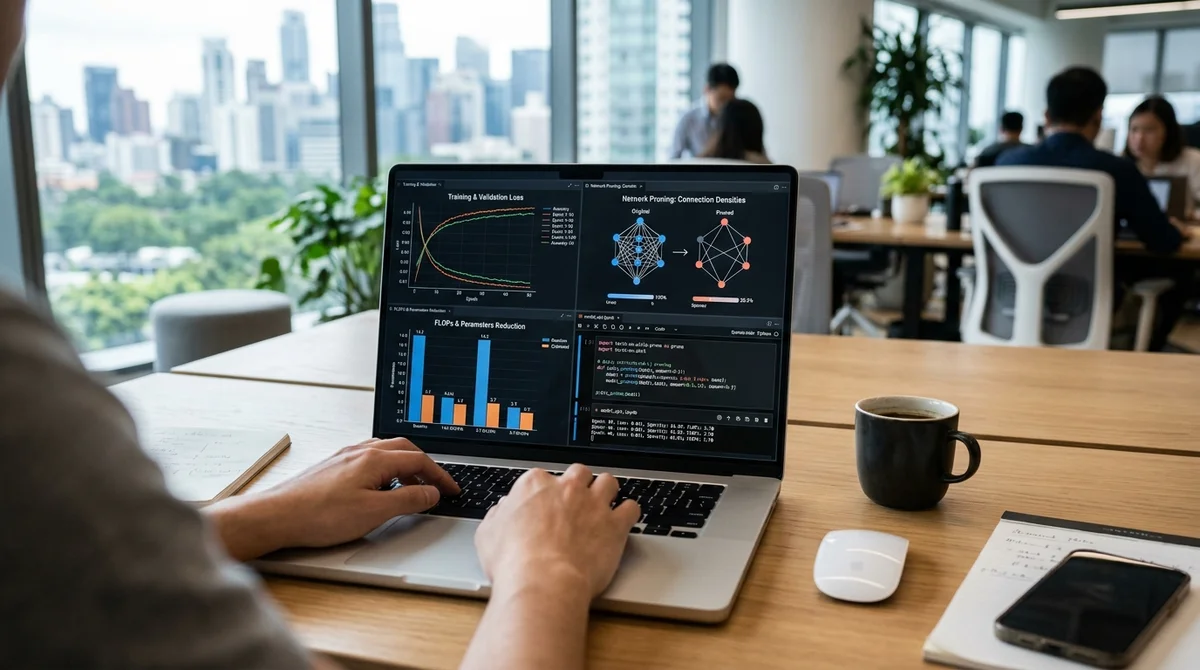
NVIDIA показала полный пайплайн оптимизации модели с FastNAS pruning и fine-tuning
Qwen и llama.cpp: как запустить локальную нейросеть без облака на компьютере или сервере
Directum: почему бизнес активно обсуждает ИИ-агентов, но не спешит внедрять их в процессы
PHP и RubixML переходят от массивов к GPU: как в экосистеме меняется подход к ML
PHP-сообщество всё активнее выносит машинное обучение из массивов и циклов в нативные структуры, расширения и GPU, превращая язык из вычислителя в оркестратор…
Nvidia вложила $2 млрд в Marvell и превратила партнерство в инфраструктурный сбор
Nvidia вложила $2 млрд в Marvell и встроила её в NVLink Fusion, чтобы зарабатывать на кастомных AI-чипах гиперскейлеров даже тогда, когда те уходят от готовых GPU.