NVIDIA Developer Blog
Источник AI-новостей. Материалы автоматически отбираются и адаптируются редакцией Hamidun News.
Последние публикации
NVIDIA DAQIRI: реальный ИИ-инференс при высокоскоростном сборе данных
NVIDIA представила DAQIRI — фреймворк, который встраивает ИИ прямо в поток данных с датчиков и научных приборов без задержек.
NVIDIA представила Halos — систему функциональной безопасности для роботов с AI
NVIDIA Halos — это полный стек функциональной безопасности для физического AI: роботов, которые работают рядом с людьми на заводах, складах и в больницах.
NVIDIA рассказала, как обучать трансформеры с пониженной точностью без потери качества
NVIDIA опубликовала руководство по оптимизации трансформерных моделей через FP8 и BF16 — как ускорить обучение и сократить расход GPU-памяти без потери точности.
NVIDIA объяснила, как управлять автономными агентами в корпоративных AI-фабриках
AI-агенты вышли далеко за рамки чата — они часами работают с корпоративными данными и системами, и NVIDIA подробно объяснила, как выстроить безопасное и управляемое окружение для их развёртывания.
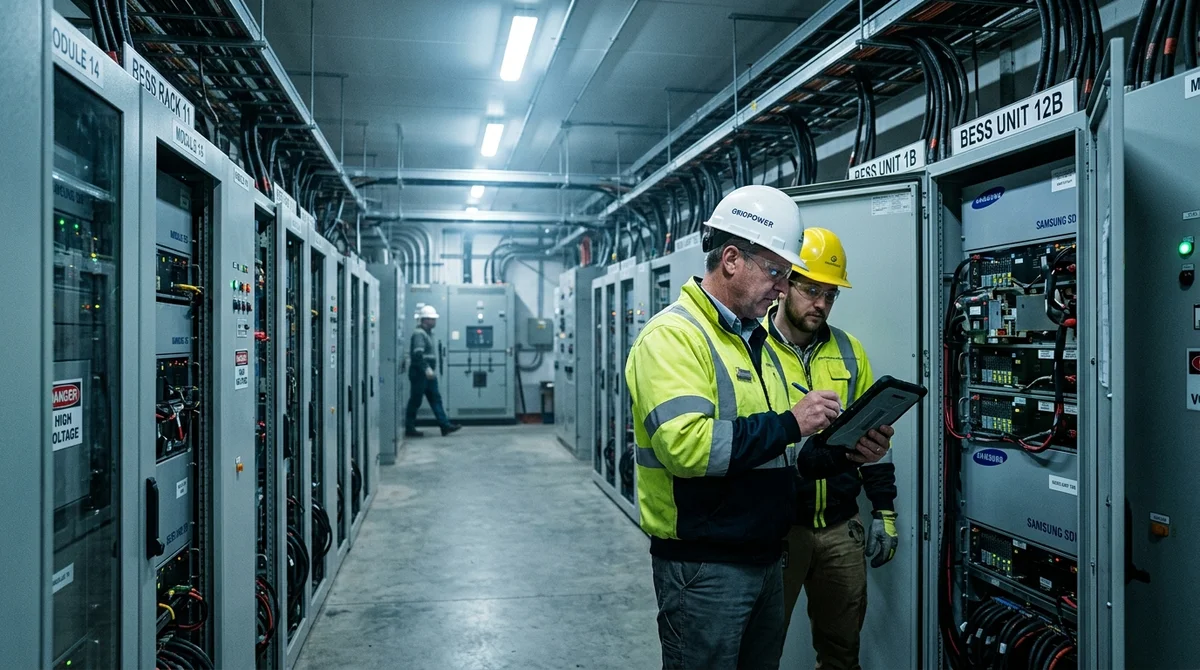
NVIDIA: как проектировать аккумуляторные системы хранения энергии для AI-фабрик
NVIDIA объяснила, чем AI-фабрики отличаются от обычных дата-центров по части энергопотребления, и описала требования к аккумуляторным системам BESS для таких объектов.
NVIDIA TensorRT превращает FP8-чекпоинты в движки для быстрого инференса
NVIDIA объяснила, как конвертировать FP8-квантизованный чекпоинт в TensorRT-движок — шаг, который превращает оптимизированную модель в реальный продакшн-инструмент.
NVIDIA JetPack 7.2: AI-агенты на граничных устройствах с одной командой деплоя
NVIDIA выпустила JetPack 7.2 для платформы Jetson — одна команда CLI разворачивает полный агентный стек с приватностью и оптимизацией памяти.
NVIDIA ускоряет предобучение LLM: NVFP4 на Blackwell в связке с JAX и MaxText
NVIDIA показала, как формат NVFP4 на чипах Blackwell в паре с JAX и MaxText сокращает время предобучения frontier-моделей и вычислительные расходы.
NVIDIA BioNeMo позволяет дообучать биологические AI-модели методом LoRA за часы
NVIDIA выпустила BioNeMo Recipes — готовые пайплайны для дообучения языковых моделей ESM2 и Evo 2 методом LoRA. Теперь специализировать их под биологические задачи можно на паре GPU.
Нейросети на 15 раз быстрее: оптимизация инференса от NVIDIA
NVIDIA опубликовала технику DFlash Speculative Decoding для архитектуры Blackwell: скорость инференса языковых моделей выросла в 15 раз при той же точности.
NVIDIA объясняет разницу между VLA и WAM — двумя подходами к управлению роботами
NVIDIA разграничивает VLA и WAM — два класса роботных моделей: первые учатся на языке, вторые — на предсказании физики мира. Разница определит архитектуру физического AI.
ИИ-агенты для бизнеса: результаты теста
Artificial Analysis выпустила AA-AgentPerf — первый открытый многовендорный стандарт для оценки агентного кодирования. NVIDIA заняла лидирующую позицию по ключевым метрикам.
DiffusionGemma: нейросеть для быстрой генерации текста
Google DeepMind оптимизировала новую модель DiffusionGemma для NVIDIA платформ, чтобы ускорить real-time генерацию текста в чатах, копилотах и агентах.
NVIDIA MCG Toolkit автоматизирует документацию AI-моделей под новые регуляции
NVIDIA представляет инструмент для автоматизации документации AI-моделей, который помогает командам соответствовать требованиям регуляторов вроде EU AI Act и создавать проверяемые model cards без ручного труда.
NVIDIA представила DynoSim для оптимизации параметров LLM serving
NVIDIA представила DynoSim — инструмент для автоматической оптимизации конфигурации обслуживания больших языковых моделей через симуляцию Pareto frontier.
NVIDIA RTX представила DLSS 4.5 и многоязычных AI-персонажей для игр
NVIDIA представила обновление RTX с поддержкой многоязычных AI-персонажей через ACE и новый DLSS 4.5 для Unreal Engine, упрощая разработку игр с ИИ.
Новый CompileIQ NVIDIA находит скрытый потенциал GPU-ядер через подбор параметров компилятора
NVIDIA представила CompileIQ — инструмент с AI, который автоматически подбирает оптимальные параметры компилятора для максимальной производительности GPU-ядер, находя ускорения там, где ручная оптимизация уже исчерпана.
NVIDIA Blackwell установила рекорд STAC-AI в финансовом AI-трейдинге
Архитектура NVIDIA Blackwell показала лучшую производительность в тесте STAC-AI для финансового AI, обработав больший объём данных быстрее всех конкурентов.
NVIDIA Dynamo Snapshot: ускорение запуска моделей на Kubernetes
NVIDIA представила инструмент для сокращения времени загрузки моделей вывода на Kubernetes с минут до секунд — решение для избежания потерь GPU при скачках трафика.
Нейросеть Step 3.7 Flash для видео, текста и картинок
StepFun запустила Step 3.7 Flash — мультимодальную AI-модель на 198 млрд параметров, которая одновременно работает с текстом, изображениями, видео и документами на NVIDIA-ускорителях.
NVIDIA RTX PRO 4500 Blackwell: ускорение геномики и моделирования белков
NVIDIA выпустила видеокарту RTX PRO 4500 Blackwell для ускорения геномных вычислений и моделирования белков — ключевых компонентов точной медицины.
NVIDIA CUDA 13.3 упрощает разработку на GPU с Tile programming в C++
NVIDIA выпустила CUDA 13.3 с Tile programming в C++, который автоматизирует оптимизацию низкоуровневых операций с памятью GPU для разработчиков.
NVIDIA добавила CUDA Tile для оптимизации GPU-ядер на C++
NVIDIA представила встроенную в C++ технологию CUDA Tile для разработки высокопроизводительных GPU-ядер на основе тайл-ориентированного подхода.
Внедрение ИИ в компании: как запустить собственное облачное решение
Телеком-компании строят суверенные AI-инфраструктуры на архитектуре NVIDIA Cloud Partner, используя token-metering для контролируемого доступа — подход к масштабируемым, высокомаржинальным сервисам для правительств и пре
Оптимизация ИИ-вычислений: как масштабировать инфраструктуру на NVIDIA
NVIDIA показала, как максимизировать производительность GB200 NVL72 через Slurm с учётом топологии сети — результаты демонстрируют экзасфальные вычисления на одной стойке.
Оптимизация ИИ-проектов: мониторинг GPU в Kubernetes (NVIDIA)
Большинство команд недоиспользуют GPU в Kubernetes-кластерах, потому что просто не видят, кто ими пользуется, сколько памяти занято и зависают ли контейнеры.
ИИ для финансов: как многоагентные системы находят торговые сигналы
Многоагентные системы ИИ помогают исследователям автоматизировать поиск торговых сигналов в рыночных данных, анализируя цены, экономические показатели и альтернативные источники для выявления скрытых паттернов.
Нейросеть для медицины: NVIDIA создала генератор 3D снимков
NVIDIA представила фреймворк NV-Generate-CTMR для автоматического синтеза реалистичных 3D медицинских изображений, решая дефицит данных в радиологии и ускоряя обучение обобщённых AI-моделей.
NVIDIA Vera Rubin: как разработчики будут масштабировать агентский ИИ без задержек
NVIDIA представила Vera Rubin — платформу для масштабирования агентского ИИ, которая комбинирует GPU Vera Rubin NVL72 и ускоритель Groq 3 LPX для достижения 400 токенов в секунду на триллион-параметрных моделях.
NVIDIA показала различие между оценкой моделей и оценкой AI-агентов
Бенчмарки моделей и оценка агентов решают разные задачи: первые тестируют понимание языка, вторые — реальное поведение системы в действии.