NVIDIA Developer Blog
Источник AI-новостей. Материалы автоматически отбираются и адаптируются редакцией Hamidun News.
Последние публикации

NVIDIA представила ReplaySSM: как ускорить декодинг гибридных моделей Mamba и GDN
NVIDIA разбирает, как хранить состояние SSM-слоёв при декодинге гибридных LLM. Тема касается Nemotron 3, Qwen3.5–3.8, Kimi-K3 и GLM-5.3-Flash.

NVIDIA масштабировала побитовый детерминизм в Megatron Core до 2432 GPU с 2% overhead
NVIDIA достигла побитового детерминизма при обучении триллион-параметрического Nemotron на 2432 GPU с overhead всего 2%, позволяя надёжно воспроизводить критические ошибки, отлаживать скачки loss и возобновлять прерванно

NVIDIA описала 5 шагов подготовки SimReady-ассетов для роботов с помощью ИИ-агентов
NVIDIA показала workflow преобразования CAD в OpenUSD-активы для роботов. Frontier-модели вроде GPT-6 Astra автоматизируют подготовку: конвертацию, конфигурацию физических свойств и валидацию через SimReady Foundation.

NVIDIA KGMON заняла 2-е место на KDD Cup 2026, упростив обвязку агента
Команда NVIDIA KGMON стала второй на KDD Cup 2026 Data Agents: агент отвечал на вопросы по шести типам данных, от баз до видео. Ставка сделана на компактную обвязку.

NVIDIA CCCL Runtime: современные C++ абстракции для безопасной разработки на CUDA
NVIDIA добавила в библиотеки CCCL новую группу инструментов Runtime — современные C++ абстракции, которые делают GPU-разработку безопаснее и сокращают типичный шаблонный код.

NVIDIA взяла 100% на ARC-AGI-3: главным героем оказалась не модель, а обвязка
Архитектура NVIDIA AVO показала абсолютный результат на интерактивном бенчмарке ARC-AGI-3. Ключевой вывод: решает не сама модель, а harness — система, которая управляет её контекстом, инструментами и восстановлением посл

NVIDIA Exemplar Cloud: почему одинаковые AI-кластеры теряют до 12% производительности
NVIDIA зафиксировала систематический разрыв 8–12% в training throughput между идентичными AI-кластерами на H100 и GB200 NVL72 — причина в конфигурации, а не в железе.

NVIDIA ускорила аналитические запросы Presto на GPU-платформе GB200 NVL72
NVIDIA показала GPU-ускорение SQL-движка Presto на платформе GB200 NVL72 для низколатентной аналитики очень больших наборов данных.

NVIDIA показала профиль LangChain Deep Agents для модели Nemotron 3 Ultra
NVIDIA выпустила профиль LangChain Deep Agents под модель Nemotron 3 Ultra, чтобы сократить разрыв в точности с проприетарными frontier-моделями при меньшей стоимости.

NVIDIA описала неравномерный тензорный параллелизм для обучения LLM на GPU
NVIDIA опубликовала в Developer Blog разбор техники nonuniform tensor parallelism, повышающей goodput при обучении больших языковых моделей на кластерах из тысяч GPU.

NVIDIA показала оптимизацию пайплайна NuRec через Nsight Developer Tools
NVIDIA рассказала, как инженеры ускоряют нейросетевую 3D-реконструкцию Omniverse NuRec с помощью профилировщиков Nsight Developer Tools.

NVIDIA Developer Blog разобрала техники обучения AI-агентов с подкреплением RL
NVIDIA Developer Blog опубликовал разбор техник reinforcement learning для AI-агентов — от классического RLHF до новых подходов обучения моделей через обратную связь.

NVIDIA описала GQE — платформу для GPU-ускоренных движков обработки запросов
NVIDIA опубликовала технический материал о GQE — платформе для проектирования GPU-ускоренных движков запросов, упирающихся в пропускную способность памяти.

NVIDIA XR AI: как компания помогает разработчикам строить ИИ-агентов для AR-очков
NVIDIA описала инфраструктурный разрыв в разработке ИИ-агентов для AR-очков и XR-устройств: железо готово, а интеграция живых ИИ-сервисов остаётся сложной.

NVIDIA объяснила, как создать transaction foundation model для финансовой аналитики
NVIDIA описала подход к созданию собственной foundation-модели на транзакционных данных банка — для выявления мошенничества и более точного анализа финансового поведения клиентов.

NVIDIA DSX OS: открытая операционная система для ИИ-фабрик любого масштаба
NVIDIA выпустила модульный ОС для управления мегадата-центрами с ИИ-ускорителями, решая проблему фрагментации рынка.

NVIDIA Vera CPU: новый стандарт для агентских AI-задач в фабриках
Процессор Vera специально оптимизирован для запуска агентских рабочих нагрузок в эпоху масштабируемого AI-инференса.

NVIDIA Cosmos 3: модели для рассуждений и действий в физическом мире роботов
NVIDIA представила Cosmos 3 — набор фундаментальных моделей для физического AI, включая world models, reasoning models и action models для роботов и автономных систем.

NVIDIA DGX Spark: локальные AI-агенты на ускоренных моделях с кластеризацией
NVIDIA представила поддержку локальных AI-агентов на DGX Spark с более быстрыми моделями и возможностью многоузлового кластеринга для масштабируемых рабочих нагрузок.

NVIDIA Alpamayo: обучение моделей автомобилей в замкнутом цикле
NVIDIA представила Alpamayo — платформу для пост-обучения моделей автономных автомобилей с использованием замкнутого цикла симуляции и реальных данных.

NVIDIA DOCA: встроенная безопасность для инфраструктуры агентивного ИИ
NVIDIA представила DOCA — платформу в составе сетевых чипов, которая обеспечивает встроенные гарантии безопасности для «AI-фабрик» обработки данных в нейросетевых вычислениях.

NVIDIA NeMo генерирует синтетические финансовые данные для AI
NVIDIA представила метод синтетической генерации финансовых данных для обучения LLM, решающий проблему дисбаланса редких событий в реальных новостях.

NVIDIA BioNeMo Agent Toolkit: ускорение структурного предсказания белков
NVIDIA представила BioNeMo Agent Toolkit для управления AI-агентами, которые автоматизируют полный конвейер структурного предсказания белков и co-folding, ускоряя фармацевтическую разработку.

LLM и железо: NVIDIA о балансе точности, пропускной способности и отклика
NVIDIA опубликовала рекомендации по проектированию LLM, которые требуют одновременной оптимизации трёх параметров: точности, пропускной способности и скорости отклика для пользователя.
NVIDIA Vera CPU повышает пропускную способность AI-фабрик для агентных нагрузок
NVIDIA объяснила, как процессор Vera CPU снимает задержки между шагами GPU-инференса и ускоряет агентные многошаговые пайплайны в промышленных AI-фабриках.
NVIDIA Confidential Computing: защита данных при AI-инференсе без потери скорости
NVIDIA объяснила, как технология Confidential Computing защищает корпоративные данные непосредственно в момент GPU-вычислений, не жертвуя производительностью.
NVIDIA TensorRT теперь масштабирует инференс генеративного AI на несколько GPU
NVIDIA добавила в TensorRT нативную поддержку нескольких GPU — модели для генерации медиаконтента масштабируются в продакшне без потери ключевых оптимизаций движка.
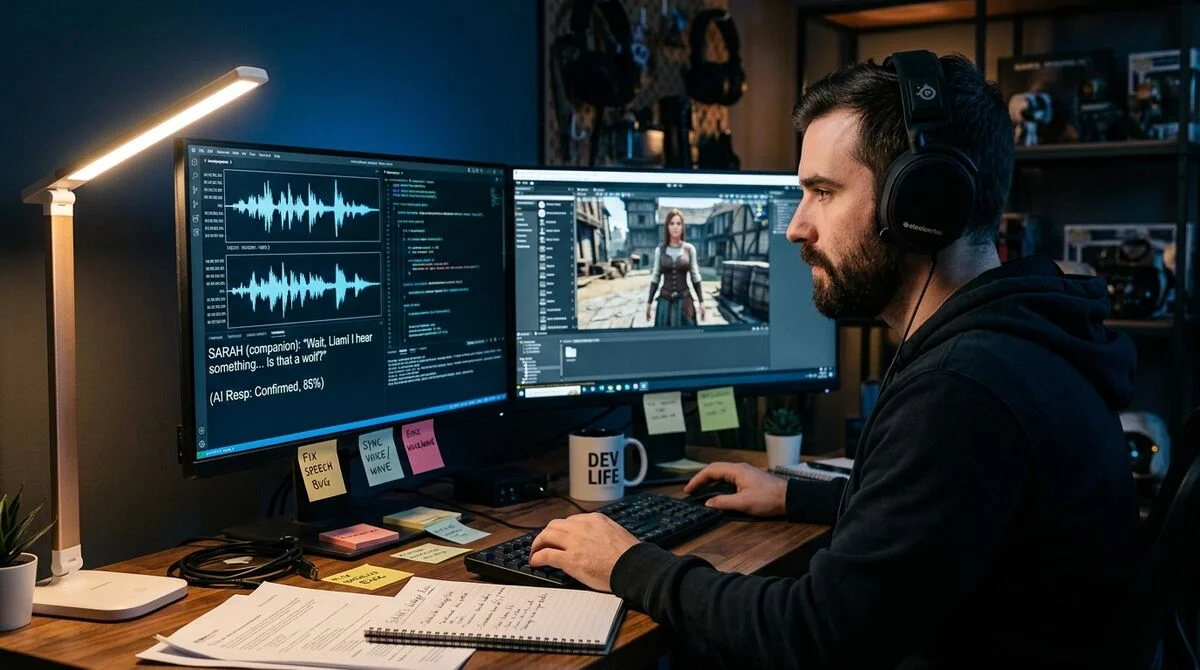
KRAFTON встроила в PUBG голосового AI-напарника Ally на базе NVIDIA ACE
PUBG Ally — AI-тиммейт в PUBG: BATTLEGROUNDS, который слышит голосовые команды, принимает тактические решения и отвечает синтезированным голосом на базе NVIDIA ACE.
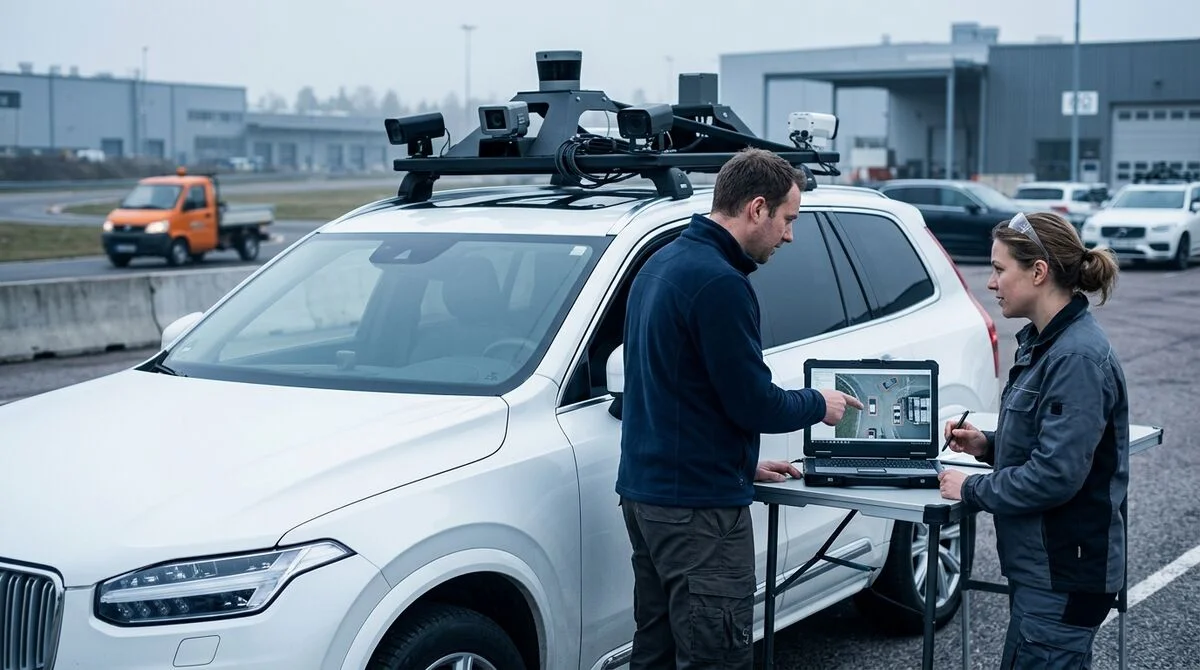
NVIDIA оптимизировала BEV-пулинг на GPU для беспилотников, роботов и пространственного ИИ
NVIDIA опубликовала руководство по ускорению BEV-пулинга на GPU — ключевой операции для восприятия пространства в беспилотниках, роботах и пространственных ИИ-системах.
NVIDIA выпустила руководство по развёртыванию AI-Q Blueprint на Oracle Cloud Infrastructure
NVIDIA открыла путь к продакшн-развёртыванию долгосрочных AI-агентов: AI-Q Blueprint теперь готов к запуску на Oracle Cloud с enterprise-уровнем безопасности.