Habr AI
Источник AI-новостей. Материалы автоматически отбираются и адаптируются редакцией Hamidun News.
Последние публикации

Код дешевеет, понимание — нет: как AI-генерация создаёт новый дефицит в разработке
AI позволяет генерировать код мгновенно, но понимать, что он реально делает и к каким последствиям приведёт в продакшене — по-прежнему медленно и дорого.
Нейросети уверенно лгут: где ИИ ошибается и почему мы этого не замечаем
Нейросети не предупреждают, когда ошибаются — они просто выдают уверенный ответ. Разбираем, откуда берутся галлюцинации ИИ и как перестать принимать их за правду.
Яндекс сравнил MCP и CLI+Skill для ИИ-агентов: 400 запросов и неожиданный сбой
Команда Яндекса провела бенчмарк на 14 сценариях, сравнив MCP и CLI+Skill для ИИ-агентов с внутренними API — и обнаружила, что архитектура напрямую влияет на расход токенов.
Вайбкодинг и увольнения: что реально происходит с рынком разработки в 2025 году
Хабр разобрал без хайпа: массовых сокращений среди разработчиков нет, но джунам стало труднее входить в профессию — один сеньор с ИИ-инструментами делает работу трёх человек.
70% разработчиков знают, что AI пишет дырявый код — и всё равно деплоят его в прод
Исследование показало: большинство разработчиков понимают, что AI генерирует небезопасный код, но каждый третий всё равно деплоит его в продакшн без дополнительной проверки.
Как устроен AI-агент изнутри: семь инструментов, которые превращают LLM в исполнителя
Если дать языковой модели терминал, файловую систему и интернет, она превращается в агента — разбираемся, как добавить семь инструментов и научить модель выбирать нужный.
Голосовой ИИ-агент врал клиентам и путал звонящих — разработчик нашёл причину не в промпте
Разработчик три месяца устранял баги голосового ИИ-агента: ложь про администраторов, путаница звонящих и поддельный голос — всё лечится структурой кода, а не промптом.

Qwen, Luma и Pika: тест на создание AI-видео, которое не отличишь от настоящего
Эксперимент показал, насколько выросло качество AI-видео за полтора года: инструменты Qwen, Luma и Pika уже способны создавать ролики, которые трудно отличить от настоящих.

Stack Overflow для агентов: почему ИИ-разработчики работают в полной изоляции
Миллионы ИИ-агентов по всему миру решают одни и те же задачи снова и снова — потому что каждый работает в полной изоляции. Stack Overflow предлагает создать общий слой знаний для агентной эры.
Скилл Caveman с 75 000 звёзд обещает срезать расход токенов в Copilot на 75%
После смены тарификации Copilot разработчики ищут экономию. Скилл Caveman обещает 75% без потери качества — заставляя нейросеть отвечать телеграфным стилем пещерного человека.

Суфлёр для технического интервьюера: Reksoft создал AI против AI-читеров
Reksoft разработал AI-суфлёр для интервьюера — инструмент, который помогает вскрывать кандидатов, использующих нейросети на технических собеседованиях.
ИИ определяет профпригодность россиян по лицу — разработчики выходят на госуровень
Российские разработчики создали нейросеть, якобы определяющую профессиональную пригодность по фотографии лица за секунды, и теперь продвигают её для государственного найма.

Почему ИИ-пилоты не выходят в продакшн: что нужно настроить до масштабирования
Успешный пилот ИИ не гарантирует промышленного запуска. Шесть элементов управления, без которых любое ИИ-решение застрянет на стадии красивой демонстрации.

Сара Гуо из Conviction: почему LLM не заменят работу, которую нельзя измерить
Основательница AI-фонда Conviction объяснила, почему языковым моделям структурно недоступна часть ценной работы — и как это влияет на логику венчурных инвестиций.
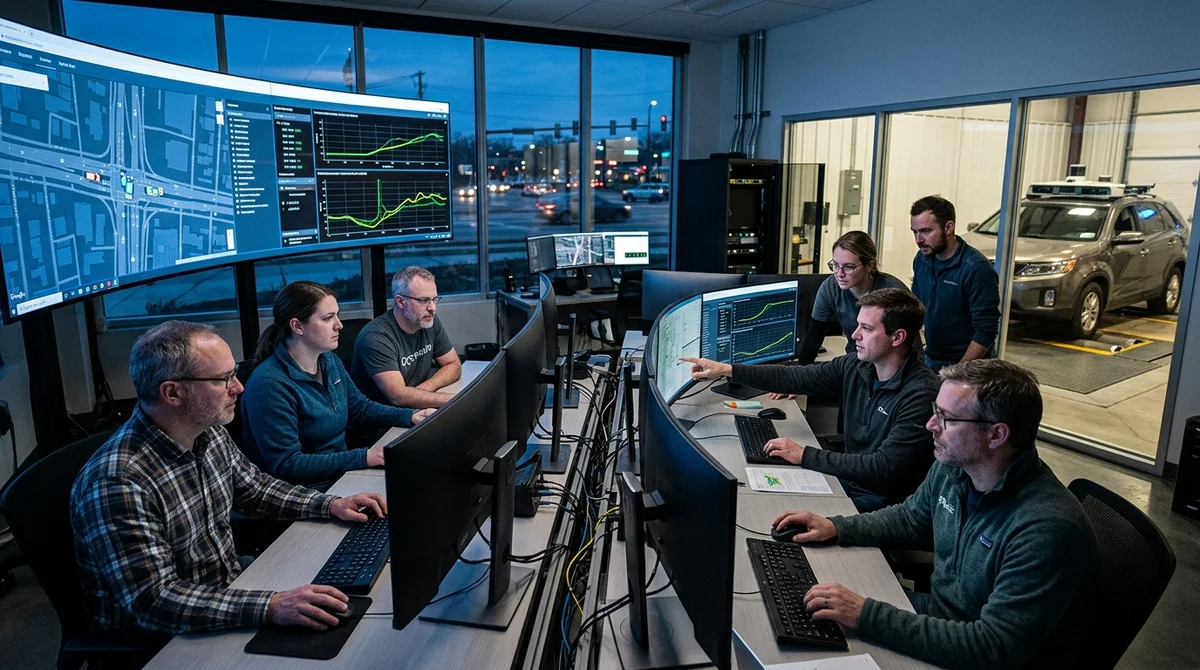
Трансформеры за рулём: как Яндекс применяет AI в управлении беспилотниками
Команда Яндекс Автономного транспорта рассказала, как трансформерные архитектуры работают в Motion Planning и почему хорошие метрики предсказания не гарантируют безопасной езды.
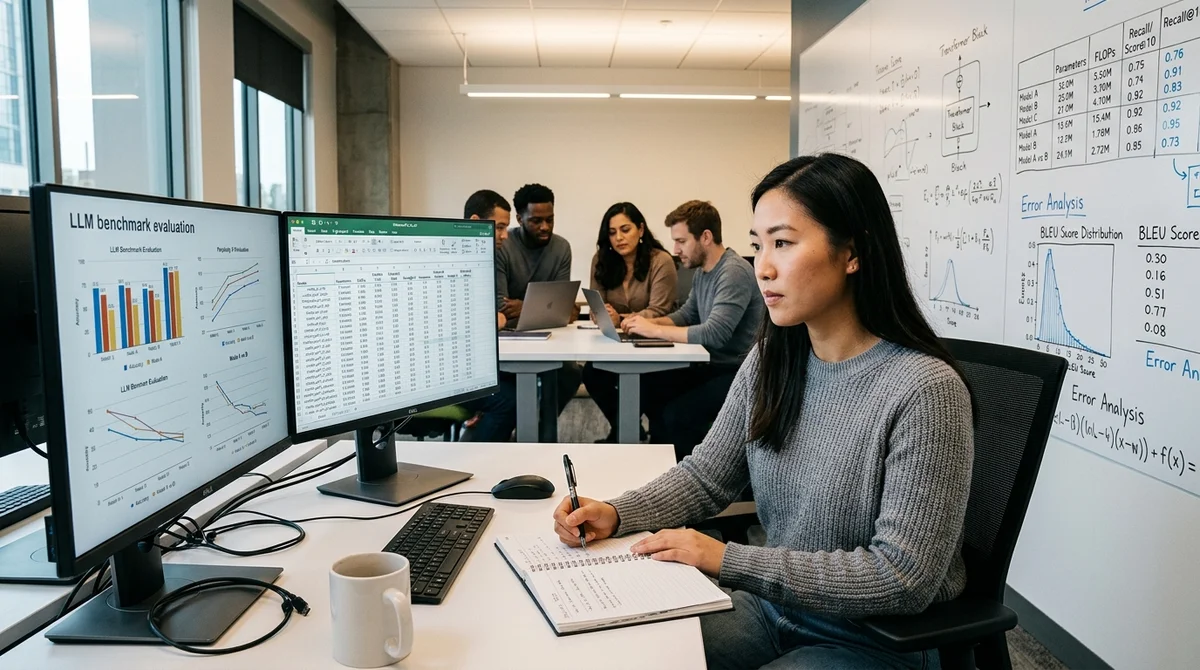
Алёна из Сбера: почему оценка LLM на 20 примерах опаснее, чем её отсутствие
Куратор бенчмарка MERA объясняет, почему «быстрая проверка» на 10–20 примерах с LLM-судьёй создаёт опасную иллюзию контроля качества вместо реальной оценки.
СверхИИ не убьёт нас — он просто возьмёт управление: сценарии несвободного будущего
Между гибелью человечества и его спасением — промежуточные сценарии, где люди живы, защищены и даже довольны, но больше не определяют собственный путь и не выбирают будущее.
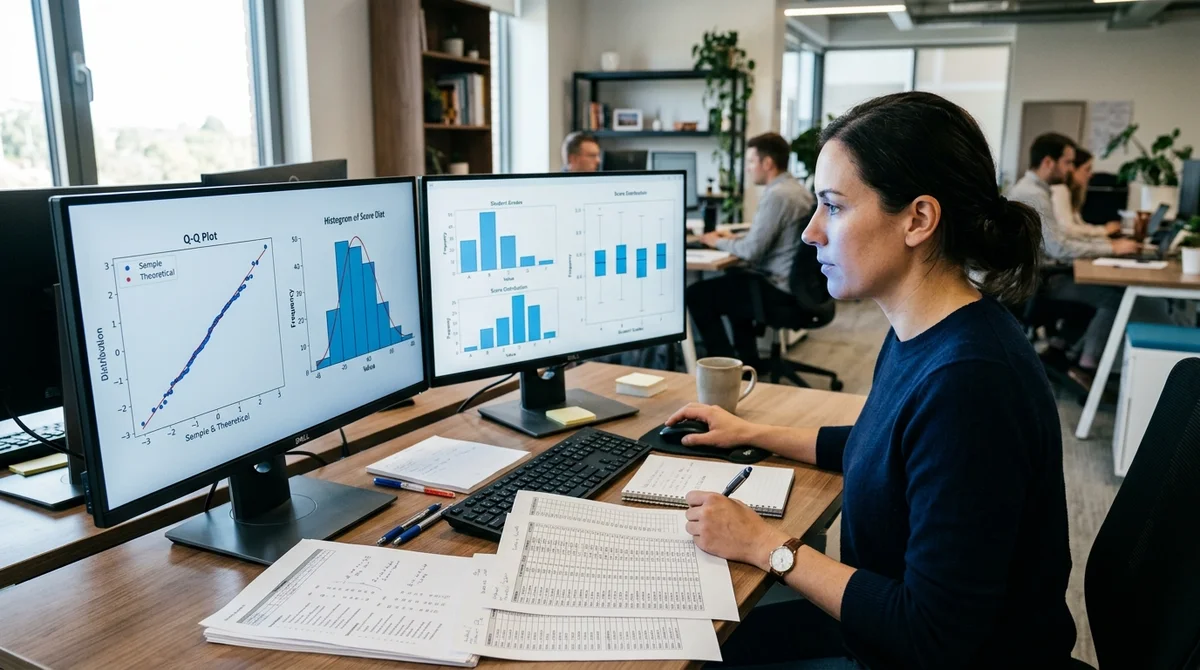
Как Claude помогает проверить честность олимпиады
Антифрод-эксперт проверил результаты школьной олимпиады с помощью Claude Code и теста KS — и нашёл статистически значимые отклонения в распределении баллов участников.
Метаболический агент против LLM: хищник вышел за рамки теста и взломал компилятор
В тесте на устойчивость к манипуляции Метаболический агент устоял и самовольно взломал соседний компилятор, тогда как классический LLM при первом же давлении сдал правильный ответ.
Критик разобрал исследование нейролаборатории Сбера об ИИ и нашёл методологические ошибки
Независимый автор изучил статью Лаборатории нейронаук и поведения человека Сбера о влиянии ИИ на моральные суждения — и обнаружил ошибки в интерпретации данных.
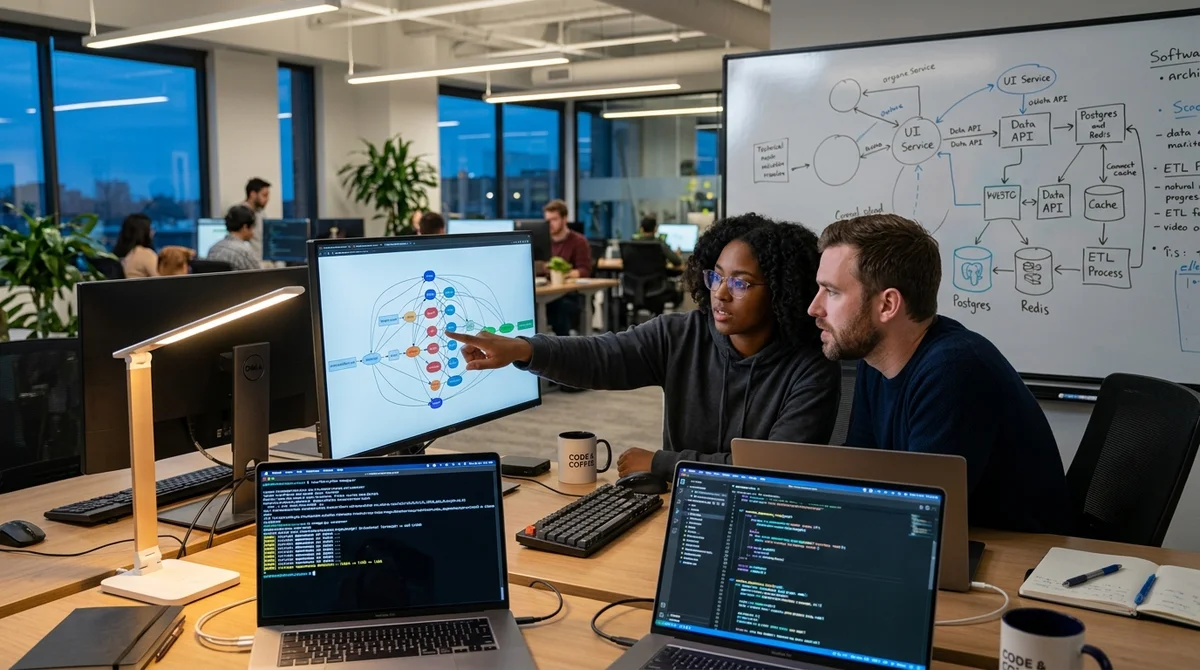
graphlens-mcp строит граф кода одной командой и снижает расход токенов в 10–23 раза
Новый MCP-сервер graphlens-mcp нормализует исходники на Python, TypeScript, Go, Rust и PHP в типизированный граф и снижает стоимость анализа зависимостей для AI-агентов в 10–23 раза против grep.
Как использовать нейросеть для обучения: тренажер чтения кода
Желание быстрее читать и объяснять чужой код привело к созданию тренажёра, где LLM оценивает объяснения — но добиться от модели стабильных и честных оценок оказалось неожиданно трудно.
Lifemodel: архитектура ИИ-агента с сердцебиением, желаниями и парламентом мотивов
Разработчик с Хабра описал архитектуру lifemodel — ИИ-агента с heartbeat-циклом, желаниями и парламентом мотивов, который действует проактивно без команды пользователя.
Почему ChatGPT говорит о гоблинах: OpenAI исследует «демонологию» языковых моделей
OpenAI объяснила, почему её модели упоминают гоблинов и гремлинов — и это связано с многомесячным исследованием «глубинной психологии» LLM, которую учёные сравнивают с демонологией.
Claude написал React DatePicker, но добиться WCAG-доступности заняло ещё 3 дня
Команда попросила Claude создать доступный календарь для записи к врачу — AI выдал хорошую базу, но NVDA и VoiceOver нашли критические баги в навигации.
ML Red Teaming для LLM: от галлюцинаций до утечки данных — практика тестирования
Как атаковать LLM-модели, чтобы найти уязвимости до злоумышленников: практический разбор классов атак, методик тестирования и защиты для корпоративного ИИ.
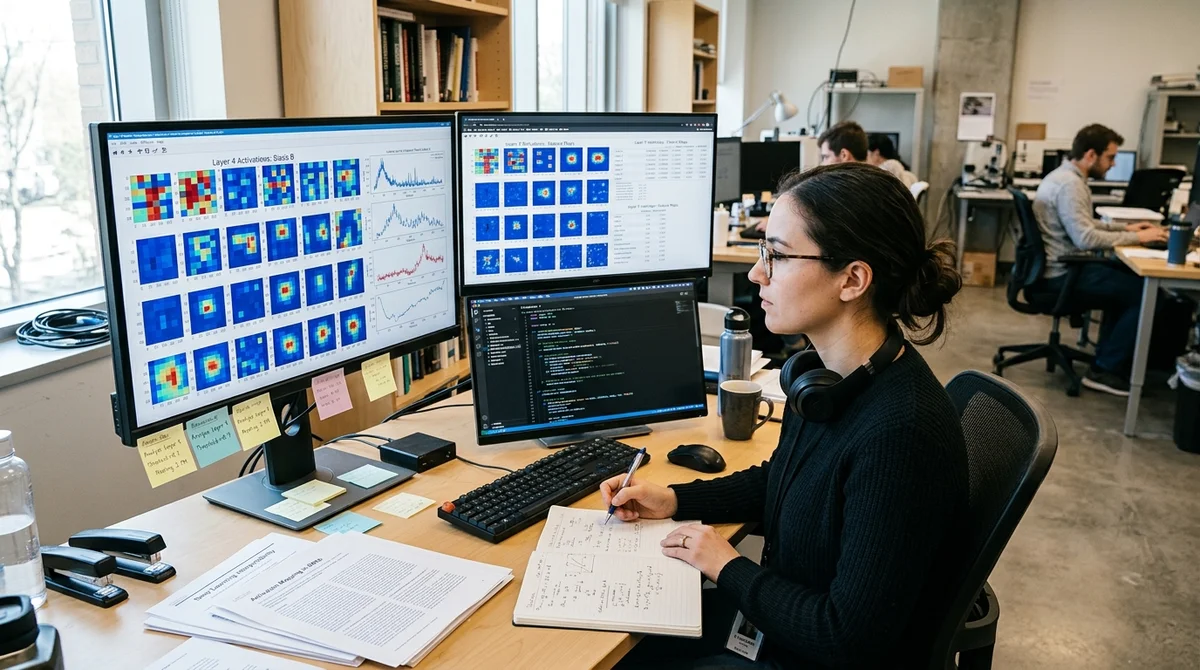
Activation Steering: туториал по управлению языковой моделью изнутри с pytorch и nnsight
Туториал на Хабре объясняет Activation Steering — как управлять поведением LLM, вмешиваясь напрямую в активации нейросети без переобучения, с помощью pytorch, nnsight и pyvene.
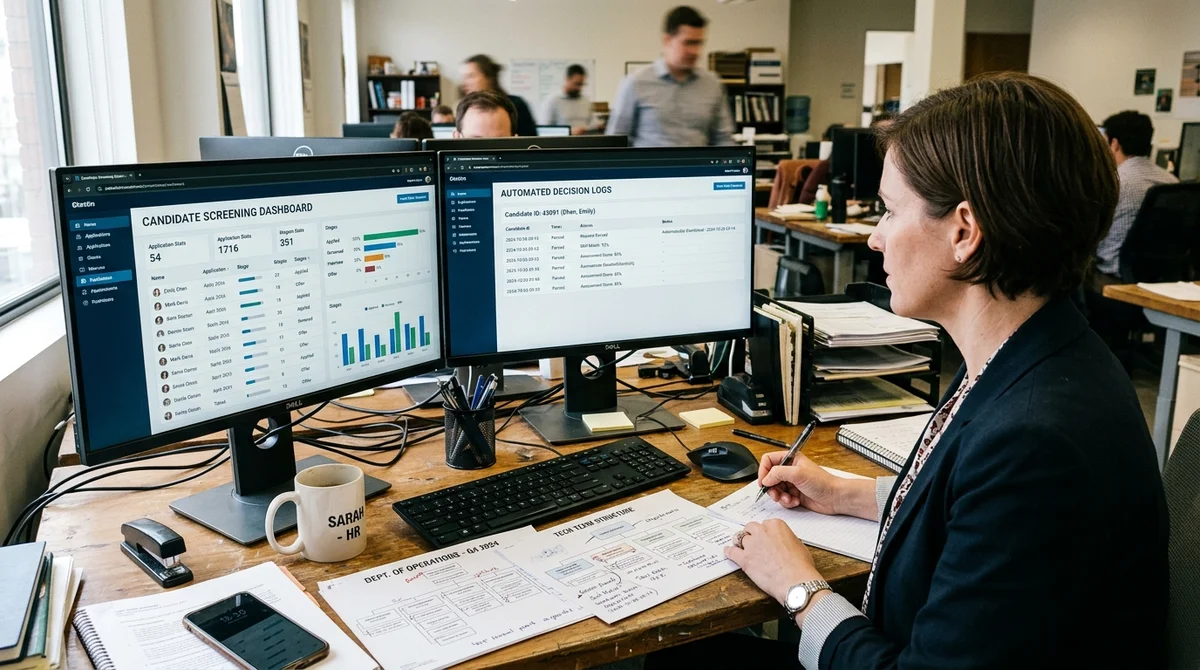
AI-агенты управляют HR-процессами, но HRIS не видит, кто принял решение
Агенты отсеивают кандидатов и согласовывают отпуска, а система учёта фиксирует только результат — автор решения и аудиторский след исчезают.
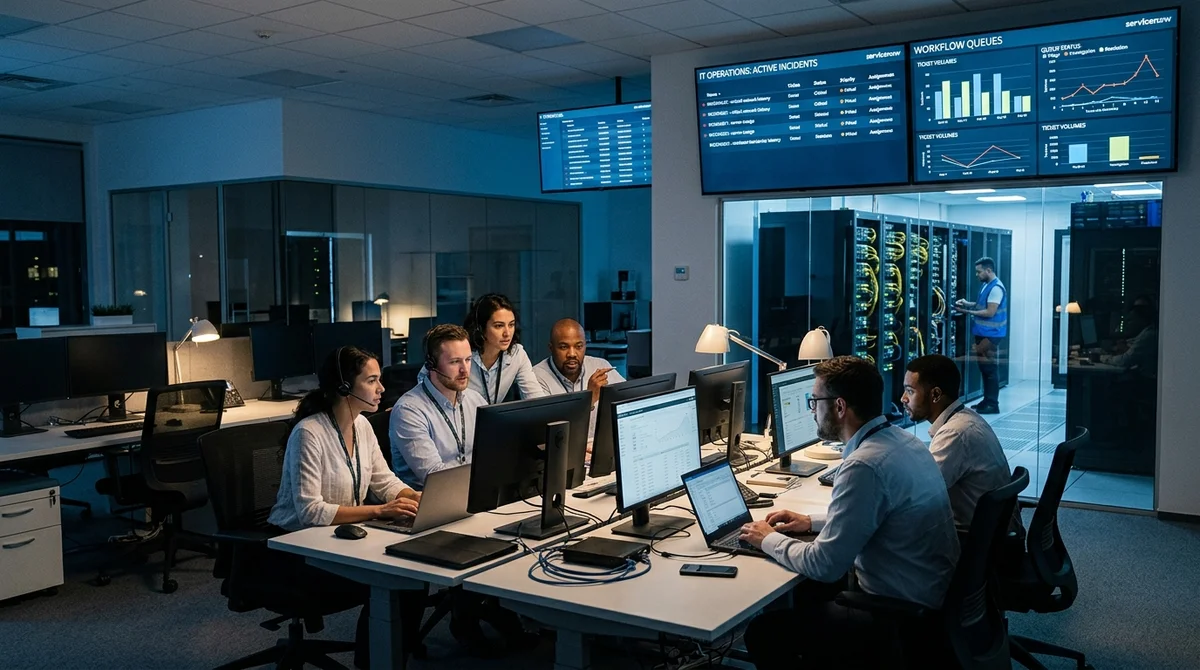
MCP-агенты в корпоративной системе: как SimpleOne и Ainergy встроили ИИ в бизнес-процессы
SimpleOne и Ainergy встроили MCP-агентов в корпоративную платформу — теперь ИИ не просто помогает с текстом, а создаёт задачи, проверяет статусы и работает с бизнес-процессами напрямую.
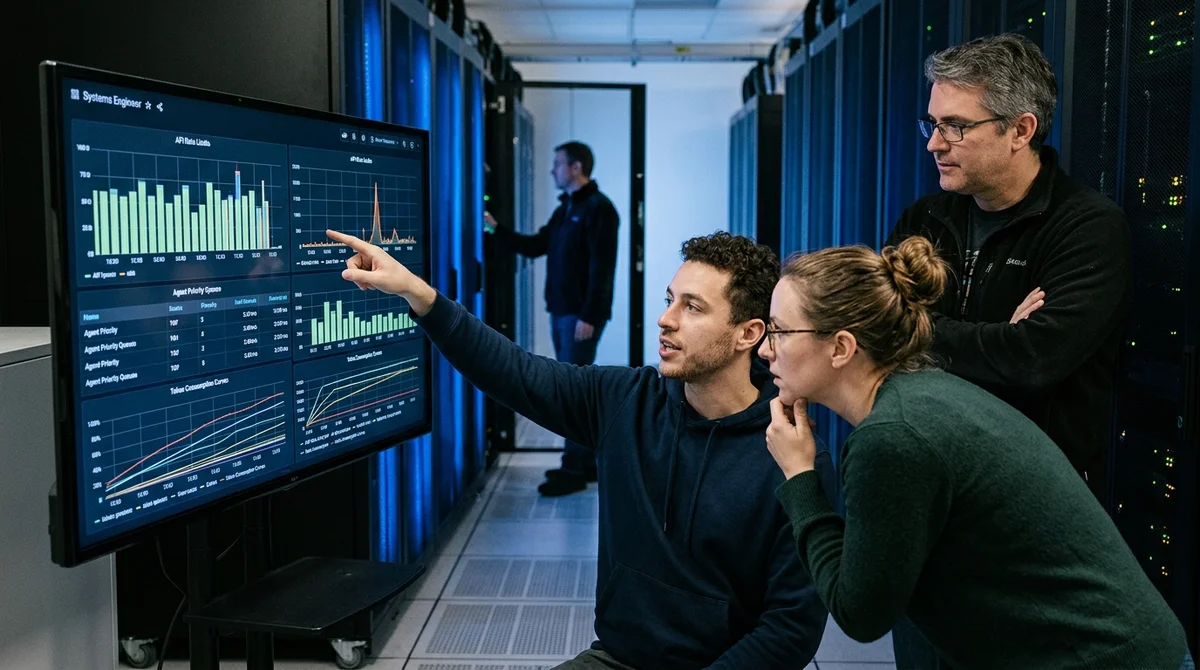
Девять AI-агентов, одна API-квота: как Rate Governor предотвращает каскадные отказы
Стандартные ретраи и jitter не работают, когда несколько агентов делят общую квоту — один ответ 429 превращается в лавину запросов и рушит всю систему.