Together AI alcança treinamento 90% mais rápido na NVIDIA Blackwell
A Together AI divulgou resultados na NVIDIA Blackwell: o treinamento do Llama 70B ficou 90% mais rápido que na H100, com 15,264 tokens/s contra 8,080, graças a kernels otimizados próprios (Together Kernel Collection) e formatos FP8. A empresa lança um programa de testes com oito equipes pioneiras de IA.
Processado por IA de Together AI Blog; editado por Hamidun News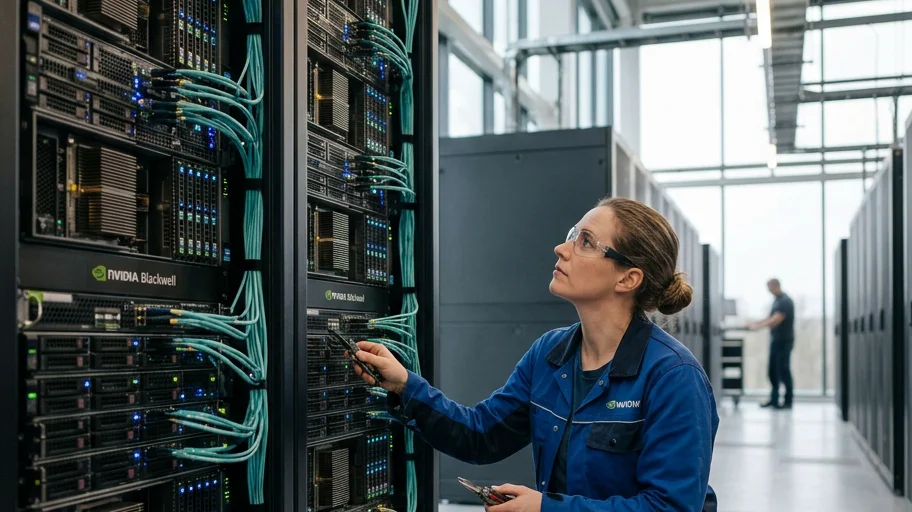
A Together AI anunciou acesso imediato a clusters de GPUs acelerados pela NVIDIA Blackwell e apresentou seu próprio stack de otimização, adaptado especificamente à nova arquitetura de hardware para redes neurais.
Resultados: 90% mais rápido que a H100
Nos testes com um modelo Llama de 70 bilhões de parâmetros, a equipe da Together AI atingiu 15,264 tokens por segundo em uma única GPU. É quase o dobro do resultado da geração anterior, a NVIDIA HGX H100, que em configuração otimizada processava 8,080 tokens por segundo.
Os resultados vieram de uma versão otimizada do TorchTitan combinada com a Together Kernel Collection, coleção própria de kernels otimizados da empresa. Para contextualizar: trata-se de precisão BF16 (Brain Float 16, um meio-termo entre velocidade e exatidão que hoje é o padrão para treinar grandes modelos). Segundo a empresa, a velocidade continuará crescendo com otimizações adicionais que ainda estão em desenvolvimento.
Como funciona: otimização no nível da arquitetura
A aceleração foi possível graças a uma otimização profunda para uma arquitetura de GPU específica. A Together AI desenvolveu vários componentes que aproveitam ao máximo os recursos da NVIDIA Blackwell:
- Kernels FP8 personalizados que rodam nos Tensor Cores NVIDIA de quinta geração (unidades de computação de alto desempenho)
- Kernels de atenção que rodam 1,8 vez mais rápido que o FlashAttention-3 (o padrão atual de mecanismo de atenção otimizado)
- Integração com a biblioteca aberta ThunderKittens para usar por completo a memória dedicada do chip
- Algoritmos de treinamento distribuído adaptados à topologia da rede Quantum-2 InfiniBand
Tri Dao, cientista-chefe da Together AI e criador do FlashAttention, disse: "Otimizamos cada camada do stack de IA para aproveitar ao máximo os avanços da arquitetura de GPU. Gostamos especialmente dos novos Tensor Cores e do formato de microescala para acelerar a inferência. A combinação da Together Kernel Collection com a NVIDIA Blackwell redefine os padrões de treinamento e inferência eficientes em escala".
Programa de testes e escalonamento
Como parte de um programa de lançamento exclusivo, a Together AI convida oito empresas pioneiras de IA a ter acesso direto a nós HGX B200 dedicados e a colaborar com engenheiros da NVIDIA e pesquisadores da Together AI. O objetivo é acelerar juntos as cargas de trabalho e encontrar novas otimizações.
Ao mesmo tempo, a empresa está implantando dezenas de milhares de servidores HGX B200 e soluções GB200 NVL72 de rack completo com redes NVIDIA Quantum-2 InfiniBand. Isso inclui o cluster de mais de 36,000 GPUs anunciado anteriormente para treinar modelos de nova geração e agentes.
O que isso significa
Para as empresas de IA, o resultado é prático: treinar grandes modelos ficará mais barato e rápido. Com 90% de ganho de velocidade, modelos que antes exigiam semanas agora treinam em dias. Isso reduz bastante o gasto de capital com computação e acelera o ciclo de experimentação com novas arquiteturas.
Para o mercado em geral, é um sinal: a era dos serviços de GPU genéricos está acabando. As empresas de IA que escrevem seus próprios kernels otimizados para uma arquitetura específica (como a Together AI com o ThunderKittens) ganham vantagem competitiva em velocidade e custo. E isso afeta diretamente o preço do treinamento e, no fim, o preço dos serviços de IA para os usuários finais.
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
- 31 de out. de 2026Gateway de LLM open source KTMS 1.0 conecta GPUs próprias à nuvem e sobrevive a falhas
- 31 de out. de 2026LTX-2.5 de 22 bilhões de parâmetros roda em RTX 3080 de 10 GB, mas leva 5 minutos por plano
- 29 de out. de 2026T-Tech cria o método LIMe, que treina modelos de linguagem com 15% menos computação
Perguntas frequentes sobre a notícia
O que se sabe sobre Resultados: 90% mais rápido que a H100?
Nos testes com um modelo Llama de 70 bilhões de parâmetros, a equipe da Together AI atingiu 15,264 tokens por segundo em uma única GPU. É quase o dobro do resultado da geração anterior, a NVIDIA HGX H100, que em configuração otimizada processava 8,080 tokens por segundo. Os resultados vieram de uma versão otimizada do TorchTitan combinada com a Together Kernel Collection, coleção própria de kernels otimizados da empresa. Para contextualizar: trata-se de precisão BF16 (Brain Float 16, um meio-termo entre velocidade e exatidão que hoje é o padrão para treinar grandes modelos)
Como funciona: otimização no nível da arquitetura?
A aceleração foi possível graças a uma otimização profunda para uma arquitetura de GPU específica. A Together AI desenvolveu vários componentes que aproveitam ao máximo os recursos da NVIDIA Blackwell: Kernels FP8 personalizados que rodam nos Tensor Cores NVIDIA de quinta geração (unidades de computação de alto desempenho) Kernels de atenção que rodam 1,8 vez mais rápido que o FlashAttention-3 (o padrão atual de mecanismo de atenção otimizado) Integração com a biblioteca aberta ThunderKittens para usar por completo a memória dedicada do chip Algoritmos de treinamento distri
O que se sabe sobre Programa de testes e escalonamento?
Como parte de um programa de lançamento exclusivo, a Together AI convida oito empresas pioneiras de IA a ter acesso direto a nós HGX B200 dedicados e a colaborar com engenheiros da NVIDIA e pesquisadores da Together AI. O objetivo é acelerar juntos as cargas de trabalho e encontrar novas otimizações. Ao mesmo tempo, a empresa está implantando dezenas de milhares de servidores HGX B200 e soluções GB200 NVL72 de rack completo com redes NVIDIA Quantum-2 InfiniBand. Isso inclui o cluster de mais de 36,000 GPUs anunciado anteriormente para treinar modelos de nova geração e agent
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.