FlashAttention-4: como a Together AI acelerou a atenção nas GPUs Blackwell
O FlashAttention-4 refez o kernel de atenção especificamente para a Blackwell. A aceleração vem da nova memória tensorial (TMEM) e do modo 2-CTA MMA, que atacam o verdadeiro gargalo: não a velocidade das operações matriciais, mas a SFU do softmax e a memória. O resultado: 1605 TFLOPs/s (71% de utilização), 1,3× mais rápido que o cuDNN e 2,7× mais que o Triton.
Processado por IA de Together AI Blog; editado por Hamidun News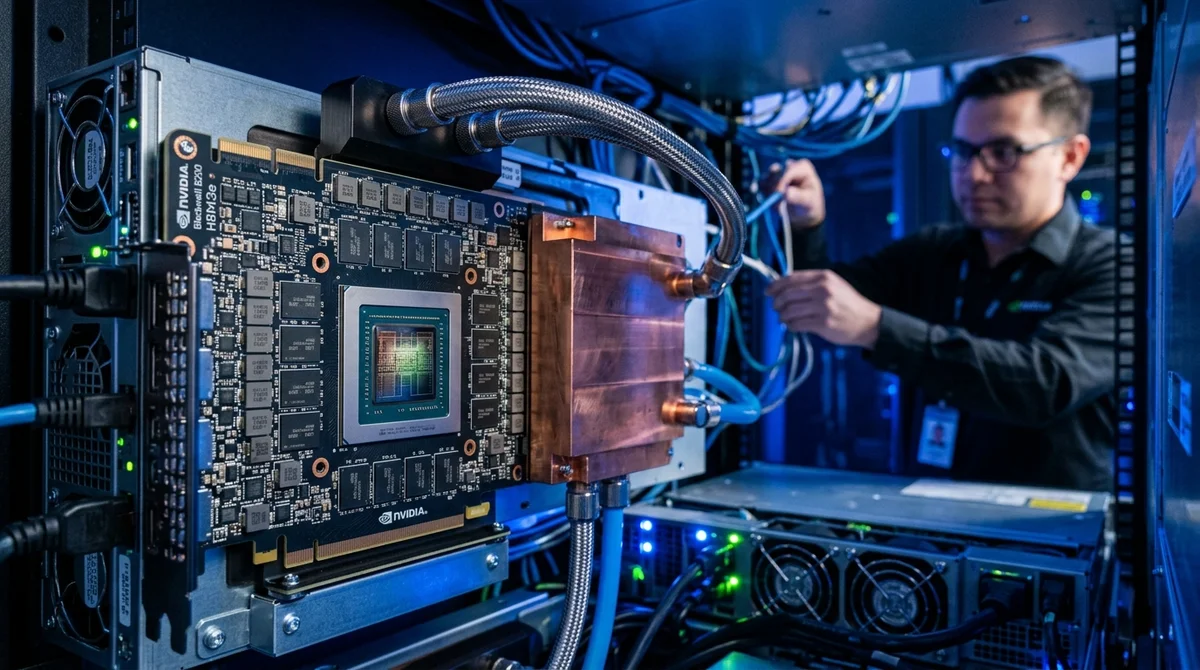
O FlashAttention-4 é uma reformulação do algoritmo de atenção feita especificamente para as GPUs modernas, nas quais os núcleos tensoriais ganham desempenho muito mais rápido que a memória e outros recursos.
Por que a abordagem padrão não funciona mais
À primeira vista, o desempenho da atenção (attention) é controlado pela velocidade de duas multiplicações de matrizes: S = Q × K^T e O = P × V. Mas a análise da Blackwell B200 mostra algo inesperado: o gargalo não está nos núcleos tensoriais, e sim nas unidades de funções especiais (SFU) que calculam a exponencial no softmax (forward pass) e no tráfego da memória compartilhada (backward pass). Do Hopper (H100) para a Blackwell (B200), o desempenho dos núcleos tensoriais em BF16 passou de 1 para 2.
25 petaflops, enquanto o número de SFUs e a largura de banda da memória compartilhada continuaram os mesmos. Essa assimetria quebra a otimização padrão: não dá para simplesmente presumir que os núcleos determinam todo o desempenho. Na prática, eles atrapalham uns aos outros.
Como a Together AI resolveu o problema
O grupo de pesquisa, junto com engenheiros da NVIDIA, Meta* e Princeton, propôs três ideias principais:
- Novo pipelining: pipelines em software que sobrepõem ao máximo o trabalho dos núcleos tensoriais, da SFU e da memória, sem ociosidade.
- Emulação da exponencial com polinômios: em vez da lenta SFU, o forward pass calcula a exponencial nas rápidas unidades FMA (fused multiply-add).
- TMEM e 2-CTA MMA: uso da nova memória tensorial (256 KB por SM) mais um modo em que dois blocos de threads trabalham na mesma operação matricial, reduzindo o tráfego da memória compartilhada.
Recursos da Blackwell que viabilizaram isso
A Blackwell ganhou vários recursos pensados para otimizações desse tipo:
A memória tensorial (TMEM) é um armazenamento rápido no chip (256 KB por SM), ligado diretamente aos núcleos tensoriais. Resultados intermediários podem ficar na TMEM sem passar pela memória compartilhada, mais lenta, o que reduz drasticamente a latência de acesso.
Núcleos tensoriais assíncronos de 5ª geração: cada operação é disparada por uma única thread e acumula os resultados na TMEM. O tile máximo para BF16 é 128×256×16 (cerca de 2 vezes o do Hopper), o que permite um pipelining mais profundo sem estourar os registradores.
2-CTA MMA é um modo novo em que dois blocos de threads trabalham ao mesmo tempo na mesma operação matricial. Ele reduz pela metade a carga na memória compartilhada e diminui o número de operações atômicas.
Números e resultados
Na Blackwell B200 com BF16, o FlashAttention-4 chega a 1605 TFLOPs/s (71% de utilização). Isso é 1,3× mais rápido que o cuDNN 9.13 e 2,7× mais rápido que o Triton. Para contextualizar: 1605 TFLOPs é quase metade do desempenho de pico da Blackwell, mas extraído de um kernel de atenção complexo.
O que isso significa
O FlashAttention-4 mostra como trabalhar na era do escalonamento assimétrico das GPUs: em vez de ficar ajustando parafusos em algoritmos antigos, refazê-los junto com as novas capacidades do hardware. O resultado parece uma conquista, mas é apenas o começo da adaptação à nova realidade do hardware.
*A Meta é considerada organização extremista e está proibida na Rússia.
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
- 31 de out. de 2026Gateway de LLM open source KTMS 1.0 conecta GPUs próprias à nuvem e sobrevive a falhas
- 31 de out. de 2026LTX-2.5 de 22 bilhões de parâmetros roda em RTX 3080 de 10 GB, mas leva 5 minutos por plano
- 29 de out. de 2026T-Tech cria o método LIMe, que treina modelos de linguagem com 15% menos computação
Perguntas frequentes sobre a notícia
Por que a abordagem padrão não funciona mais?
À primeira vista, o desempenho da atenção (attention) é controlado pela velocidade de duas multiplicações de matrizes: S = Q × K^T e O = P × V. Mas a análise da Blackwell B200 mostra algo inesperado: o gargalo não está nos núcleos tensoriais, e sim nas unidades de funções especiais (SFU) que calculam a exponencial no softmax (forward pass) e no tráfego da memória compartilhada (backward pass). Do Hopper (H100) para a Blackwell (B200), o desempenho dos núcleos tensoriais em BF16 passou de 1 para 2.25 petaflops, enquanto o número de SFUs e a largura de banda da memória compar
Como a Together AI resolveu o problema?
O grupo de pesquisa, junto com engenheiros da NVIDIA, Meta e Princeton, propôs três ideias principais: Novo pipelining: pipelines em software que sobrepõem ao máximo o trabalho dos núcleos tensoriais, da SFU e da memória, sem ociosidade. Emulação da exponencial com polinômios: em vez da lenta SFU, o forward pass calcula a exponencial nas rápidas unidades FMA (fused multiply-add). TMEM e 2-CTA MMA: uso da nova memória tensorial (256 KB por SM) mais um modo em que dois blocos de threads trabalham na mesma operação matricial, reduzindo o tráfego da memória compartilhada.
O que se sabe sobre Recursos da Blackwell que viabilizaram isso?
A Blackwell ganhou vários recursos pensados para otimizações desse tipo: A memória tensorial (TMEM) é um armazenamento rápido no chip (256 KB por SM), ligado diretamente aos núcleos tensoriais. Resultados intermediários podem ficar na TMEM sem passar pela memória compartilhada, mais lenta, o que reduz drasticamente a latência de acesso. Núcleos tensoriais assíncronos de 5ª geração: cada operação é disparada por uma única thread e acumula os resultados na TMEM. O tile máximo para BF16 é 128×256×16 (cerca de 2 vezes o do Hopper), o que permite um pipelining mais profundo sem
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.