Sistemas RAG quebram com dados reais: o culpado é o retrieval, não o modelo
Pipelines RAG costumam falhar não por causa do modelo, mas do retrieval. Quando o sistema não encontra o documento ou o trecho de texto certo, até o GPT-4 começa a alucinar. Um modelo é tão bom quanto o contexto que lhe entregam.
Processado por IA de Habr AI; editado por Hamidun News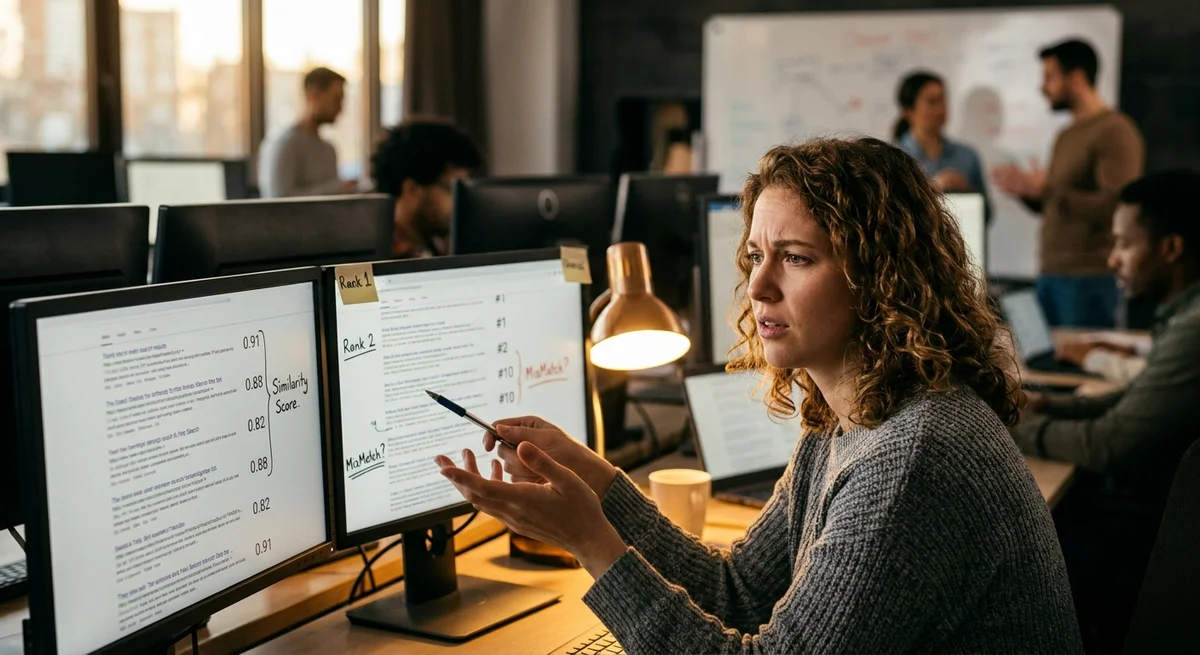
Um pipeline RAG parece mágica: você carrega os documentos, divide em chunks, gera embeddings e conecta um banco de dados vetorial. Faz uma pergunta, e o modelo responde com confiança e detalhes. Mostra ao cliente, que fica encantado. Mas aí começa o teste real com perguntas de verdade, e descobre-se que o sistema erra o alvo em metade delas.
O gargalo do RAG
Com perguntas reais, o sistema costuma responder errado. Às vezes encontra o documento errado. Às vezes encontra o documento certo, mas extrai o trecho errado. Às vezes não recupera nada relevante, e o modelo alucina com toda a confiança.
Parece que o problema é o modelo. Na verdade, o culpado é o retrieval. GPT-4 e Claude respondem muito bem quando recebem o contexto certo. Se o contexto estiver errado, a alucinação é garantida, por melhor que seja o modelo. O modelo responde tão bem quanto o contexto que lhe entregam.
O problema não são os modelos. O problema é o retrieval: a forma como buscamos os trechos relevantes na sua base de documentos. É o gargalo por onde passa todo o pipeline RAG. Se o retrieval entrega ao modelo um contexto errado, todo o resto é tempo e dinheiro perdidos.
"O modelo responde tão bem quanto o contexto que lhe entregam."
Quando o retrieval quebra
O retrieval pode quebrar por dezenas de motivos. Os mais comuns:
- A divisão em chunks é grande ou pequena demais. Um chunk de 512 palavras pode capturar contexto vizinho em vez do trecho necessário. A pergunta é sobre a política de devolução, mas o chunk traz a descrição de uma tabela de tamanhos.
- Os embeddings foram gerados para dados em inglês, mas a pergunta está em russo. A distância semântica entre o vetor da pergunta e os vetores dos documentos é enorme, e não há correspondências.
- A pergunta é reformulada de modo que seu vetor de embedding não bate com os vetores da base. Você busca "devolver um pedido", mas os documentos dizem "devolução de produto": semântica diferente.
- O documento relevante aparece em 8º lugar entre 10, mas o modelo recebeu apenas os 5 primeiros resultados. O contexto necessário simplesmente não entra na janela de visibilidade.
- O índice está cheio de duplicatas e ruído. Muitos chunks irrelevantes empurram a informação correta para fora dos resultados.
Cada um desses problemas leva ao mesmo resultado: o modelo alucina em vez de dar a resposta certa.
O preço do retrieval
Otimizar o retrieval não é passatempo de entusiasta. É trabalho de verdade: uma ou duas semanas de um desenvolvedor dedicadas à análise vão revelar que o sistema está 30-40% abaixo da precisão esperada. A causa não é o modelo, e sim o fato de o retrieval buscar errado. Em projetos reais, é uma perda enorme: tempo gasto com RAG, dinheiro gasto com infraestrutura, e o sistema não funciona porque os vetores dos documentos não batem com os das perguntas.
O que isso significa
O RAG só funciona se o retrieval funcionar. Sem isso, até o melhor modelo vai errar. Isso significa que, antes de lançar o RAG em produção, é preciso investir tempo sério na otimização da busca, em testes com dados reais e, depois, na melhoria iterativa do pipeline de retrieval.
- 21 de nov. de 2026Anthropic e o Claude afirmam ter provado a hipótese de Riemann; Stanford responde sem IA
- 21 de nov. de 2026Quatro regras de Karpathy para um agente de código em um único arquivo somam 232 mil estrelas no GitHub
- 21 de nov. de 2026Hotel avisou sobre invasão só após 9 dias, e o autor colocou Claude e Codex para caçar vulnerabilidades
- 21 de nov. de 2026A Amazon liberou o agente de IA AWS Quick com Claude de graça; o plano pago Plus custa US$ 25 por mês
Perguntas frequentes sobre a notícia
O que se sabe sobre O gargalo do RAG?
Com perguntas reais, o sistema costuma responder errado. Às vezes encontra o documento errado. Às vezes encontra o documento certo, mas extrai o trecho errado. Às vezes não recupera nada relevante, e o modelo alucina com toda a confiança. Parece que o problema é o modelo. Na verdade, o culpado é o retrieval. GPT-4 e Claude respondem muito bem quando recebem o contexto certo. Se o contexto estiver errado, a alucinação é garantida, por melhor que seja o modelo.
Quando o retrieval quebra?
O retrieval pode quebrar por dezenas de motivos. Os mais comuns: A divisão em chunks é grande ou pequena demais. Um chunk de 512 palavras pode capturar contexto vizinho em vez do trecho necessário. A pergunta é sobre a política de devolução, mas o chunk traz a descrição de uma tabela de tamanhos. Os embeddings foram gerados para dados em inglês, mas a pergunta está em russo. A distância semântica entre o vetor da pergunta e os vetores dos documentos é enorme, e não há correspondências.
O que se sabe sobre O preço do retrieval?
Otimizar o retrieval não é passatempo de entusiasta. É trabalho de verdade: uma ou duas semanas de um desenvolvedor dedicadas à análise vão revelar que o sistema está 30-40% abaixo da precisão esperada. A causa não é o modelo, e sim o fato de o retrieval buscar errado. Em projetos reais, é uma perda enorme: tempo gasto com RAG, dinheiro gasto com infraestrutura, e o sistema não funciona porque os vetores dos documentos não batem com os das perguntas.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.