Por que bots baseados em LLMs protegidos são tão hackeados: análise de 14 mil GPTs
Os LLMs base são protegidos contra ataques, mas os bots construídos sobre eles são vulneráveis. O culpado é a camada de orquestração: system prompts, RAG, ferramentas e webhooks. A análise de 14.904 GPTs personalizados mostrou que essa arquitetura em camadas se torna o ponto fraco diante dos atacantes.
Processado por IA de Habr AI; editado por Hamidun News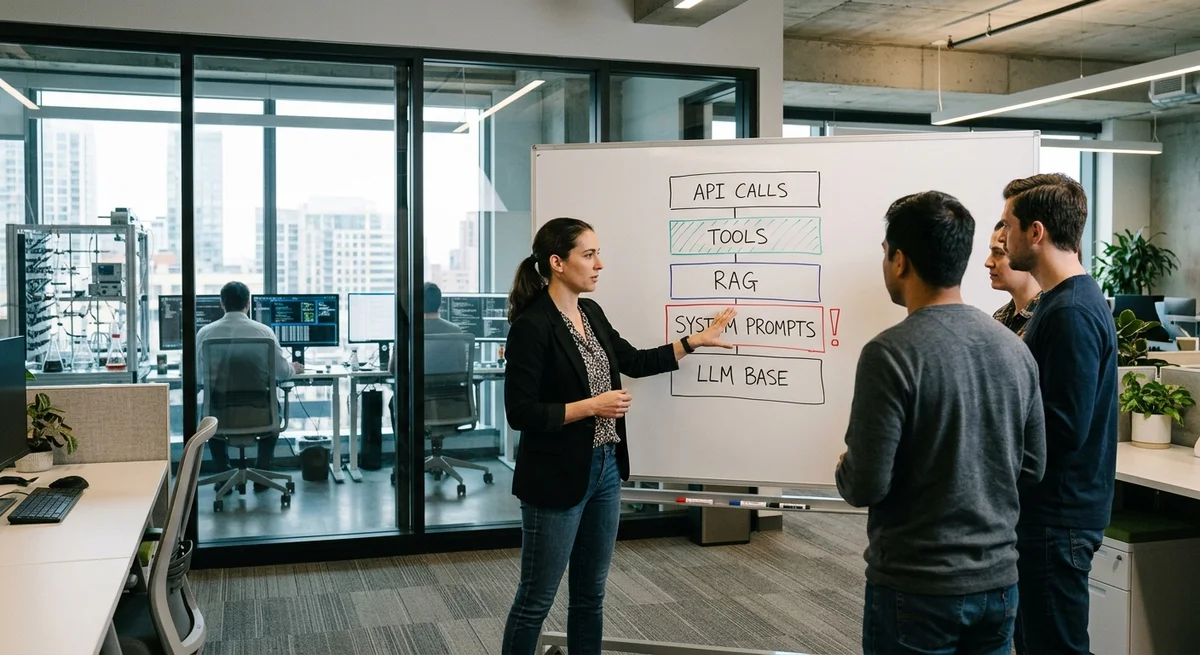
Um LLM base seguro não garante um bot seguro. Paradoxo? Não, é só arquitetura. Quando você pega um modelo protegido, como GPT ou Claude, e o envolve em um system prompt, além de adicionar RAG, ferramentas e APIs, surge uma nova superfície de ataque. Ela é chamada de camada de orquestração (orchestration layer), e é aí que bots são hackeados, mesmo com o modelo protegido.
Como o modelo base é protegido
Os LLMs base passam por um treinamento de segurança rigoroso: os autores os ensinam a recusar pedidos perigosos. As equipes da OpenAI, da Anthropic e de outras empresas gastam meses para que o modelo entenda quais solicitações não são seguras. Por cima disso vem o RLHF (aprendizado por reforço com feedback humano), que alinha o modelo às preferências humanas sobre o que é ético e o que não é. O resultado: se você pedir diretamente ao GPT que hackeie um site ou revele dados pessoais, ele vai recusar.
Onde os problemas começam
Mas assim que você envolve o modelo em um bot, seja um bot de Telegram, um aplicativo web ou um agente de IA, entra toda uma camada de componentes, cada um potencialmente inseguro:
- System prompts: instruções ao bot que às vezes sobrescrevem o treinamento do modelo e podem sofrer injeção
- Memória de conversa: o histórico de pedidos, que cresce e pode ser usado em um ataque contextual
- RAG (Retrieval-Augmented Generation): bancos de dados e documentos externos que podem ser contaminados com dados falsos
- Ferramentas e chamadas de função: acesso direto a APIs, e-mail, bancos de dados e sistemas de pagamento
- Lógica de webhooks e serviços externos: fontes de dados não confiáveis que podem ser comprometidas
Cada camada adiciona um novo vetor de ataque. Um system prompt pode sofrer injeção por meio da entrada do usuário. A memória de conversa pode ser entupida com padrões de prompt injection. O RAG pode devolver dados envenenados de uma fonte comprometida. As ferramentas podem ser usadas para contornar as restrições do modelo.
O que a análise mostrou
Pesquisadores com trabalho no arXiv analisaram 14.904 GPTs personalizados, agentes públicos criados por usuários na plataforma da OpenAI. O resultado: a grande maioria é vulnerável a ataques básicos à camada de orquestração. O atacante não precisa hackear o modelo em si; basta injetar o system prompt ou envenenar uma fonte de RAG.
A maioria das vulnerabilidades está não no modelo, mas na forma como ele é envolvido.
Ou seja, você pode usar o LLM mais seguro do planeta, mas uma arquitetura incorreta anulará suas vantagens. Os bots ficam mais frágeis ao escalar, porque cada novo componente adiciona complexidade e novos pontos de entrada.
O que isso significa
A segurança de um bot de IA não é só escolher o modelo; é uma tarefa arquitetural abrangente. É preciso proteger os system prompts contra injeções, validar os dados de entrada, controlar as fontes de RAG, limitar as permissões das ferramentas e registrar todas as ações. Do contrário, um belo LLM vira um belo buraco de segurança.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise de dados na base 1C e vira plano B caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Perguntas frequentes sobre a notícia
Como o modelo base é protegido?
Os LLMs base passam por um treinamento de segurança rigoroso: os autores os ensinam a recusar pedidos perigosos. As equipes da OpenAI, da Anthropic e de outras empresas gastam meses para que o modelo entenda quais solicitações não são seguras. Por cima disso vem o RLHF (aprendizado por reforço com feedback humano), que alinha o modelo às preferências humanas sobre o que é ético e o que não é. O resultado: se você pedir diretamente ao GPT que hackeie um site ou revele dados pessoais, ele vai recusar.
Onde os problemas começam?
Mas assim que você envolve o modelo em um bot, seja um bot de Telegram, um aplicativo web ou um agente de IA, entra toda uma camada de componentes, cada um potencialmente inseguro: System prompts: instruções ao bot que às vezes sobrescrevem o treinamento do modelo e podem sofrer injeção Memória de conversa: o histórico de pedidos, que cresce e pode ser usado em um ataque contextual RAG (Retrieval-Augmented Generation): bancos de dados e documentos externos que podem ser contaminados com dados falsos Ferramentas e chamadas de função: acesso direto a APIs, e-mail, bancos de d
O que a análise mostrou?
Pesquisadores com trabalho no arXiv analisaram 14.904 GPTs personalizados, agentes públicos criados por usuários na plataforma da OpenAI. O resultado: a grande maioria é vulnerável a ataques básicos à camada de orquestração. O atacante não precisa hackear o modelo em si; basta injetar o system prompt ou envenenar uma fonte de RAG. A maioria das vulnerabilidades está não no modelo, mas na forma como ele é envolvido. Ou seja, você pode usar o LLM mais seguro do planeta, mas uma arquitetura incorreta anulará suas vantagens. Os bots ficam mais frágeis ao escalar, porque cada no
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.