Três modelos de IA no lugar de tabelas de BI: como analisar o lucro dos produtos no Ozon
Vendedores de e-commerce conhecem o problema: o produto está no topo em faturamento, mas não sobra dinheiro. A culpa é a cegueira financeira. O SKUmind analisa o lucro de cada produto no Ozon com três modelos de IA de fornecedores diferentes. Eles funcionam como um painel de especialistas e conferem o trabalho uns dos outros.
Processado por IA de Habr AI; editado por Hamidun News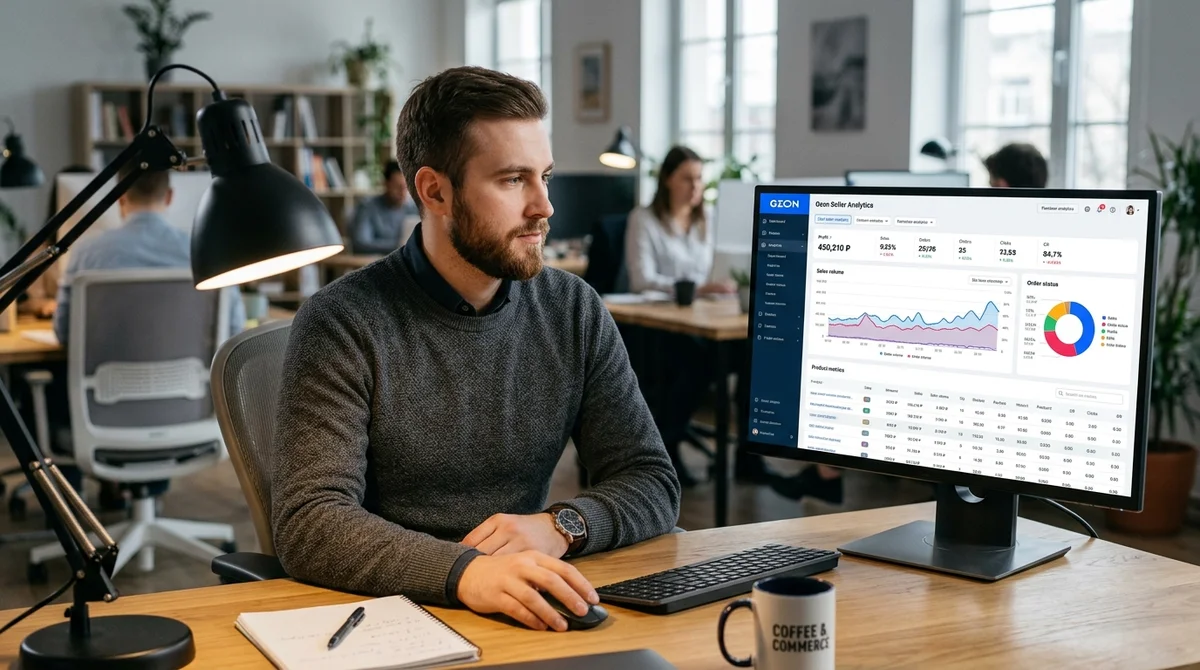
Um vendedor do Ozon vê que seu produto está no topo: o faturamento cresce e o catálogo vai bem. Mas no fim do mês o dinheiro, por algum motivo, não chega. Não porque não haja faturamento, mas porque não está claro para onde ele foi depois das comissões do marketplace, das devoluções e dos gastos com publicidade.
Por que as tabelas de BI não resolvem o problema
É um problema de quase todo vendedor de e-commerce com um catálogo grande. Com 500–2000 itens, calcular um P&L completo à mão leva horas por semana, e na maioria dos casos ninguém faz isso. Um produto pode ir bem em faturamento e estar no prejuízo na margem real por anos, sem que ninguém perceba.
Ferramentas de análise existem no mercado há muito tempo. Mas quase todas só exibem, de forma bonita, muitos números em tabelas. Há muita informação, mas nenhuma resposta para a pergunta principal: o que eu faço com isso agora? Os sistemas de BI clássicos funcionam com regras rígidas e configurações predefinidas. Não são flexíveis, não olham o contexto de cada produto e não dão conselhos.
Um painel de três modelos de IA
O SKUmind enfrenta o problema não com um modelo, mas com um painel de três diferentes. O mercado tem vários modelos de IA: Claude, GPT e outros. Cada um é treinado de um jeito e enxerga a tarefa por uma lente diferente. A ideia é simples: dar os mesmos dados aos três, e cada um opina de forma independente. Depois, um árbitro especial, também uma IA, verifica onde as opiniões coincidem e onde divergem, e escolhe a conclusão mais confiável.
Por que três? Porque um modelo pode começar a alucinar e inventar fatos. Um segundo pode ser conservador demais e ver riscos que na verdade não existem. Um terceiro pode deixar passar um detalhe importante. Com vários, cada um confere o outro e encontra erros. É como uma junta médica numa clínica: um médico vê uma coisa, o segundo vê outra, e o terceiro percebe o que os dois primeiros deixaram passar. O diagnóstico fica mais confiável do que quando uma só pessoa examina o caso.
Cada um dos três modelos analisa, por produto:
- A margem real depois de todas as comissões do marketplace e das devoluções
- A eficiência de cada rublo gasto em publicidade
- O potencial de preço: se os preços estão acima ou abaixo do ideal
- Tendências sazonais e volatilidade da demanda ao longo do tempo
- Recomendações concretas sobre o que precisa mudar com urgência
Implementação: API e uma longa revisão de código
Por dentro, tudo se mostrou bem mais complicado do que parecia no início. O Ozon não publica todas as métricas e números necessários pela API oficial. Foi preciso reconstruir a lógica manualmente, a partir da análise do tráfego de requisições. Ajudou poder rodar duas sessões do Claude em paralelo, dar a elas a mesma tarefa para examinar por ângulos diferentes e depois comparar os resultados.
Quando a lógica da aplicação finalmente se firmou, começou a parte mais longa e tediosa: a revisão de código. Como o sistema afeta diretamente as decisões financeiras das pessoas, cada linha e cada algoritmo precisam ser verificados com rigor. Hoje a revisão de código consome 60–70% de todo o tempo de desenvolvimento. É um processo longo e cansativo, mas totalmente justificado quando se lida com o dinheiro dos outros.
O que isso muda na indústria
A IA deixa de ser experimento e vira ferramenta de trabalho de verdade. Tabelas de BI estáticas, baseadas em regras rígidas predefinidas, são coisa do passado. No lugar delas entram modelos capazes de raciocinar com flexibilidade, como uma pessoa. Para o e-commerce, isso significa que a transparência financeira deixa de ser luxo de especialistas e passa a ser um padrão acessível a qualquer vendedor com um catálogo grande.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Perguntas frequentes sobre a notícia
Por que as tabelas de BI não resolvem o problema?
É um problema de quase todo vendedor de e-commerce com um catálogo grande. Com 500–2000 itens, calcular um P&L completo à mão leva horas por semana, e na maioria dos casos ninguém faz isso. Um produto pode ir bem em faturamento e estar no prejuízo na margem real por anos, sem que ninguém perceba. Ferramentas de análise existem no mercado há muito tempo. Mas quase todas só exibem, de forma bonita, muitos números em tabelas. Há muita informação, mas nenhuma resposta para a pergunta principal: o que eu faço com isso agora? Os sistemas de BI clássicos funcionam com regras rígid
O que se sabe sobre Um painel de três modelos de IA?
O SKUmind enfrenta o problema não com um modelo, mas com um painel de três diferentes. O mercado tem vários modelos de IA: Claude, GPT e outros. Cada um é treinado de um jeito e enxerga a tarefa por uma lente diferente. A ideia é simples: dar os mesmos dados aos três, e cada um opina de forma independente. Depois, um árbitro especial, também uma IA, verifica onde as opiniões coincidem e onde divergem, e escolhe a conclusão mais confiável. Por que três? Porque um modelo pode começar a alucinar e inventar fatos. Um segundo pode ser conservador demais e ver riscos que na verda
O que se sabe sobre Implementação: API e uma longa revisão de código?
Por dentro, tudo se mostrou bem mais complicado do que parecia no início. O Ozon não publica todas as métricas e números necessários pela API oficial. Foi preciso reconstruir a lógica manualmente, a partir da análise do tráfego de requisições. Ajudou poder rodar duas sessões do Claude em paralelo, dar a elas a mesma tarefa para examinar por ângulos diferentes e depois comparar os resultados. Quando a lógica da aplicação finalmente se firmou, começou a parte mais longa e tediosa: a revisão de código. Como o sistema afeta diretamente as decisões financeiras das pessoas, cada
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.