Por que o GPT erra ao contar letras: o segredo da tokenização
LLMs processam texto como uma sequência de tokens numéricos, e não como letras individuais. Isso explica um paradoxo curioso: o GPT pode se confundir facilmente ao contar as letras de palavras como strawberry. Entender a tokenização ajuda a escrever prompts mais eficientes, prever com precisão o comportamento estranho dos modelos, otimizar a janela de contexto e lidar com textos multilíngues.
Processado por IA de Habr AI; editado por Hamidun News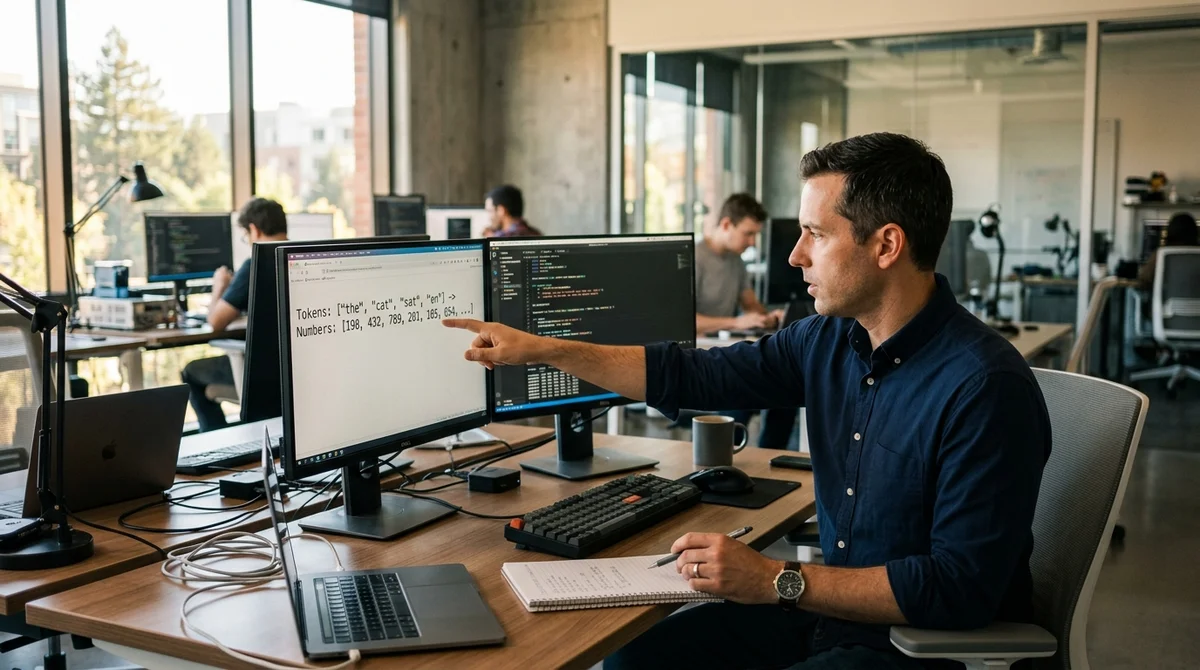
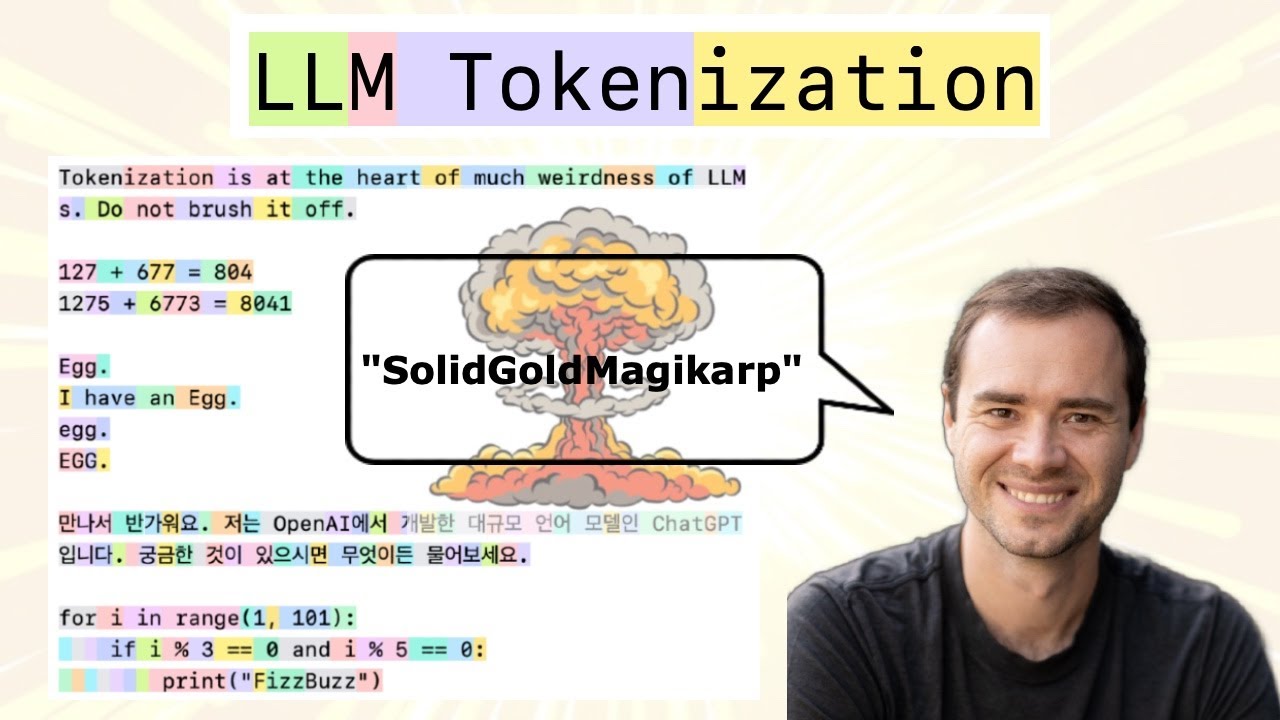
Quando você escreve um prompt no ChatGPT, vê um texto comum, formado por letras. O modelo, porém, vê algo bem diferente: uma sequência de números chamados tokens. Essa diferença gera efeitos estranhos. O GPT pode não saber quantas letras tem a palavra strawberry ou se confundir numa contagem simples.
Como os LLMs enxergam o texto
Para uma rede neural, texto não é um conjunto de letras, e sim uma sequência de códigos numéricos. Cada token corresponde a um número, e o modelo trabalha apenas com números, sem nunca ver a letra em si. É como ler um livro por meio de um sistema que primeiro converte as palavras em códigos; você processa esses códigos, e depois eles são convertidos de volta em texto.
Uma palavra frequente pode virar um único token, enquanto uma palavra rara é quebrada em vários pedaços. Por exemplo, «hello» é codificada por um único número, já «strawberry» pode ocupar três ou quatro números. No russo, a situação é ainda mais complicada: por causa da morfologia rica, as palavras são divididas de forma menos eficiente.
Por que isso causa problemas
O descompasso entre a forma como as pessoas veem o texto e a forma como o modelo o enxerga gera uma série de problemas:
- Erros de contagem: o GPT não consegue simplesmente contar letras, porque trabalha com números, e não com caracteres
- Dificuldade com palavras raras: combinações de letras pouco comuns são divididas em vários tokens, e o modelo as enxerga como pedaços separados
- Assimetria entre idiomas: o inglês é tokenizado de forma mais eficiente do que o russo, o chinês ou o árabe
- Consumo de contexto: se uma palavra vira 3 tokens em vez de 1, seu prompt ocupa mais espaço na janela de contexto
- Comportamento imprevisível: o modelo pode se comportar de forma estranha com números, códigos e nomes raros, porque eles são fragmentados
O algoritmo nos bastidores
Por trás da tokenização está o algoritmo Byte Pair Encoding (BPE). Funciona assim: primeiro, o texto é dividido de modo que cada caractere seja um token separado. Em seguida, o algoritmo identifica quais pares de caracteres aparecem com mais frequência e os une em um novo token. Depois, busca os pares mais frequentes entre os tokens resultantes e os une de novo. O processo se repete milhares de vezes.
No fim, o vocabulário do GPT reúne cerca de 50 mil tokens. Palavras e trechos de palavras frequentes viram tokens próprios, enquanto combinações de letras raras continuam fragmentadas. Não é perfeito, mas é mais eficiente do que codificar cada letra separadamente.
O que isso significa
Entender a tokenização muda a forma de trabalhar com LLMs. Se você sabe que o modelo vai se confundir ao contar letras, pode pedir que ele trabalhe de outro jeito — por exemplo, listar as letras separadamente primeiro e só depois contá-las. Não é uma solução milagrosa, mas ajuda a escrever prompts mais confiáveis.
Conhecer a tokenização também é útil para otimizar prompts longos: dá para prever onde o modelo vai «gastar» tokens à toa. Isso importa para qualquer pessoa que trabalhe com LLMs a fundo, de engenheiros de prompt a desenvolvedores de aplicações baseadas em redes neurais.
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
Perguntas frequentes sobre a notícia
Como os LLMs enxergam o texto?
Para uma rede neural, texto não é um conjunto de letras, e sim uma sequência de códigos numéricos. Cada token corresponde a um número, e o modelo trabalha apenas com números, sem nunca ver a letra em si. É como ler um livro por meio de um sistema que primeiro converte as palavras em códigos; você processa esses códigos, e depois eles são convertidos de volta em texto. Uma palavra frequente pode virar um único token, enquanto uma palavra rara é quebrada em vários pedaços. Por exemplo, «hello» é codificada por um único número, já «strawberry» pode ocupar três ou quatro número
Por que isso causa problemas?
O descompasso entre a forma como as pessoas veem o texto e a forma como o modelo o enxerga gera uma série de problemas: Erros de contagem: o GPT não consegue simplesmente contar letras, porque trabalha com números, e não com caracteres Dificuldade com palavras raras: combinações de letras pouco comuns são divididas em vários tokens, e o modelo as enxerga como pedaços separados Assimetria entre idiomas: o inglês é tokenizado de forma mais eficiente do que o russo, o chinês ou o árabe Consumo de contexto: se uma palavra vira 3 tokens em vez de 1, seu prompt ocupa mais espaço
O que se sabe sobre O algoritmo nos bastidores?
Por trás da tokenização está o algoritmo Byte Pair Encoding (BPE). Funciona assim: primeiro, o texto é dividido de modo que cada caractere seja um token separado. Em seguida, o algoritmo identifica quais pares de caracteres aparecem com mais frequência e os une em um novo token. Depois, busca os pares mais frequentes entre os tokens resultantes e os une de novo. O processo se repete milhares de vezes. No fim, o vocabulário do GPT reúne cerca de 50 mil tokens. Palavras e trechos de palavras frequentes viram tokens próprios, enquanto combinações de letras raras continuam frag
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.