OpenAI diz que o ChatGPT aprendeu a contar letras, mas ainda erra em palavras simples
A OpenAI anunciou que o ChatGPT finalmente aprendeu a contar corretamente as letras da palavra strawberry e lida melhor com pegadinhas lógicas simples. Mas ainda é cedo para comemorar: usuários logo encontraram exemplos quase idênticos em que o bot volta a errar com confiança e ainda discute com o interlocutor. Ao que parece, a empresa tapou alguns casos virados meme, em vez de eliminar o problema de fundo: as alucinações e a fraca análise em nível de letras.
Processado por IA de 3DNews AI; editado por Hamidun News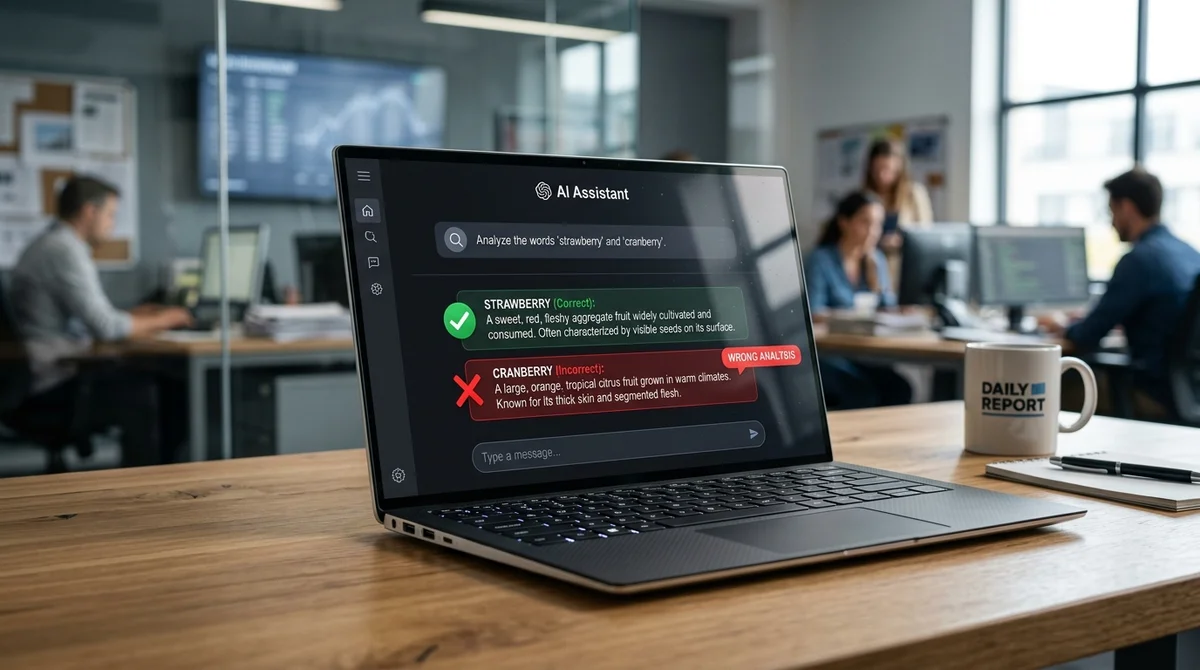
A OpenAI afirmou que o ChatGPT finalmente aprendeu a responder corretamente quantas letras R há na palavra strawberry, um dos testes de bom senso mais conhecidos para chatbots de IA. Mas quase imediatamente, usuários mostraram que o modelo ainda erra em tarefas quase idênticas, e com a mesma confiança de antes.
O que exatamente foi corrigido
A pergunta sobre strawberry virou há tempos um meme sobre grandes modelos de linguagem. Para uma pessoa, a tarefa é trivial: basta contar as letras. Mas o ChatGPT respondeu errado com frequência por muito tempo e podia insistir que a palavra não tem três letras R.
Houve algo parecido com outra pergunta popular: "Quero lavar o carro hoje, mas o lava-rápido fica a apenas 50 metros. Devo ir a pé para chegar lá de carro?". Em vez de notar o absurdo lógico da frase, o bot muitas vezes aconselhava ir a pé para depois ir de carro.
Em 28 de abril de 2026, a OpenAI escreveu no X que os dois casos finalmente foram corrigidos, e apresentou isso como uma vitória pequena, mas simbólica, sobre antigos memes do ChatGPT. A mensagem era simples: o modelo lida melhor com lógica elementar e análise de letras, onde antes tropeçava. Mas o efeito do anúncio se dissipou rápido, porque usuários começaram logo a testar formulações vizinhas para ver até onde vai a correção.
"Finalmente"
Onde o bot falha
O exemplo mais revelador é a palavra cranberry. Perguntado quantas letras r há nela, o ChatGPT, segundo usuários, ainda costuma responder que a letra aparece uma vez. Está errado: são duas. Ou seja, o modelo pode passar em um teste viral e falhar em outro quase igual um minuto depois. Por isso muitos suspeitaram que a OpenAI não resolveu o problema de fundo, apenas tapou alguns cenários visíveis demais.
- Em strawberry, o modelo agora conta as letras certo com mais frequência
- A pergunta do lava-rápido a 50 metros também passou a ter uma resposta mais lógica
- Em cranberry, o bot ainda pode informar com confiança o número errado de letras
- Depois de corrigido, o modelo pode não admitir o erro de imediato e continuar discutindo
Daí surgiu a hipótese de remendos pontuais, possivelmente escritos à mão. Se o modelo assimilou uma regra geral, deveria aplicá-la da mesma forma a palavras e tarefas parecidas, e não passar apenas em testes virais já conhecidos. Desse ponto de vista, uma resposta certa isolada não prova quase nada: o que importa não é a correção de um meme específico, mas a transferência da lógica para casos próximos sem ajuste manual.
Por que isso importa
A história só parece engraçada na superfície. Um erro ao contar letras é inofensivo por si só, mas mostra uma característica mais incômoda dos sistemas de IA atuais: eles podem dizer falsidades com confiança e sem alarmes internos. O modelo não diz "não tenho certeza" e nem sempre percebe a contradição, mesmo após um esclarecimento. Assim, o usuário recebe não só uma resposta imprecisa, mas uma que parece convincente.
Do ponto de vista técnico, isso não é tão surpreendente. Grandes modelos de linguagem são ótimos em prever uma continuação plausível de texto, mas não são obrigados a executar de forma estável operações simbólicas ou verificações lógicas rigorosas em cada caso parecido. Por isso, uma falha no nível de uma única letra não é uma curiosidade isolada, mas sintoma de uma limitação mais geral. O mesmo padrão pode aparecer em resumos de documentos, conselhos, sínteses, comparações de números e em qualquer tarefa que exija não uma fala fluida, mas uma verificação interna precisa do resultado.
O que isso significa
Para a OpenAI, a história é um lembrete de que os usuários já avaliam o modelo não por anúncios bonitos, mas pela estabilidade em exemplos vizinhos. Se o ChatGPT foi corrigido apenas para um par de pedidos virais, a confiança quase não cresce. Para o usuário comum, a conclusão é simples: mesmo quando o bot supera com confiança uma pegadinha conhecida, suas respostas a tarefas simples de letras, números e lógica ainda precisam ser conferidas.
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
Perguntas frequentes sobre a notícia
O que exatamente foi corrigido?
A pergunta sobre strawberry virou há tempos um meme sobre grandes modelos de linguagem. Para uma pessoa, a tarefa é trivial: basta contar as letras. Mas o ChatGPT respondeu errado com frequência por muito tempo e podia insistir que a palavra não tem três letras R. Houve algo parecido com outra pergunta popular: "Quero lavar o carro hoje, mas o lava-rápido fica a apenas 50 metros. Devo ir a pé para chegar lá de carro?". Em vez de notar o absurdo lógico da frase, o bot muitas vezes aconselhava ir a pé para depois ir de carro. Em 28 de abril de 2026, a OpenAI escreveu no X que
Onde o bot falha?
O exemplo mais revelador é a palavra cranberry. Perguntado quantas letras r há nela, o ChatGPT, segundo usuários, ainda costuma responder que a letra aparece uma vez. Está errado: são duas. Ou seja, o modelo pode passar em um teste viral e falhar em outro quase igual um minuto depois. Por isso muitos suspeitaram que a OpenAI não resolveu o problema de fundo, apenas tapou alguns cenários visíveis demais. Em strawberry, o modelo agora conta as letras certo com mais frequência A pergunta do lava-rápido a 50 metros também passou a ter uma resposta mais lógica Em cranberry, o bo
Por que isso importa?
A história só parece engraçada na superfície. Um erro ao contar letras é inofensivo por si só, mas mostra uma característica mais incômoda dos sistemas de IA atuais: eles podem dizer falsidades com confiança e sem alarmes internos. O modelo não diz "não tenho certeza" e nem sempre percebe a contradição, mesmo após um esclarecimento. Assim, o usuário recebe não só uma resposta imprecisa, mas uma que parece convincente. Do ponto de vista técnico, isso não é tão surpreendente. Grandes modelos de linguagem são ótimos em prever uma continuação plausível de texto, mas não são obr
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.