Agregadores de LLM: como escolher modelos gratuitos que funcionam e não mentir sobre o resultado
Escolher um modelo gratuito em uma lista parece simples. Na prática, metade dos modelos é instável, alguns somem da lista do provedor e a qualidade varia. A solução não é um catálogo infinito, mas um backend mais inteligente: limpeza da lista, health checks, fallback entre marcas e um campo `actual_model` honesto na resposta.
Processado por IA de Habr AI; editado por Hamidun News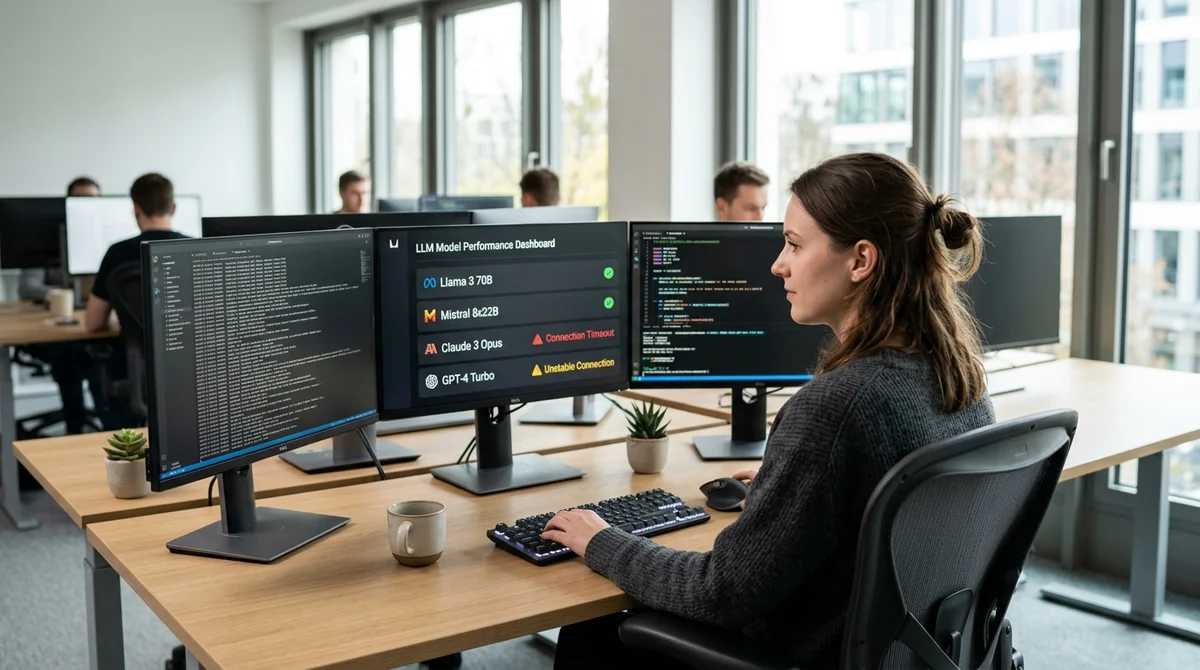
Quando um projeto ganha um seletor de LLM, o mais comum é seguir o caminho mais óbvio: uma lista grande de modelos, o usuário escolhe um e a requisição é enviada. No curto prazo, funciona. No longo prazo, começa a quebrar.
Onde a abordagem simples falha
Os problemas aparecem não na interface, mas no comportamento dos provedores e dos próprios modelos:
- Modelos gratuitos instáveis — constam como gratuitos, mas respondem de forma irregular e saem do ar durante o downtime do provedor
- Modelos que desaparecem — ontem estavam na lista; hoje o provedor removeu ou fechou para novos usuários
- Queda de qualidade — formalmente ativo, mas serve apenas para demos ou tarefas simples
- Descompasso entre frontend e backend — a lista na interface está desatualizada em um ou dois dias, enquanto o backend conhece outra realidade
- Erros e redirecionamento — pediu-se um modelo e veio um erro, ou a resposta veio de um modelo completamente diferente
O maior problema: a interface não sabe qual modelo realmente respondeu. O usuário escolheu o Claude 3.5, mas a resposta veio do Gemini, e ele não fica sabendo. Isso gera confusão: se a qualidade da resposta não corresponde ao modelo escolhido, o usuário perde a confiança.
Um circuito de engenharia rígido no lugar de um catálogo
A solução não se baseia em uma lista infinita, mas no controle no backend:
Passo 1: limpeza da lista. O backend recebe a lista bruta de modelos do provedor e a filtra: mantém apenas as opções gratuitas adequadas, descarta as instáveis e remove duplicatas. É possível adicionar health checks, que consultam periodicamente cada modelo para ver se está vivo.
Passo 2: um modelo por marca. Mesmo que a OpenAI tenha 5 modelos gratuitos na lista, apenas um vai para o frontend: o mais estável. Isso simplifica a escolha do usuário e reduz a chance de cair em um modelo ruim.
Passo 3: fallback entre marcas. Durante uma requisição real, se o primeiro modelo retornar erro, o sistema tenta automaticamente o segundo e depois o terceiro. O usuário não fica sabendo da falha; para ele, apenas demora um pouco mais.
Passo 4: honestidade na resposta. Retorna-se não só o texto gerado, mas também actual_model, o modelo que realmente o gerou. Assim, a interface pode dizer ao usuário com honestidade: "Resposta do GPT 4o mini, porque o modelo principal estava em downtime".
"O problema não é como mostrar bem uma lista de modelos.
O problema é como construir um sistema que escolhe modelos gratuitos que funcionam e não mente sobre o resultado" — essa é a essência da tarefa.
Isso transforma um catálogo instável em um circuito previsível. Se um provedor remove um modelo, o backend percebe na verificação seguinte e atualiza a lista no frontend. Se um modelo cai, o fallback entra em ação e o usuário recebe a resposta de outro provedor.
O que isso significa
Escolher um LLM deixa de ser uma tarefa de interface e passa a ser uma tarefa de engenharia, com limpeza de dados, health checks, lógica de fallback e rastreamento honesto. Para o produto, isso significa confiabilidade e menos dúvidas para o suporte. Para o usuário, a escolha funciona, as respostas chegam e a interface não mente.
- 2 de nov. de 2026Framework AICG, da NC State, reduz o MAE em 50,3% na correção de respostas de matemática
- 2 de nov. de 2026Verificamos 929 automações na Alpina: como deve ser o treinamento corporativo em IA em 2026
- 2 de nov. de 2026Interroguei 6 IAs sobre mim como um comprador corporativo: Amazon, esoterismo, «Telo Hudelo» e 5 brechas que fechamos em um dia
- 2 de nov. de 2026TJ Digital: 23% das páginas citadas por IA começam com resposta direta, contra 14% das não citadas
Perguntas frequentes sobre a notícia
Onde a abordagem simples falha?
Os problemas aparecem não na interface, mas no comportamento dos provedores e dos próprios modelos: Modelos gratuitos instáveis — constam como gratuitos, mas respondem de forma irregular e saem do ar durante o downtime do provedor Modelos que desaparecem — ontem estavam na lista; hoje o provedor removeu ou fechou para novos usuários Queda de qualidade — formalmente ativo, mas serve apenas para demos ou tarefas simples Descompasso entre frontend e backend — a lista na interface está desatualizada…
O que se sabe sobre Um circuito de engenharia rígido no lugar de um catálogo?
A solução não se baseia em uma lista infinita, mas no controle no backend: Passo 1: limpeza da lista. O backend recebe a lista bruta de modelos do provedor e a filtra: mantém apenas as opções gratuitas adequadas, descarta as instáveis e remove duplicatas. É possível adicionar health checks, que consultam periodicamente cada modelo para ver se está vivo. Passo 2: um modelo por marca. Mesmo que a OpenAI tenha 5 modelos gratuitos na lista, apenas um vai para o frontend: o mais estável.
O que isso significa?
Escolher um LLM deixa de ser uma tarefa de interface e passa a ser uma tarefa de engenharia, com limpeza de dados, health checks, lógica de fallback e rastreamento honesto. Para o produto, isso significa confiabilidade e menos dúvidas para o suporte. Para o usuário, a escolha funciona, as respostas chegam e a interface não mente.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.