Hugging Face acelera em 22% a inferência de LLMs com batching assíncrono
A Hugging Face trouxe assincronia para a inferência de LLMs. Em vez de se alternarem, CPU e GPU agora trabalham em paralelo: enquanto a GPU calcula um lote, a CPU prepara o próximo. O resultado é uma aceleração de 22%. Não há kernels novos. A mudança é uma reorganização dos streams do CUDA e da memória.
Processado por IA de Hugging Face Blog; editado por Hamidun News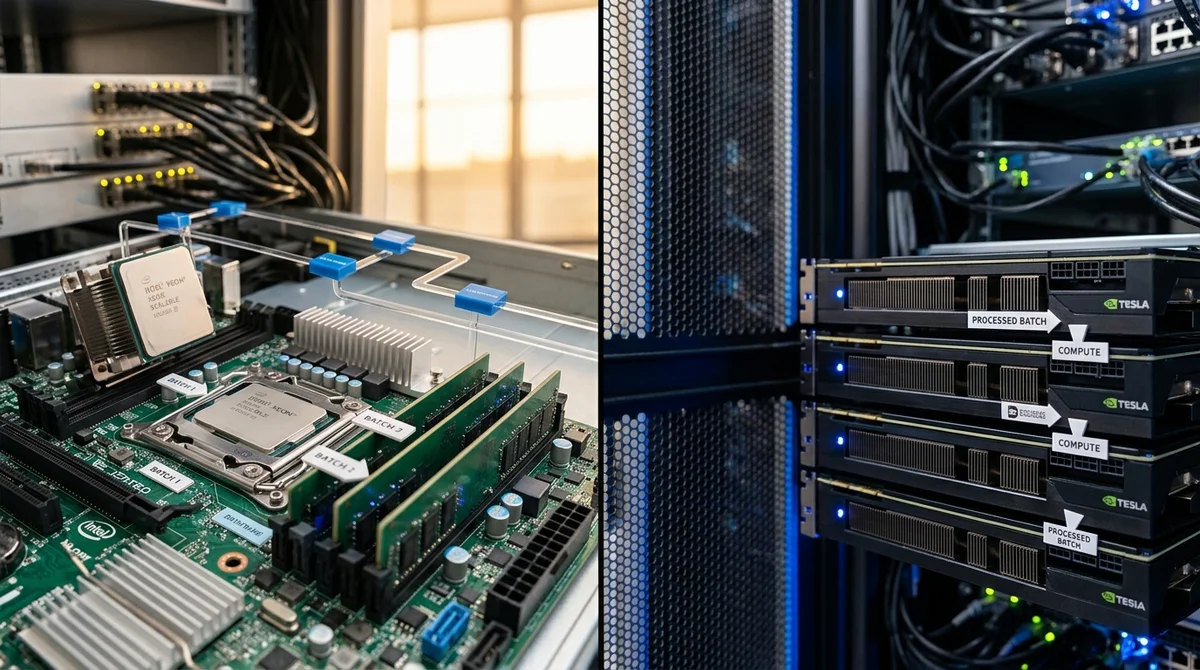
A Hugging Face encontrou uma forma simples de acelerar em 22% a geração de tokens em LLMs: fazer CPU e GPU trabalharem ao mesmo tempo, em vez de esperarem uma pela outra. Isso não exige retreinar os modelos nem novos algoritmos.
Qual era o problema
No batching síncrono tradicional, a CPU prepara os dados, depois a GPU os calcula, e então a CPU espera os resultados e prepara o próximo lote. A GPU fica ociosa por cerca de 24% do tempo, enquanto a CPU cuida do pré-processamento. É como uma linha de montagem em que, a cada etapa, alguém olha o relógio. Mesmo com a CPU a pleno vapor, ela é mais lenta que o cálculo mais simples da GPU, então a placa de vídeo fica parada esperando novos dados.
No batching síncrono, um modelo de 8 bilhões de parâmetros com lote de 32 gerava 8K tokens em 300 segundos, com a GPU ativa em apenas 76% do tempo.
Como a assincronia resolve o problema
A ideia é bem simples: executar CPU e GPU em paralelo por meio de streams do CUDA. São usados três streams independentes: um para enviar dados à GPU (H2D), um para os cálculos em si (Compute) e um para o envio de volta (D2H). Cada stream devolve o controle à CPU imediatamente, sem bloqueá-la.
Entre os streams ficam eventos do CUDA (events), marcadores que garantem a ordem correta:
- O stream H2D sinaliza quando os dados já foram carregados na GPU
- O stream Compute espera esse marcador, calcula e coloca o seu
- O stream D2H espera o fim dos cálculos e retira os resultados
Enquanto a GPU processa o lote N, a CPU já prepara o lote N+1 em outro buffer de memória. Sem espera: os dois trabalham em paralelo.
O grande truque: o carry-over
A dificuldade é que, quando uma requisição atravessa vários lotes, os tokens de saída do lote N viram a entrada do lote N+1. A Hugging Face resolveu isso com placeholders: ao preparar o lote N+1, ela coloca zeros no lugar das entradas dos tokens futuros e, quando o lote N termina, os zeros são substituídos pelos valores reais.
"Isso permite que a CPU prepare o próximo lote sem esperar os resultados do atual", explica a
Hugging Face.
Tudo se apoia em grafos CUDA com um pool de memória compartilhado, o que até economiza memória de vídeo.
Os números falam por si
Antes da otimização: GPU ativa em 76%, geração de 8K tokens em 300.6 segundos. Depois: GPU ativa em 99.4%, os mesmos tokens em 234.5 segundos. A aceleração de 22% está quase no limite para essa arquitetura (o máximo teórico era de 24%).
O que isso significa
Você não precisa de GPUs mais caras nem de retreinar modelos para obter um ganho de velocidade expressivo. O código já está na biblioteca Transformers, na classe `ContinuousBatchingAsyncIOs`. Para empresas que geram muitos tokens, isso pode economizar milhões em hardware.
- 2 de nov. de 2026Karpathy usa o Claude para criar o HackerTube, com 6454 vídeos recomendados no Hacker News
- 2 de nov. de 2026Microsoft lança Mage-VL-Cowork, modelo de 4B que resolve 66,0% das tarefas do OSWorld-Verified
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Pika Labs lança o H3 Flex, modelo de vídeo aberto: 6 passos em vez de 50
Perguntas frequentes sobre a notícia
O que se sabe sobre Qual era o problema?
No batching síncrono tradicional, a CPU prepara os dados, depois a GPU os calcula, e então a CPU espera os resultados e prepara o próximo lote. A GPU fica ociosa por cerca de 24% do tempo, enquanto a CPU cuida do pré-processamento. É como uma linha de montagem em que, a cada etapa, alguém olha o relógio. Mesmo com a CPU a pleno vapor, ela é mais lenta que o cálculo mais simples da GPU, então a placa de vídeo fica parada esperando novos dados. No batching síncrono, um modelo de 8 bilhões de parâmetros com lote de 32 gerava 8K tokens em 300 segundos, com a GPU ativa em apenas
Como a assincronia resolve o problema?
A ideia é bem simples: executar CPU e GPU em paralelo por meio de streams do CUDA. São usados três streams independentes: um para enviar dados à GPU (H2D), um para os cálculos em si (Compute) e um para o envio de volta (D2H). Cada stream devolve o controle à CPU imediatamente, sem bloqueá-la. Entre os streams ficam eventos do CUDA (events), marcadores que garantem a ordem correta: O stream H2D sinaliza quando os dados já foram carregados na GPU O stream Compute espera esse marcador, calcula e coloca o seu O stream D2H espera o fim dos cálculos e retira os resultados Enquant
O que se sabe sobre O grande truque: o carry-over?
A dificuldade é que, quando uma requisição atravessa vários lotes, os tokens de saída do lote N viram a entrada do lote N+1. A Hugging Face resolveu isso com placeholders: ao preparar o lote N+1, ela coloca zeros no lugar das entradas dos tokens futuros e, quando o lote N termina, os zeros são substituídos pelos valores reais. "Isso permite que a CPU prepare o próximo lote sem esperar os resultados do atual", explica a Hugging Face. Tudo se apoia em grafos CUDA com um pool de memória compartilhado, o que até economiza memória de vídeo.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.