OpenAI apresenta MRC, protocolo de rede para treinar IA em clusters de 100 mil GPUs
A OpenAI publicou, por meio do Open Compute Project, a especificação do MRC, um novo protocolo de rede para o treinamento de grandes modelos. Ele divide o tráfego de uma única troca de dados em centenas de caminhos, contorna falhas mais rápido e simplifica a arquitetura de rede. Segundo a empresa, o MRC já roda nos maiores clusters com NVIDIA GB200 e permite resistir a falhas de links e até à reinicialização de switches sem interromper o treinamento.
Processado por IA de OpenAI Blog; editado por Hamidun News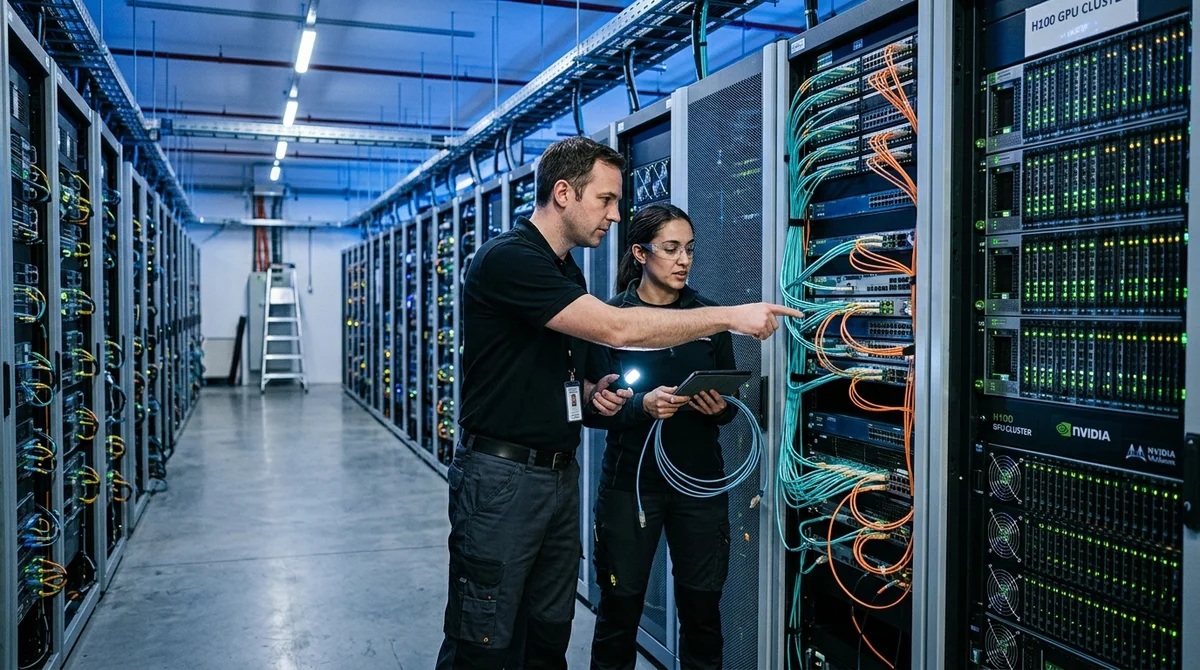
A OpenAI detalhou o MRC, um novo protocolo de rede para os supercomputadores que treinam grandes modelos de IA. Segundo a empresa, ele já está implantado em todos os seus maiores clusters com NVIDIA GB200, incluindo o site da OCI em Abilene e os sistemas Microsoft Fairwater, e ajuda a manter o desempenho mesmo quando links e switches falham.
Por que o MRC foi necessário
O treinamento de modelos de fronteira esbarra não só nas próprias GPUs, mas também na rede que as conecta. A cada passo do treinamento acontecem milhões de trocas de dados, e se um único pacote ou fluxo chega bem depois dos demais, parte dos aceleradores fica ociosa. Em clusters pequenos, esses atrasos ainda são toleráveis. Em sistemas do porte do Stargate, porém, o problema se torna sistêmico: quanto mais nós, maior a chance de congestionamento, jitter de latência e falhas de hardware.
Para a OpenAI, isso deixou de ser uma questão secundária de engenharia. A empresa afirma que o ChatGPT é usado por mais de 900 milhões de pessoas por semana, o que transforma a infraestrutura de computação na camada base do serviço. Por isso, nos últimos dois anos, a equipe reconstruiu a pilha de rede em parceria com AMD, Broadcom, Intel, Microsoft e NVIDIA. O objetivo ia além da alta velocidade: buscava-se um comportamento previsível sob carga e diante de falhas parciais.
Como a rede funciona
A ideia central do MRC é não tratar a interface de rede como um único tubo de 800 Gbit/s. Em vez disso, a OpenAI a divide em vários canais menores — por exemplo, oito linhas de 100 Gbit/s, cada uma ligada a um switch diferente. O resultado é uma rede multiplano, em que o mesmo tráfego pode seguir por muitos caminhos independentes. Nessa configuração, segundo estimativa da OpenAI, é possível montar uma rede com cerca de 131 mil GPUs usando apenas duas camadas de switches Ethernet, enquanto o esquema clássico de 800 Gbit/s exigiria três ou quatro camadas.
É aí que entra o protocolo, que estende a conhecida pilha RoCE para cargas de treinamento de IA. Em vez de enviar toda a troca por uma única rota, o MRC "pulveriza" os pacotes de uma mesma transferência por centenas de caminhos simultaneamente. Os pacotes podem chegar fora de ordem, o que não é um problema: cada um já traz o endereço final na memória, e o receptor posiciona os dados à medida que chegam. Com isso, a rede usa os canais disponíveis de forma mais equilibrada e lida bem melhor com congestionamentos locais.
- Uma única troca é dividida em vários caminhos paralelos por diferentes planos de rede
- Ao detectar sinais de congestionamento, o protocolo remove o caminho problemático e o substitui por outro
- Quando um pacote se perde, o MRC rapidamente assume uma falha e reenvia os dados
- Se o pacote se perde por congestionamento no lado do receptor, entra em cena o packet trimming — o envio apenas do cabeçalho para solicitar explicitamente a retransmissão
A OpenAI destaca que o MRC consegue contornar falhas de rede na escala de microssegundos, enquanto uma fabric tradicional podia levar segundos ou até dezenas de segundos para reconfigurar as rotas. Isso é especialmente importante no treinamento síncrono, em que cada passo de computação é ditado não pela transferência média, mas pela mais lenta do cluster. Com esse equilíbrio, várias tarefas podem compartilhar um mesmo cluster com menor risco de interferência entre si.
O que muda na operação
Outra mudança importante é o abandono do roteamento dinâmico tradicional em favor do source routing baseado em SRv6. Em uma rede comum, os próprios switches recalculam as rotas por meio de protocolos como o BGP, o que adiciona complexidade e novas classes de falha. No MRC, o remetente codifica o caminho do pacote no endereço IPv6, e os switches simplesmente executam essa rota, salto a salto, com base em tabelas estáticas. A ideia parece radical, mas, segundo a OpenAI, é justamente ela que simplifica o plano de controle e elimina a necessidade de corrigir manualmente a lógica da rede o tempo todo.
Para a OpenAI, a prática pesa mais que a teoria, e aqui a empresa apresenta números concretos. Ela afirma que suas redes de treinamento têm milhões de links e que, em execuções reais, podem ocorrer múltiplas quedas breves entre switches tier-0 e tier-1 a cada minuto — sem impacto mensurável no pretraining síncrono. Durante o treinamento de um dos modelos de fronteira recentes para o ChatGPT e o Codex, os engenheiros precisaram reiniciar quatro switches tier-1, e isso não exigiu coordenação com as equipes que conduziam o treinamento naquele momento.
Se uma interface de rede de oito portas perde uma porta, a largura de banda cai no máximo um oitavo, mas a tarefa continua rodando em vez de cair por completo.
O que isso significa
O MRC mostra que a corrida por modelos mais capazes está migrando cada vez mais para a infraestrutura. Além de acelerar o treinamento em seus próprios clusters, a OpenAI leva o protocolo ao Open Compute Project, na tentativa de transformar uma solução de engenharia interna em padrão do setor. Se outros laboratórios e provedores de nuvem adotarem a abordagem, grandes clusters de IA ficarão mais baratos, mais simples de operar e mais resistentes a falhas, sem ajustes manuais constantes na rede.
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
- 31 de out. de 2026Autor levou seu roteiro a um júri de IA: o veredito custou 850 mil tokens
- 31 de out. de 2026Anthropic: unir subagentes em um só ciclo fez as tarefas de um cliente rodarem duas vezes mais rápido
Perguntas frequentes sobre a notícia
Por que o MRC foi necessário?
O treinamento de modelos de fronteira esbarra não só nas próprias GPUs, mas também na rede que as conecta. A cada passo do treinamento acontecem milhões de trocas de dados, e se um único pacote ou fluxo chega bem depois dos demais, parte dos aceleradores fica ociosa. Em clusters pequenos, esses atrasos ainda são toleráveis. Em sistemas do porte do Stargate, porém, o problema se torna sistêmico: quanto mais nós, maior a chance de congestionamento, jitter de latência e falhas de hardware. Para a OpenAI, isso deixou de ser uma questão secundária de engenharia. A empresa afirma
Como a rede funciona?
A ideia central do MRC é não tratar a interface de rede como um único tubo de 800 Gbit/s. Em vez disso, a OpenAI a divide em vários canais menores — por exemplo, oito linhas de 100 Gbit/s, cada uma ligada a um switch diferente. O resultado é uma rede multiplano, em que o mesmo tráfego pode seguir por muitos caminhos independentes. Nessa configuração, segundo estimativa da OpenAI, é possível montar uma rede com cerca de 131 mil GPUs usando apenas duas camadas de switches Ethernet, enquanto o esquema clássico de 800 Gbit/s exigiria três ou quatro camadas. É aí que entra o pro
O que muda na operação?
Outra mudança importante é o abandono do roteamento dinâmico tradicional em favor do source routing baseado em SRv6. Em uma rede comum, os próprios switches recalculam as rotas por meio de protocolos como o BGP, o que adiciona complexidade e novas classes de falha. No MRC, o remetente codifica o caminho do pacote no endereço IPv6, e os switches simplesmente executam essa rota, salto a salto, com base em tabelas estáticas. A ideia parece radical, mas, segundo a OpenAI, é justamente ela que simplifica o plano de controle e elimina a necessidade de corrigir manualmente a lógic
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.