OpenAI apresenta o protocolo MRC para redes de supercomputadores com milhões de GPUs
A OpenAI, junto com AMD, Broadcom, Intel, Microsoft e NVIDIA, desenvolveu o protocolo MRC para redes de supercomputadores de AI. Ele distribui pacotes por centenas de caminhos ao mesmo tempo e se recupera de falhas em microssegundos. Isso permite construir supercomputadores com mais de 100 mil GPUs usando apenas 2 níveis de switches Ethernet.
Processado por IA de MarkTechPost; editado por Hamidun News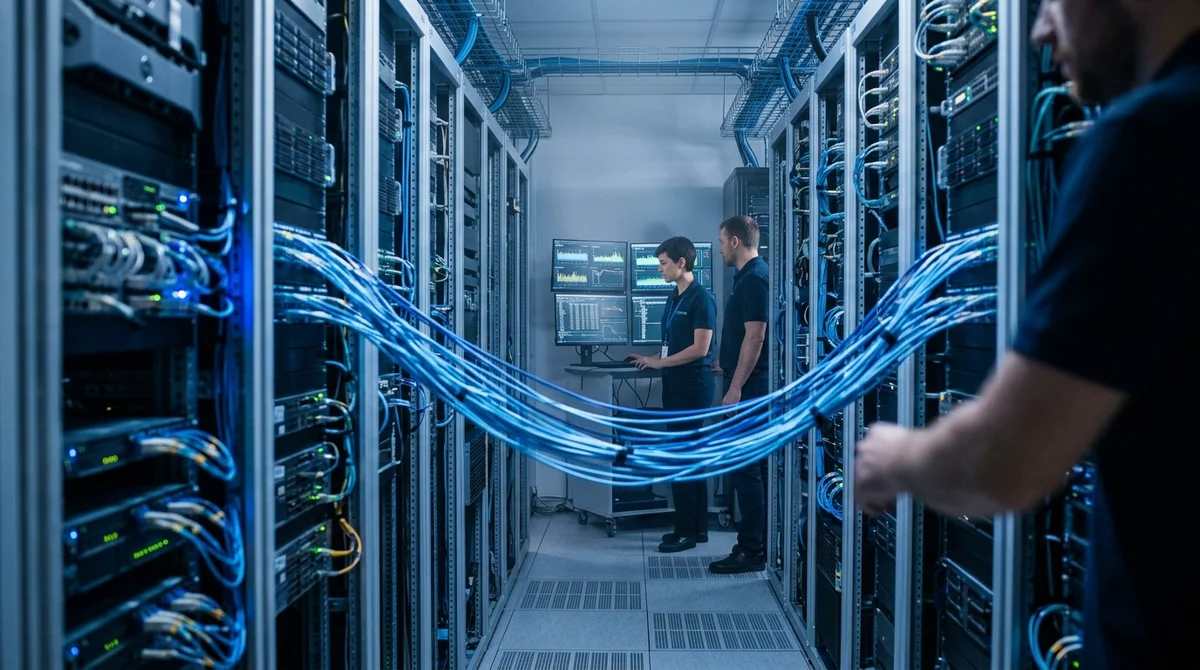
OpenAI, em colaboração com AMD, Broadcom, Intel, Microsoft e NVIDIA, apresentou o MRC (Multipath Reliable Connection) — um novo protocolo de rede aberto para grandes clusters de AI. O protocolo resolve um problema-chave: como construir um supercomputador com centenas de milhares de GPUs quando a confiabilidade da rede se torna um gargalo.
Como o MRC Funciona
O MRC distribui pacotes de dados por centenas de caminhos de rede simultaneamente. Isso significa que se um caminho falhar, os dados viajam por rotas alternativas sem perder velocidade. A recuperação de falhas ocorre em microssegundos — tão rápido que o treinamento da rede neural mal nota as interrupções. Os protocolos de rede tradicionais selecionam um caminho primário e comutam para um backup apenas se o primário falhar. O MRC funciona em um princípio fundamentalmente diferente: monitora centenas de caminhos potenciais em tempo real e distribui dinamicamente a carga entre canais saudáveis. É como a diferença entre uma única estrada com um desvio e uma rede de vielas onde os carros podem viajar por qualquer rota livre.
Vantagens Práticas
O principal sucesso do MRC é simplificar a arquitetura do supercomputador. Anteriormente, clusters com 100.000+ GPUs exigiam uma hierarquia de três níveis de comutadores Ethernet. Caro, complexo de montar e exige muita energia para resfriamento. O MRC permite apenas dois níveis, o que simplifica radicalmente o design e reduz os custos de equipamento.
- Menos equipamento de rede — montagem e manutenção simplificadas
- Latência de rede reduzida graças a caminhos mais diretos entre GPUs
- Redução no consumo de energia para resfriamento de comutadores
- Melhor escalabilidade — arquitetura funciona até milhões de GPUs
Padrão Aberto para o Ecossistema
O MRC não é uma solução fechada de uma empresa. OpenAI escolheu uma abordagem aberta e envolveu os principais fabricantes de equipamento de rede: AMD, Broadcom, Intel, Microsoft, NVIDIA. Isso significa que outras empresas, provedores de nuvem e centros de pesquisa poderão implementar o MRC em seus supercomputadores. A abertura do padrão é importante justamente porque nesses níveis de escala, até pequenas melhorias em confiabilidade e eficiência de rede afetam o custo do treinamento de modelos e a velocidade de desenvolvimento em toda a indústria de AI.
O Que Isso Significa
MRC é uma resposta ao desafio de escala. À medida que os modelos de AI crescem, aumentam as demandas sobre a infraestrutura computacional. A arquitetura de rede que funciona para um cluster de 10.000 GPUs pode se tornar um gargalo em 500.000 GPUs. O MRC permite construir supercomputadores ainda maiores sem uma revisão radical da arquitetura. Para a indústria, isso significa treinamento de modelos mais barato e implementação mais rápida de inovações.
- 30 de out. de 2026Claude Enterprise ganha relatórios inteligentes: quem usa IA, como usa e quanto isso custa
- 29 de out. de 2026TokenRouter acelera o roteamento token a token entre modelos em até 64 vezes
- 29 de out. de 2026Google abre o Android Studio a agentes de IA de terceiros: Claude, Codex e mais de 40 outros
- 29 de out. de 2026Claude Code edita vídeo a partir da transcrição: como funciona o video-use, com 30 000 estrelas
Perguntas frequentes sobre a notícia
Como o MRC Funciona?
O MRC distribui pacotes de dados por centenas de caminhos de rede simultaneamente. Isso significa que se um caminho falhar, os dados viajam por rotas alternativas sem perder velocidade. A recuperação de falhas ocorre em microssegundos — tão rápido que o treinamento da rede neural mal nota as interrupções. Os protocolos de rede tradicionais selecionam um caminho primário e comutam para um backup apenas se o primário falhar. O MRC funciona em um princípio fundamentalmente diferente: monitora centenas de caminhos potenciais em tempo real e distribui dinamicamente a carga entre
O que se sabe sobre Vantagens Práticas?
O principal sucesso do MRC é simplificar a arquitetura do supercomputador. Anteriormente, clusters com 100.000+ GPUs exigiam uma hierarquia de três níveis de comutadores Ethernet. Caro, complexo de montar e exige muita energia para resfriamento. O MRC permite apenas dois níveis, o que simplifica radicalmente o design e reduz os custos de equipamento. Menos equipamento de rede — montagem e manutenção simplificadas Latência de rede reduzida graças a caminhos mais diretos entre GPUs Redução no consumo de energia para resfriamento de comutadores Melhor escalabilidade — arquitet
O que se sabe sobre Padrão Aberto para o Ecossistema?
O MRC não é uma solução fechada de uma empresa. OpenAI escolheu uma abordagem aberta e envolveu os principais fabricantes de equipamento de rede: AMD, Broadcom, Intel, Microsoft, NVIDIA. Isso significa que outras empresas, provedores de nuvem e centros de pesquisa poderão implementar o MRC em seus supercomputadores. A abertura do padrão é importante justamente porque nesses níveis de escala, até pequenas melhorias em confiabilidade e eficiência de rede afetam o custo do treinamento de modelos e a velocidade de desenvolvimento em toda a indústria de AI.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.