Hugging Face lança o Ecom-RLVE, um simulador de treino para agentes de IA de lojas online
A Hugging Face lançou o Ecom-RLVE, um ambiente para treinar agentes de IA que ajudam a comprar produtos em lojas online. Ele traz oito cenários, da busca e montagem do carrinho até devoluções e rastreamento do pedido, além de recompensas verificáveis para precisão, eficiência e ausência de alucinações. Os primeiros testes indicam que essa abordagem revela falhas reais melhor do que os benchmarks de chat tradicionais.
Processado por IA de Hugging Face Blog; editado por Hamidun News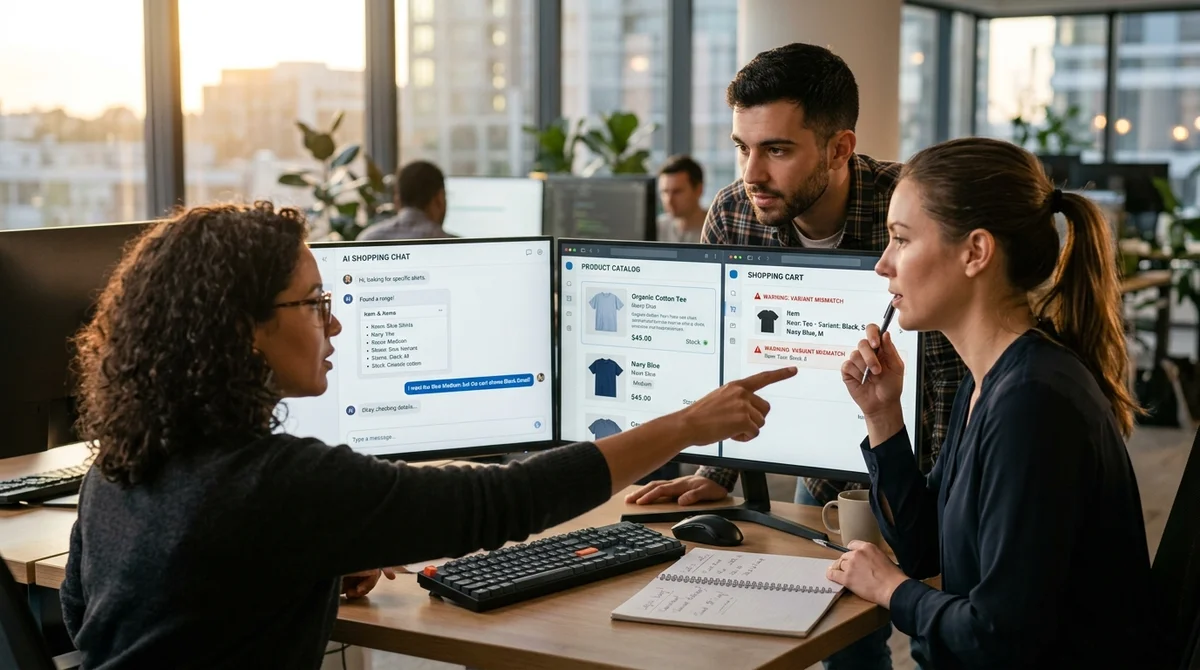
A Hugging Face lançou o Ecom-RLVE, um conjunto de ambientes verificáveis para treinar agentes conversacionais de IA que ajudam a comprar produtos em lojas online. O projeto leva o aprendizado por reforço das tarefas abstratas para cenários reais de vários passos: busca de produto, escolha de substituto, montagem do carrinho, devoluções e rastreamento do pedido.
Por que os benchmarks antigos não bastam
Os grandes modelos de linguagem aprenderam há tempos a soar convincentes, mas no e-commerce isso não basta. O usuário pode pedir não apenas para "encontrar um carregador", mas para escolher um modelo de até 25 dólares, com USB-C, entrega em dois dias e compatível com um dispositivo específico. Para o agente, isso deixa de ser uma resposta de chat e vira uma cadeia de ações: achar a página do produto, checar as restrições, escolher a variante certa, não trocar a quantidade e não inventar o que não existe no catálogo.
"Fluência na fala não é o mesmo que cumprir a tarefa."
É exatamente nessa lacuna que o Ecom-RLVE se apoia.
Os autores ampliam a ideia do RLVE-Gym, em que os modelos treinavam em tarefas verificáveis com recompensa exata, e a levam para o comércio conversacional. Em vez de avaliação subjetiva por uma pessoa ou por um LLM-as-a-judge, o ambiente confere o resultado por código: se o agente chegou ao produto certo, se escolheu corretamente o tamanho ou a variante, se criou a devolução do item certo e se ficou dentro do limite de passos.
Como o ambiente funciona
Cada episódio do Ecom-RLVE reúne uma tarefa oculta, um usuário simulado e um conjunto de ferramentas com as quais o agente trabalha. Ele não apenas escreve texto: chama funções, busca no catálogo, adiciona itens ao carrinho, faz perguntas de esclarecimento e só encerra o cenário quando o objetivo foi de fato atingido.
O ambiente cobre oito tipos de situação, de product discovery e product substitution a bundle planning, policy QA, order tracking e multi-intent journey. A recompensa combina vários componentes, para que o modelo aprenda não só a "parecer útil", mas a concluir a tarefa:
- recompensa pela execução correta da tarefa
- bônus por menos passos e menos chamadas de ferramentas
- penalidade por alucinações, como SKUs ou variantes inexistentes
- falha total em caso de ações inválidas e violação do formato de chamada
A dificuldade adaptativa merece destaque. Em vez de níveis fixos easy/medium/hard, o ambiente usa um número de dificuldade d, que controla 12 eixos ao mesmo tempo: quantidade de restrições, detalhes omitidos, produtos parecidos, erros de digitação, falta de estoque, mudança de intenção no meio da conversa e outras interferências. Isso permite montar um curriculum learning sem anotação manual e evita manter o modelo por tempo demais em tarefas que já ficaram triviais.
Onde o modelo falha
O artigo analisa em detalhe o cenário Cart Building, em que o agente precisa montar um carrinho com vários produtos, com variantes e quantidades exatas. Para impedir a memorização de padrões, os desenvolvedores sintetizam as variantes na hora: em eletrônicos pode ser o tipo de conector, em roupas o tamanho, em utensílios de cozinha o material ou a cor. Assim, o modelo precisa fazer mais do que "reconhecer o produto": tem de ligar de fato o pedido do usuário à modificação correta dentro do catálogo.
A equipe treinou o Qwen 3 8B nesse ambiente com o método DAPO por 300 passos na coleção C1, e o próprio benchmark prevê os modos C2, C4 e C8 para treinar com dois, quatro e oito ambientes. O catálogo foi escalado para dois milhões de produtos com um índice FAISS e embeddings gte-modernbert-base, e o simulador de usuário foi construído sobre o Qwen3.5-9.7B. Segundo os resultados, o agente conseguiu avançar de forma estável para episódios mais difíceis, e os erros ficaram bem visíveis: o modelo pode escolher o produto certo, mas errar a variante, esquecer um dos itens do pedido ou afirmar que a versão necessária não existe, embora a tivesse visto alguns passos antes.
O que isso significa
Para o mercado de compras com IA, é uma mudança importante: agora dá para competir não pela fluidez da conversa do bot, mas pela confiabilidade com que ele conclui a tarefa de compra. Se esses ambientes abertos pegarem, o setor terá uma forma mais honesta de treinar e comparar agentes de e-commerce: pela qualidade real das ações, e não pela impressão deixada pelo diálogo.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Pika Labs lança o H3 Flex, modelo de vídeo aberto: 6 passos em vez de 50
- 1 de nov. de 2026Tokenizador do BERT na Hugging Face fica 50 vezes mais rápido ao eliminar trabalho desnecessário com ASCII
- 1 de nov. de 2026Universidade de Illinois reúne 12 151 problemas abertos e testa se a IA consegue resolvê-los
Perguntas frequentes sobre a notícia
Por que os benchmarks antigos não bastam?
Os grandes modelos de linguagem aprenderam há tempos a soar convincentes, mas no e-commerce isso não basta. O usuário pode pedir não apenas para "encontrar um carregador", mas para escolher um modelo de até 25 dólares, com USB-C, entrega em dois dias e compatível com um dispositivo específico. Para o agente, isso deixa de ser uma resposta de chat e vira uma cadeia de ações: achar a página do produto, checar as restrições, escolher a variante certa, não trocar a quantidade e não inventar o que não existe no catálogo. "Fluência na fala não é o mesmo que cumprir a tarefa." É e
Como o ambiente funciona?
Cada episódio do Ecom-RLVE reúne uma tarefa oculta, um usuário simulado e um conjunto de ferramentas com as quais o agente trabalha. Ele não apenas escreve texto: chama funções, busca no catálogo, adiciona itens ao carrinho, faz perguntas de esclarecimento e só encerra o cenário quando o objetivo foi de fato atingido. O ambiente cobre oito tipos de situação, de product discovery e product substitution a bundle planning, policy QA, order tracking e multi-intent journey. A recompensa combina vários componentes, para que o modelo aprenda não só a "parecer útil", mas a concluir
Onde o modelo falha?
O artigo analisa em detalhe o cenário Cart Building, em que o agente precisa montar um carrinho com vários produtos, com variantes e quantidades exatas. Para impedir a memorização de padrões, os desenvolvedores sintetizam as variantes na hora: em eletrônicos pode ser o tipo de conector, em roupas o tamanho, em utensílios de cozinha o material ou a cor. Assim, o modelo precisa fazer mais do que "reconhecer o produto": tem de ligar de fato o pedido do usuário à modificação correta dentro do catálogo. A equipe treinou o Qwen 3 8B nesse ambiente com o método DAPO por 300 passos
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.