NVIDIA apresenta o Nemotron OCR v2: OCR multilíngue treinado com 12,2 milhões de documentos sintéticos
A NVIDIA detalhou o Nemotron OCR v2, um modelo de OCR multilíngue treinado principalmente com 12,2 milhões de documentos sintéticos. A aposta não é em uma arquitetura nova, mas em dados em grande escala: um único motor lê inglês, russo, japonês, coreano e chinês e, em uma A100, processa até 34,7 páginas por segundo. No treinamento também entraram cerca de 680 mil imagens reais.
Processado por IA de Hugging Face Blog; editado por Hamidun News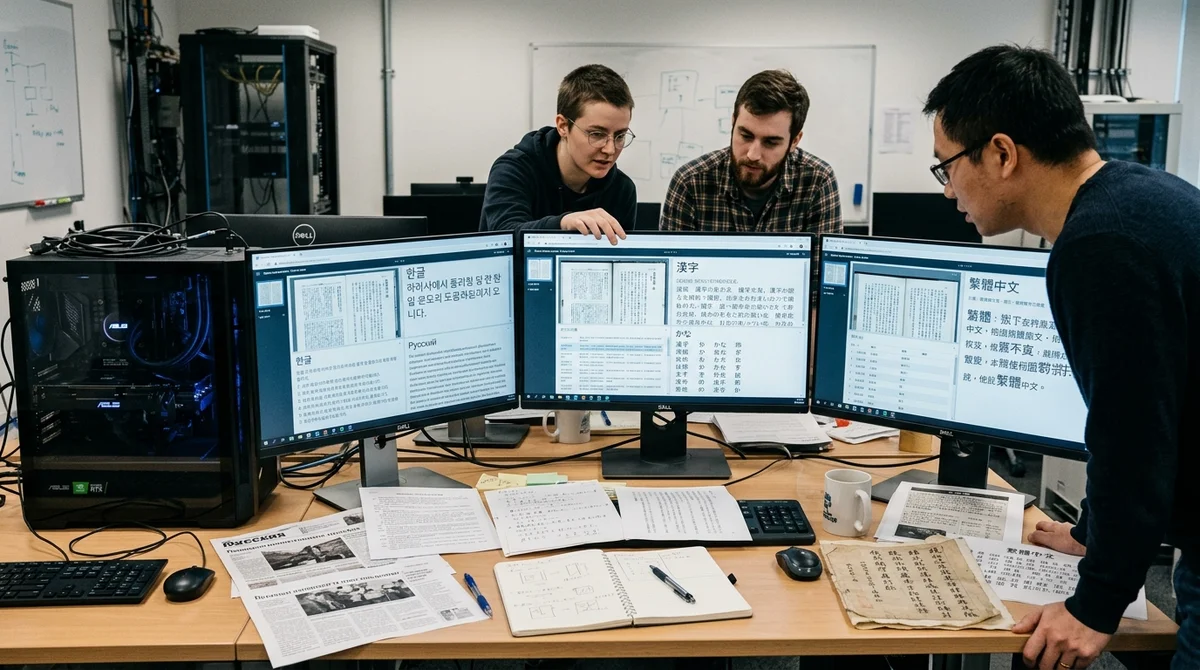
A NVIDIA mostrou como construiu o Nemotron OCR v2, um sistema de OCR multilíngue em que o grande salto veio não de truques de arquitetura, mas de dados sintéticos em larga escala. A empresa montou um conjunto de 12,26 milhões de documentos gerados artificialmente e treinou com ele um modelo que lê vários idiomas com um só motor e entrega até 34,7 páginas por segundo em uma única A100.
Foco nos dados
A versão anterior, o Nemotron OCR v1, funcionava bem com inglês, mas falhava em outros idiomas. O benchmark SynthDoG mostrou que os valores de Normalized Edit Distance para japonês, coreano, russo e chinês eram altos demais: em alguns pontos, o resultado mal lembrava o texto original. A equipe chegou a ampliar o conjunto de caracteres de 855 para 14.244 para cobrir o cirílico e as escritas CJK, mas o ganho foi pequeno. Formalmente, o modelo podia gerar os caracteres necessários, mas quase não os via no treinamento.
"O gargalo eram os dados, não a arquitetura."
Esse foi o ponto de virada do projeto. Rotular manualmente milhões de documentos com caixas em nível de palavra, linha e parágrafo custaria caro demais, e o scraping de PDFs da web gera uma camada de texto ruidosa e muitos erros. Por isso, a NVIDIA seguiu outro caminho: gerar os documentos por programação e saber de antemão as coordenadas exatas, as transcrições e a ordem de leitura de cada fragmento.
Como o corpus foi montado
Para os textos, a NVIDIA usou o mOSCAR, um grande corpus web multilíngue com 163 subconjuntos de idiomas. Isso permitiu partir não de listas de dicionário nem de texto de máquina, mas de frases mais realistas, com distribuição natural de palavras e caracteres.
Como motor de renderização, a empresa adotou o SynthDoG, do projeto Donut, e o retrabalhou de forma significativa. O resultado não são apenas imagens de páginas, mas uma anotação hierárquica completa em nível de palavra, linha e parágrafo, além de um grafo de relações que define a ordem de leitura.
Várias melhorias importantes entraram no pipeline para aproximar os dados sintéticos dos documentos reais:
- layouts com vários modelos: colunas, tabelas, texto vertical, sumários, slides e páginas no estilo Word
- anotação não só por caixas, mas também pela hierarquia dos elementos e pelas relações entre linhas
- mudança para reconhecimento por linhas em japonês, coreano e chinês, onde os limites das palavras costumam ser ambíguos
- um grande conjunto de fontes abertas, de 165 a 1.258 por idioma, incluindo as famílias Google Fonts e Noto
- aumentações agressivas: sombras, contornos, ruído, desfoque, distorções e mudanças de brilho e de fundo
O conjunto final tem 12.258.146 exemplos em seis categorias de idioma: inglês, japonês, coreano, russo, chinês simplificado e chinês tradicional. O modelo multilíngue em si funciona como uma pilha única para inglês, russo, japonês, coreano e chinês, sem uma etapa separada de detecção de idioma. A lógica de expansão também é simples: se um novo idioma tem corpus de texto e fontes adequadas, o pipeline pode ser ampliado sem rotulagem manual e sem reescrever a arquitetura.
Velocidade e concessões
O Nemotron OCR v2 foi treinado não só com dados sintéticos, mas também com cerca de 680 mil imagens reais. A arquitetura tem três partes: um detector de texto baseado em RegNetX-8GF, um reconhecedor baseado em Transformer e um módulo relacional que entende quais linhas e blocos estão ligados entre si. A ideia central é que um backbone convolucional pesado percorre a página uma só vez, e suas características são reaproveitadas pelos demais componentes. Assim, o sistema não gasta processamento extra em cada etapa do pipeline separadamente.
No benchmark sintético, o avanço parece muito forte. Em russo, o NED caiu de 0,564 no Nemotron OCR v1 para 0,043 no v2; em japonês, de 0,723 para 0,046; em coreano, de 0,923 para 0,047; em chinês simplificado, de 0,784 para 0,035. Segundo a NVIDIA, a versão multilíngue única superou nesse conjunto até as variantes especializadas por idioma do PaddleOCR.
Mas no OmniDocBench, com dados reais, o quadro é mais complexo: o Nemotron OCR v2 chega a 34,7 páginas por segundo contra 1,2 do PaddleOCR v5, ganho de velocidade de mais de 28 vezes, embora em precisão fique atrás dos melhores concorrentes em alguns subconjuntos. Aqui o produto claramente escolhe o equilíbrio a favor da velocidade de processamento, e não da qualidade máxima a qualquer custo.
O que isso significa
O Nemotron OCR v2 é um bom sinal para o mercado de IA documental: os dados sintéticos já não são um efeito de demonstração, mas um jeito prático de lançar rapidamente modelos de OCR multilíngues e escalá-los para novas escritas. Para as empresas, isso significa um caminho mais barato para o reconhecimento de documentos, principalmente onde velocidade, versatilidade e controle sobre a anotação importam mais do que um recorde absoluto em cada benchmark.
- 2 de nov. de 2026Criador do Bun migra 750 mil linhas de Zig para Rust em 11 dias com Claude Code
- 2 de nov. de 2026Jornalista da The Verge monta um rival do Meta Muse Charm por $50 com ajuda do Claude Code
- 1 de nov. de 2026Teste com 16 modelos em 7 buscadores: Exa fez em média 10,5 pontos de 14; SearXNG, cerca de 3
- 1 de nov. de 2026Agente de vídeo StreamVibe, do Google, supera outros modelos em 10,7% em timing e qualidade das respostas
Perguntas frequentes sobre a notícia
O que se sabe sobre Foco nos dados?
A versão anterior, o Nemotron OCR v1, funcionava bem com inglês, mas falhava em outros idiomas. O benchmark SynthDoG mostrou que os valores de Normalized Edit Distance para japonês, coreano, russo e chinês eram altos demais: em alguns pontos, o resultado mal lembrava o texto original. A equipe chegou a ampliar o conjunto de caracteres de 855 para 14.244 para cobrir o cirílico e as escritas CJK, mas o ganho foi pequeno. Formalmente, o modelo podia gerar os caracteres necessários, mas quase não os via no treinamento. "O gargalo eram os dados, não a arquitetura." Esse foi o po
Como o corpus foi montado?
Para os textos, a NVIDIA usou o mOSCAR, um grande corpus web multilíngue com 163 subconjuntos de idiomas. Isso permitiu partir não de listas de dicionário nem de texto de máquina, mas de frases mais realistas, com distribuição natural de palavras e caracteres. Como motor de renderização, a empresa adotou o SynthDoG, do projeto Donut, e o retrabalhou de forma significativa. O resultado não são apenas imagens de páginas, mas uma anotação hierárquica completa em nível de palavra, linha e parágrafo, além de um grafo de relações que define a ordem de leitura. Várias melhorias im
O que se sabe sobre Velocidade e concessões?
O Nemotron OCR v2 foi treinado não só com dados sintéticos, mas também com cerca de 680 mil imagens reais. A arquitetura tem três partes: um detector de texto baseado em RegNetX-8GF, um reconhecedor baseado em Transformer e um módulo relacional que entende quais linhas e blocos estão ligados entre si. A ideia central é que um backbone convolucional pesado percorre a página uma só vez, e suas características são reaproveitadas pelos demais componentes. Assim, o sistema não gasta processamento extra em cada etapa do pipeline separadamente. No benchmark sintético, o avanço par
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.