Stack open source com 6 modelos e 9 agentes mostra como montar uma equipe de IA em um único servidor
Um servidor com GPU, seis modelos open source e nove agentes: é assim que funciona uma equipe de IA autônoma que projeta, escreve, testa e faz deploy de novos agentes por conta própria. Em vez de um modelo universal, os papéis são distribuídos conforme os pontos fortes: raciocínio para o orquestrador, geração de código para o construtor, uso de ferramentas para o crítico. A principal economia vem do compartilhamento de instâncias: 9 agentes rodam com apenas 3–4 modelos. O autor também descreve três opções de implantação, de uma RTX 4090 a um cluster de A100.
Processado por IA de Habr AI; editado por Hamidun News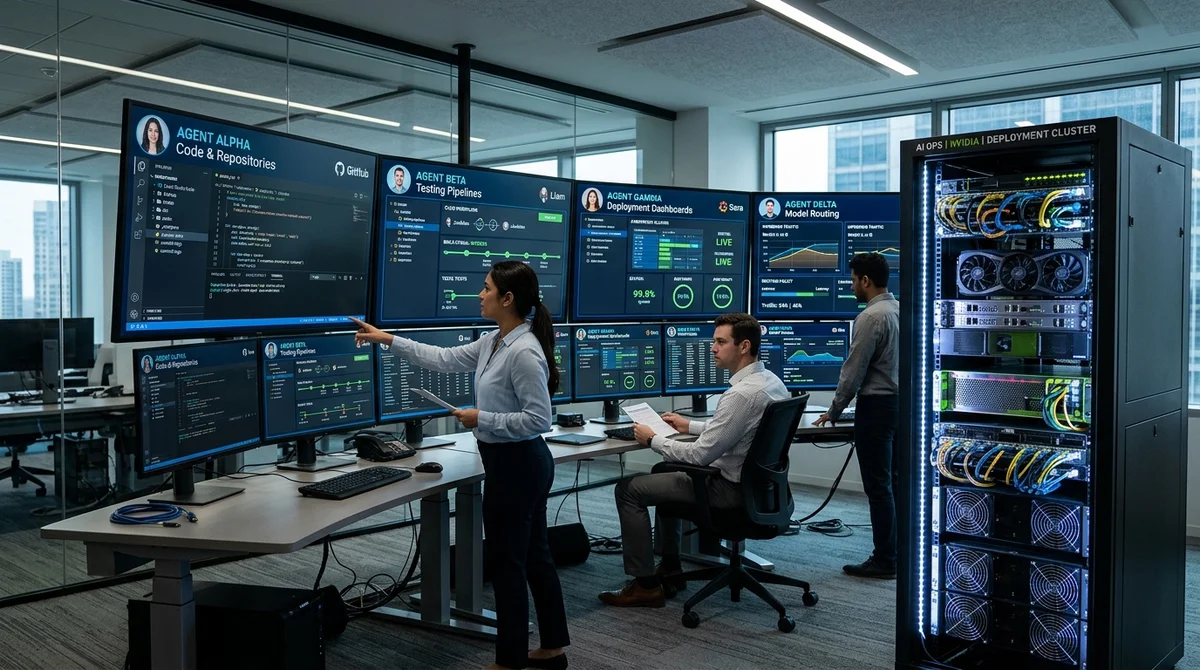
Uma equipe autônoma de nove agentes de IA pode projetar, escrever, testar e fazer deploy de novos agentes sem participação humana. Não é preciso um conjunto de APIs fechadas: o esquema se baseia em seis modelos open source e, na versão básica, cabe em um único servidor com GPU.
Como a equipe é organizada
Em vez de um único modelo "universal", o autor montou um pipeline com nove papéis. Alguns agentes cuidam da definição da tarefa e da arquitetura; outros, da escrita de código, da verificação de qualidade, dos testes e da publicação. O resultado não é um grande assistente, mas uma pequena organização de engenharia em que cada integrante faz uma fatia restrita do trabalho.
Essa abordagem reduz o caos: o agente não precisa planejar o sistema, escrever módulos, rodar testes e avaliar os próprios erros ao mesmo tempo. A ideia central é que a autonomia vem não de mágica, mas da divisão do processo em etapas. Se o agente entende apenas a sua parte e recebe como entrada uma tarefa já estruturada, os requisitos para o modelo ficam mais claros. O orquestrador precisa saber raciocinar e manter contexto, o construtor deve gerar código de forma estável e o crítico precisa enxergar problemas no uso de ferramentas e nos cenários de execução. Por isso, o ganho não vem de um supermodelo, mas da montagem precisa dos papéis em um pipeline funcional.
Papéis e benchmarks
O autor rejeita de forma explícita a ideia de um "melhor modelo em geral". Em vez disso, os papéis são escolhidos pelo que os benchmarks confirmam. Para o orquestrador, o raciocínio é o que importa, então a referência é um resultado de 88,4% no GPQA. Para o construtor, a geração de código é crítica, e aqui se observa o HumanEval, com 92,7%. Para o crítico, pesa mais a compreensão do uso de ferramentas e do comportamento dos agentes nas tarefas, e por isso entra o tau-bench, com resultado de 87,4%. É essa especialização que explica o uso de seis modelos open source diferentes, em vez de um modelo da classe GPT para todos os casos.
- Orquestrador: raciocínio forte, priorização e decomposição de tarefas
- Construtor: geração de código e passagem rápida por mudanças de engenharia
- Crítico: verificação do uso de ferramentas, da qualidade das soluções e dos pontos fracos do pipeline
- Demais papéis: testes, deploy e etapas de apoio, em que instâncias compartilhadas podem ser reaproveitadas
Nove agentes não significam nove modelos completos na memória ao mesmo tempo. Um truque prático é o compartilhamento de instâncias: vários papéis dividem o mesmo modelo quando suas cargas e perfis de tarefa são parecidos. Com isso, um sistema de nove agentes pode rodar com apenas três ou quatro instâncias de modelo. Isso reduz drasticamente o consumo de VRAM, simplifica a manutenção e aproxima a arquitetura da produção real, e não de uma demonstração com orçamento ilimitado.
Hardware e execução
A parte de infraestrutura merece atenção à parte. O autor descreve três configurações de implantação: de uma única RTX 4090 com 24 GB de memória a um cluster de A100 com 211 GB no total. Entre esses extremos, dá para escolher o equilíbrio entre velocidade, qualidade e paralelismo. Para baratear, são usados quantização, uma infraestrutura de inferência bem pensada e um painel interativo que ajuda a acompanhar papéis, carga e andamento das tarefas. Ou seja, não se trata só de escolher modelos, mas também de ter um ambiente operacional decente para eles.
A conclusão prática é simples: agentes open source deixam de ser brinquedo de laboratório. Se antes esses esquemas eram associados a APIs caras ou a clusters pesados, aqui se mostra um caminho inicial mais realista. Uma equipe pequena pode começar com um servidor, validar a viabilidade do pipeline e depois escalar conforme as tarefas crescerem. O custo já parece uma escolha de engenharia, e não uma barreira que elimina de imediato a maioria das equipes.
O que isso significa
O mercado está saindo da ideia de um modelo "mágico" e indo para sistemas orientados a papéis, em que a composição correta importa mais do que um nome de peso em uma API. Para as empresas, é um sinal: equipes de IA autônomas já podem ser montadas com componentes open source, desde que tratadas como infraestrutura e processo, e não como uma única janela de chat.
- 2 de nov. de 2026DeepSeek abre o código do protótipo Super-agent: p95 de tempo de execução de 15,7 min, contra 29,5
- 2 de nov. de 2026TensorFold 1.2.0 aumenta em 44,2% a vazão do Qwen3.8-27B no M3 Ultra com 16 fluxos
- 1 de nov. de 2026Juiz do EditAgent, da Adobe, escolhe uma edição aceitável em 81,3% dos casos, contra 74,8% do EditScore
- 1 de nov. de 2026Teste com 16 modelos em 7 buscadores: Exa fez em média 10,5 pontos de 14; SearXNG, cerca de 3
Perguntas frequentes sobre a notícia
Como a equipe é organizada?
Em vez de um único modelo "universal", o autor montou um pipeline com nove papéis. Alguns agentes cuidam da definição da tarefa e da arquitetura; outros, da escrita de código, da verificação de qualidade, dos testes e da publicação. O resultado não é um grande assistente, mas uma pequena organização de engenharia em que cada integrante faz uma fatia restrita do trabalho. Essa abordagem reduz o caos: o agente não precisa planejar o sistema, escrever módulos, rodar testes e avaliar os próprios erros ao mesmo tempo. A ideia central é que a autonomia vem não de mágica, mas da d
O que se sabe sobre Papéis e benchmarks?
O autor rejeita de forma explícita a ideia de um "melhor modelo em geral". Em vez disso, os papéis são escolhidos pelo que os benchmarks confirmam. Para o orquestrador, o raciocínio é o que importa, então a referência é um resultado de 88,4% no GPQA. Para o construtor, a geração de código é crítica, e aqui se observa o HumanEval, com 92,7%. Para o crítico, pesa mais a compreensão do uso de ferramentas e do comportamento dos agentes nas tarefas, e por isso entra o tau-bench, com resultado de 87,4%. É essa especialização que explica o uso de seis modelos open source diferente
O que se sabe sobre Hardware e execução?
A parte de infraestrutura merece atenção à parte. O autor descreve três configurações de implantação: de uma única RTX 4090 com 24 GB de memória a um cluster de A100 com 211 GB no total. Entre esses extremos, dá para escolher o equilíbrio entre velocidade, qualidade e paralelismo. Para baratear, são usados quantização, uma infraestrutura de inferência bem pensada e um painel interativo que ajuda a acompanhar papéis, carga e andamento das tarefas. Ou seja, não se trata só de escolher modelos, mas também de ter um ambiente operacional decente para eles. A conclusão prática é
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.