Google lança Gemini Embedding 2 para RAG multimodal com vídeo, áudio e PDF
O Google atualizou sua linha de embeddings e lançou o Gemini Embedding 2, modelo que trabalha não só com texto, mas também com imagens, vídeo, áudio e PDF. Para o RAG, é uma mudança importante: agora é possível buscar em diferentes formatos em um único espaço vetorial. Mas, para o LLM dar uma resposta útil, ainda é preciso uma arquitetura adequada, com descrições de texto separadas dos arquivos encontrados.
Processado por IA de Habr AI; editado por Hamidun News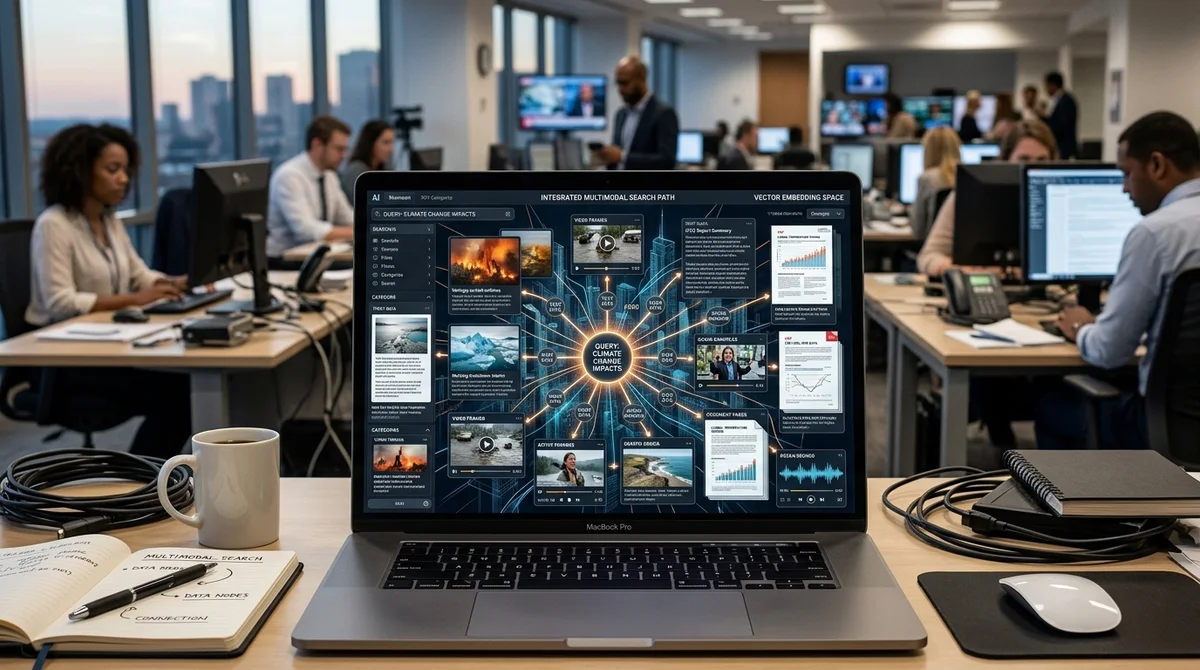
O Google lançou o Gemini Embedding 2, um modelo de embeddings que leva para um único espaço vetorial não apenas texto, mas também imagens, áudio, vídeo e PDF. Para o RAG multimodal, é um passo importante: uma só consulta agora pode encontrar tanto um artigo da base de conhecimento quanto o trecho exato de um vídeo de treinamento.
O que mudou
Antes, a busca em tipos de conteúdo mistos dependia de uma longa cadeia de conversões. O vídeo precisava ser dividido em quadros, o áudio transcrito, as imagens descritas por um modelo de visão, e tudo isso reunido de volta em texto antes de ser enviado a um modelo de embeddings. O esquema funcionava, mas perdia detalhes a cada etapa. Se o reconhecimento de fala errava ou a descrição de um quadro ficava genérica demais, a qualidade da busca caía na hora, e o desenvolvedor tinha de manter um pipeline pesado, com vários serviços.
Com o Gemini Embedding 2, parte dessa complexidade desaparece. O modelo aceita os arquivos originais diretamente e constrói representações de diferentes formatos em um espaço unificado. Isso significa que uma consulta de texto como "como configurar a autorização" pode corresponder não só à documentação, mas também a um trecho de vídeo relevante, a uma imagem da interface ou a um manual em PDF. Para equipes que guardam conhecimento em formatos dispersos, isso elimina uma das principais limitações do RAG clássico.
Como montar o sistema
Mas o modelo de embeddings sozinho não torna o RAG multimodal útil automaticamente. Um grande modelo de linguagem não consegue simplesmente "ler" um MP4 ou uma imagem como lê um contexto de texto. Por isso, uma arquitetura que funcione tem dois canais: um cuida da busca por embeddings nativos e o outro prepara uma descrição em texto do objeto encontrado, que aí sim pode ser passada ao LLM para gerar a resposta. É a combinação desses canais que transforma uma demo bonita em um produto funcional.
- Indexar os arquivos originais de forma nativa, sem conversões desnecessárias
- Guardar ao lado deles descrições em texto, transcrições e metadados
- Buscar em um único espaço vetorial para todos os tipos de conteúdo
- Passar ao LLM não o arquivo, mas sua representação em texto e o contexto
Na prática, isso combina bem com a stack habitual de RAG: Python para o pipeline, a API do Gemini para embeddings e geração de descrições, e Supabase ou outro banco vetorial para armazenar os índices. Essa abordagem permite buscar ao mesmo tempo na base de conhecimento, em capturas de tela, apresentações e vídeos internos, sem obrigar o usuário a pensar em qual formato está a resposta. No nível do produto, deixa de ser apenas uma busca em documentos e passa a ser um ponto único de acesso ao conhecimento da empresa.
Onde estão os gargalos
A principal limitação não desapareceu: o objeto multimídia encontrado ainda precisa ser explicado ao modelo e à pessoa. Se o sistema devolve um vídeo mas não sabe em que trecho está a resposta, o usuário continua recebendo um resultado fraco. Por isso, a qualidade do RAG multimodal agora depende não só dos embeddings, mas também do cuidado na segmentação, na anotação e na ligação da camada de texto ao arquivo original.
A consulta "como configurar a autorização" pode retornar tanto um
artigo quanto o trecho de vídeo certo.
Daí surgem requisitos de engenharia: é preciso planejar o chunking de vídeo e áudio, a atualização das descrições quando arquivos são substituídos, o armazenamento de timecodes e o controle de custos. A busca multimodal nativa reduz a perda de informação, mas não elimina a necessidade de bons dados. Se as descrições forem fracas, o LLM não conseguirá montar uma resposta com segurança, mesmo quando a busca acerta. Por isso, o principal valor do Gemini Embedding 2 aparece onde a equipe está disposta a construir um índice completo, em vez de apenas subir arquivos e esperar mágica.
O que isso significa
Para bases de conhecimento corporativas, suporte, onboarding e plataformas de treinamento, é uma mudança notável. O Google aproxima o RAG de um cenário em que texto, imagens e vídeo são fontes de resposta em pé de igualdade. Não vencerão os que têm mais arquivos, mas os que conectarem corretamente a busca multimodal a uma camada de texto clara para o LLM.
- 1 de nov. de 2026Teste com 16 modelos em 7 buscadores: Exa fez em média 10,5 pontos de 14; SearXNG, cerca de 3
- 1 de nov. de 2026Agente de vídeo StreamVibe, do Google, supera outros modelos em 10,7% em timing e qualidade das respostas
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Bots de voz com LLM usam o classificador rápido Jev: decisão em 200–500 ms
Perguntas frequentes sobre a notícia
O que mudou?
Antes, a busca em tipos de conteúdo mistos dependia de uma longa cadeia de conversões. O vídeo precisava ser dividido em quadros, o áudio transcrito, as imagens descritas por um modelo de visão, e tudo isso reunido de volta em texto antes de ser enviado a um modelo de embeddings. O esquema funcionava, mas perdia detalhes a cada etapa. Se o reconhecimento de fala errava ou a descrição de um quadro ficava genérica demais, a qualidade da busca caía na hora, e o desenvolvedor tinha de manter um pipeline pesado, com vários serviços. Com o Gemini Embedding 2, parte dessa complexi
Como montar o sistema?
Mas o modelo de embeddings sozinho não torna o RAG multimodal útil automaticamente. Um grande modelo de linguagem não consegue simplesmente "ler" um MP4 ou uma imagem como lê um contexto de texto. Por isso, uma arquitetura que funcione tem dois canais: um cuida da busca por embeddings nativos e o outro prepara uma descrição em texto do objeto encontrado, que aí sim pode ser passada ao LLM para gerar a resposta. É a combinação desses canais que transforma uma demo bonita em um produto funcional. Indexar os arquivos originais de forma nativa, sem conversões desnecessárias Gua
Onde estão os gargalos?
A principal limitação não desapareceu: o objeto multimídia encontrado ainda precisa ser explicado ao modelo e à pessoa. Se o sistema devolve um vídeo mas não sabe em que trecho está a resposta, o usuário continua recebendo um resultado fraco. Por isso, a qualidade do RAG multimodal agora depende não só dos embeddings, mas também do cuidado na segmentação, na anotação e na ligação da camada de texto ao arquivo original. A consulta "como configurar a autorização" pode retornar tanto um artigo quanto o trecho de vídeo certo. Daí surgem requisitos de engenharia: é preciso plane
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.