Nvidia apresenta primeiro dataset aberto e modelos de IA de base para robôs médicos
A Nvidia e parceiros publicaram o Open-H-Embodiment, o primeiro grande dataset aberto de robótica médica. São 778 horas de dados de cirurgia, ultrassom e colonoscopia. Junto com ele, chegam pela primeira vez dois modelos: o GR00T-H, para controle de robôs, e o Cosmos-H-Surgical-Simulator, para simular cirurgias rapidamente. É uma tentativa de montar um stack básico de Physical AI para a medicina.
Processado por IA de Hugging Face Blog; editado por Hamidun News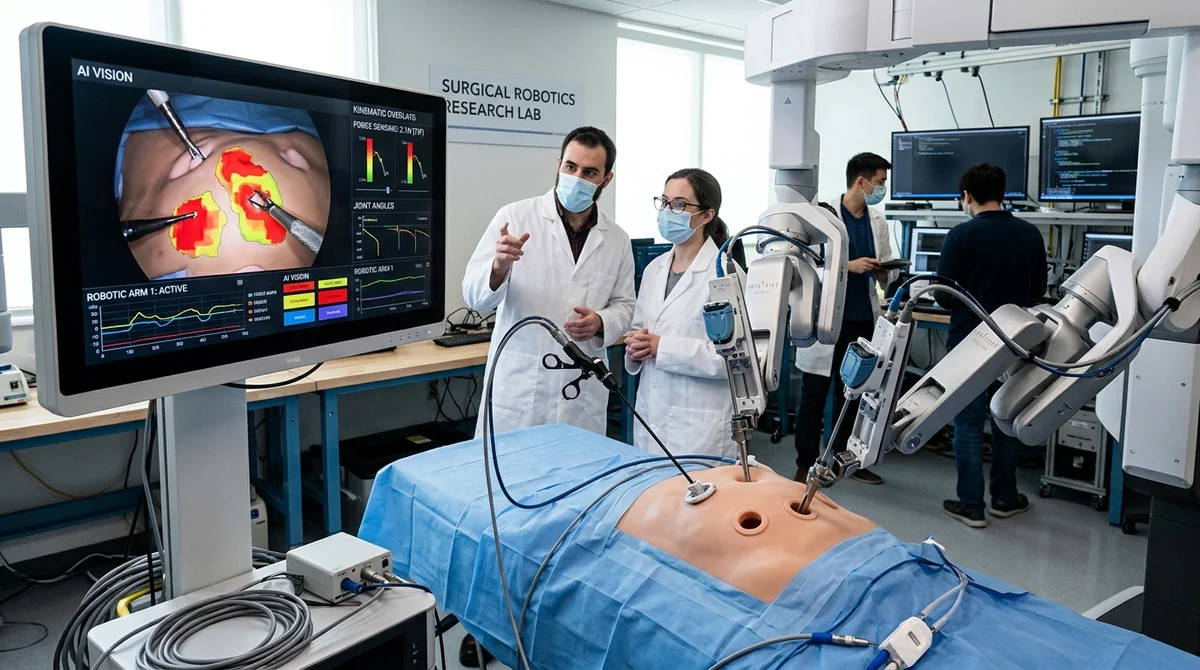
A Nvidia, junto com a comunidade de pesquisa, apresentou o Open-H-Embodiment, o primeiro grande dataset aberto de robótica médica, além de dois modelos de base para cenários cirúrgicos. O pacote foi publicado no Hugging Face e pretende levar a IA médica da análise de imagens para sistemas capazes de agir no mundo físico.
O que foi aberto
A ideia do lançamento é simples: a medicina já tem modelos de sobra que apenas reconhecem exames, segmentam tecidos ou classificam patologias. No centro cirúrgico, no ultrassom ou na colonoscopia, a máquina precisa manejar um instrumento, entender o contato com os tecidos, considerar a cinemática do robô e fechar o ciclo de controle por realimentação. O Open-H-Embodiment foi criado justamente para isso: uma base comum para treinar e avaliar Physical AI em robótica médica.
- 778 horas de dados de treinamento sob licença CC-BY-4.0
- 35 organizações participantes, entre universidades, clínicas e indústria
- cenários de cirurgia, ultrassom e colonoscopia autônoma
- dados de simulação, exercícios em simuladores e procedimentos reais
- suporte a plataformas robóticas comerciais e de pesquisa
Para o mercado, o formato importa tanto quanto o volume. O dataset reúne visão, força, cinemática e diferentes corpos robóticos em um único conjunto aberto, para que as equipes possam comparar abordagens numa base comum, e não em coleções locais fechadas. Participam Nvidia, Johns Hopkins, Technical University of Munich, Stanford e dezenas de outras equipes, então não se trata de uma publicação isolada, mas de uma tentativa de definir um padrão do setor.
Como os modelos funcionam
Junto com o dataset, a Nvidia publicou o GR00T-H, um modelo Vision-Language-Action para robótica cirúrgica, treinado com cerca de 600 horas de dados do Open-H-Embodiment. Na prática, é um modelo de políticas: recebe contexto visual e textual e o converte em ações do robô. Os autores destacam que introduziram um espaço de ações normalizado comum a diferentes robôs, projeções específicas para cada cinemática e treinamento com movimentos relativos do instrumento. O protótipo já executou uma sutura completa no benchmark SutureBot, ou seja, não um gesto curto, mas uma longa sequência de ações precisas.
A segunda parte do stack é o Cosmos-H-Surgical-Simulator, um world foundation model para simulação cirúrgica condicionada por ações. Ele foi ajustado com o Open-H-Embodiment para gerar vídeo verossímil da operação diretamente a partir das ações cinemáticas do robô, incluindo efeitos complexos como deformação de tecidos moles, reflexos, sangue e fumaça. O ganho prático é visível: 600 execuções nesse simulador levam cerca de 40 minutos, contra aproximadamente dois dias em testes reais de bancada. O ajuste usou 64 GPUs A100 e cerca de 10 mil horas de GPU, então é uma base de infraestrutura séria, não uma demo de laboratório.
O que vem pela frente
O mais interessante da história é a tentativa de levar a robótica médica do modo "o modelo vê" para o modo "o modelo age e generaliza". Um dataset aberto e dois modelos fundacionais dão aos pesquisadores um stack comum para experimentos sim-to-real, geração de dados sintéticos e transferência de habilidades entre robôs diferentes. Isso é especialmente importante na cirurgia, onde reunir grandes datasets de qualidade é caro e um erro de controle custa muito mais do que na visão computacional comum.
"A robótica cirúrgica precisa do seu próprio momento
ChatGPT."
É assim que os autores descrevem o objetivo da segunda versão do Open-H-Embodiment. A próxima etapa não é apenas controlar melhor o instrumento, mas ter autonomia com elementos de raciocínio: os sistemas devem conseguir explicar etapas, planejar procedimentos longos, se adaptar a falhas e aprender com trajetórias anotadas com intenções, resultados e tipos de erro. Se a comunidade realmente reunir esses dados prontos para raciocínio, a medicina poderá ganhar não mais um algoritmo restrito, mas uma plataforma para assistentes robóticos mais universais.
O que isso significa
Para o mercado de IA, é uma mudança importante: na medicina, começa-se a construir abertamente não só modelos de reconhecimento, mas uma camada de base para Physical AI, em que dados, modelos de políticas e simuladores saem em pacote. Se a abordagem decolar, startups, laboratórios e fabricantes de robôs terão um kit inicial comum para acelerar pesquisas, reduzir o custo dos testes e passar mais rápido de protótipos a sistemas clinicamente úteis.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Autor do Habr faz fine-tuning do YOLOv8l em radiografias dentárias e leva o mAP50 a 0,642
- 1 de nov. de 2026Bots de voz com LLM usam o classificador rápido Jev: decisão em 200–500 ms
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
Perguntas frequentes sobre a notícia
O que foi aberto?
A ideia do lançamento é simples: a medicina já tem modelos de sobra que apenas reconhecem exames, segmentam tecidos ou classificam patologias. No centro cirúrgico, no ultrassom ou na colonoscopia, a máquina precisa manejar um instrumento, entender o contato com os tecidos, considerar a cinemática do robô e fechar o ciclo de controle por realimentação. O Open-H-Embodiment foi criado justamente para isso: uma base comum para treinar e avaliar Physical AI em robótica médica. 778 horas de dados de treinamento sob licença CC-BY-4.0 35 organizações participantes, entre universida
Como os modelos funcionam?
Junto com o dataset, a Nvidia publicou o GR00T-H, um modelo Vision-Language-Action para robótica cirúrgica, treinado com cerca de 600 horas de dados do Open-H-Embodiment. Na prática, é um modelo de políticas: recebe contexto visual e textual e o converte em ações do robô. Os autores destacam que introduziram um espaço de ações normalizado comum a diferentes robôs, projeções específicas para cada cinemática e treinamento com movimentos relativos do instrumento. O protótipo já executou uma sutura completa no benchmark SutureBot, ou seja, não um gesto curto, mas uma longa sequ
O que vem pela frente?
O mais interessante da história é a tentativa de levar a robótica médica do modo "o modelo vê" para o modo "o modelo age e generaliza". Um dataset aberto e dois modelos fundacionais dão aos pesquisadores um stack comum para experimentos sim-to-real, geração de dados sintéticos e transferência de habilidades entre robôs diferentes. Isso é especialmente importante na cirurgia, onde reunir grandes datasets de qualidade é caro e um erro de controle custa muito mais do que na visão computacional comum. "A robótica cirúrgica precisa do seu próprio momento ChatGPT." É assim que os
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.