A Mentorpiece lançou um curso gratuito sobre testes não funcionais de aplicações de AI
A Mentorpiece lançou um curso gratuito sobre testes não funcionais de aplicações de AI. O programa cobre testes de custo, rastreabilidade, confiabilidade, privacidade e validação de agentes de AI, RAG e modelos fine-tuned. Os autores analisam casos reais: um modelo pode ser ao mesmo tempo mais preciso e várias vezes mais barato que outro, e sob alta carga os serviços começam a receber erros 429 ou retornar respostas vazias. É uma introdução breve a AI-QA para testadores em geral.
Processado por IA de Habr AI; editado por Hamidun News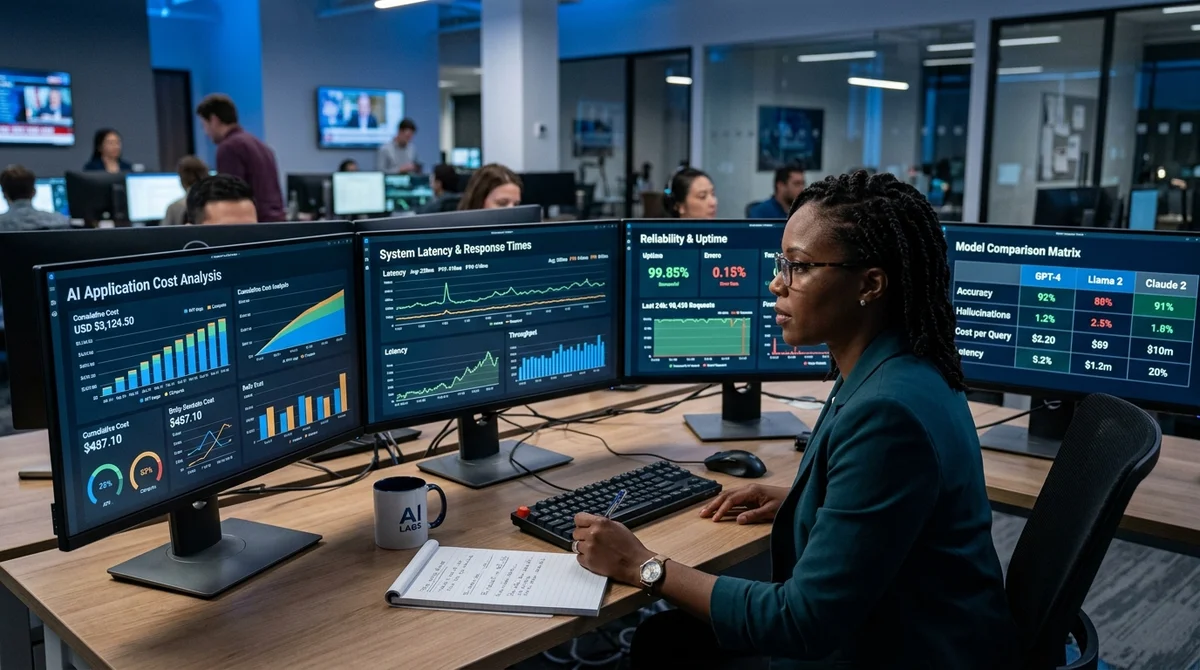
A Mentorpiece lançou um curso gratuito introdutório sobre testes não-funcionais de aplicações com IA. Os autores do curso partem de uma ideia simples: para produtos baseados em modelos, qualidade de resposta não é mais suficiente, porque a experiência geral do usuário é prejudicada por custo, latência, instabilidade e opacidade dos próprios modelos.
Por Que IA É Mais Complexa
No desenvolvimento de software clássico, verificações não-funcionais frequentemente são adiadas até o lançamento ou até depois dos primeiros usuários. Com aplicações de IA, essa abordagem danifica rapidamente o produto. Mesmo se um cenário pareça funcional em uma demonstração, em produção podem surgir limitações completamente diferentes: custos voláteis de tokens, latência instável, limites de provedor, respostas vazias ou degradação de qualidade em dados reais. Para a equipe, esses não são mais detalhes secundários—tornam-se parte da verificação básica de se a função pode rodar em produção.
Um problema separado é a rastreabilidade. Um modelo de IA permanece uma caixa-preta mesmo para a equipe que o implementou: um conjunto de dados entra, uma resposta sai, mas a lógica dentro está oculta. O artigo explica isso através da imagem da resposta "42" de "O Guia do Mochileiro das Galáxias": há um resultado, mas por que é exatamente esse é incerto. Se testes de rastreabilidade não forem estabelecidos, o produto rapidamente começa a retornar resultados difíceis de explicar, reproduzir e melhorar.
Casos Reais da Prática
Um dos exemplos mais notáveis no artigo é teste de custo. Uma equipe comparou dois modelos para o papel principal em uma aplicação: modelo A popular e modelo B menos conhecido. Conforme resultados de teste, modelo A produziu 63% mais erros que modelo B. Ao mesmo tempo, seus tokens de entrada custavam 75 dólares por milhão, enquanto modelo B custava 3,75 dólares. Em outras palavras, o modelo mais barato se revelou não um compromisso, mas a melhor opção tanto em preço quanto em qualidade.
"Modelo B é 20 vezes mais barato com precisão muito melhor."
O segundo caso diz respeito à confiabilidade sob carga. Uma aplicação de IA usava três modelos de três provedores diferentes simultaneamente. Enquanto dezenas de testes automáticos rodavam em paralelo, o sistema se comportava normalmente. Mas após exceder cem testes simultâneos, falhas começaram: um modelo começou regularmente a retornar erro 429 Too Many Requests, enquanto outro retornava saída vazia sem erro explícito em aproximadamente 10% dos casos. Para um usuário isso parece uma falha aleatória, mas para QA é um sinal de que testes de carga e confiabilidade são obrigatórios aqui.
O Que Está Incluído no Curso
O curso da Mentorpiece é projetado como uma visão geral introdutória para testadores que ainda não trabalharam com aplicações de IA mas querem rapidamente entender onde os novos riscos existem. O material não tenta sobrecarregar o leitor com detalhes matemáticos de modelos. Em vez disso, reúne as principais áreas de teste que mais frequentemente afetam o lançamento e operação de recursos de IA em um produto real.
- teste de custo e comparação de modelos por preço e taxa de erros
- teste de rastreabilidade e análise de caixa-preta
- testes de confiabilidade, resiliência e comportamento sob carga
- teste de privacidade e vazamento de dados
- abordagens para teste de agentes de IA, RAG, modelos fine-tuned, dados e cenários LLM-as-a-Judge
Os autores levantam separadamente a questão prática da seleção de modelo. Sua tese é simples: benchmarks públicos não podem ser confiados cegamente, porque um produto real vive em seus próprios dados, com suas próprias restrições de orçamento, velocidade e níveis aceitáveis de erro.
O curso está disponível gratuitamente, e registro é necessário apenas para salvar progresso. Além da plataforma Mentorpiece, também foi postado em Stepik.
O Que Isso Significa
O tópico AI-QA está rapidamente emergindo do status de especialidade estreita. Até mesmo equipes que não constroem seus próprios modelos já precisam testar o comportamento de LLMs externas como parte do produto: rastrear custos, detectar degradação, monitorar falhas e entender por que o sistema responde da forma que responde. O curso gratuito da Mentorpiece é uma tentativa de fornecer um mapa básico dessa nova zona, onde teste não-funcional se torna não um complemento, mas uma condição para operação normal de um serviço de IA.
Perguntas frequentes sobre a notícia
Por Que IA É Mais Complexa?
No desenvolvimento de software clássico, verificações não-funcionais frequentemente são adiadas até o lançamento ou até depois dos primeiros usuários. Com aplicações de IA, essa abordagem danifica rapidamente o produto. Mesmo se um cenário pareça funcional em uma demonstração, em produção podem surgir limitações completamente diferentes: custos voláteis de tokens, latência instável, limites de provedor, respostas vazias ou degradação de qualidade em dados reais. Para a equipe, esses não são mais detalhes secundários—tornam-se parte da verificação básica de se a função pode
O que se sabe sobre Casos Reais da Prática?
Um dos exemplos mais notáveis no artigo é teste de custo. Uma equipe comparou dois modelos para o papel principal em uma aplicação: modelo A popular e modelo B menos conhecido. Conforme resultados de teste, modelo A produziu 63% mais erros que modelo B. Ao mesmo tempo, seus tokens de entrada custavam 75 dólares por milhão, enquanto modelo B custava 3,75 dólares. Em outras palavras, o modelo mais barato se revelou não um compromisso, mas a melhor opção tanto em preço quanto em qualidade. "Modelo B é 20 vezes mais barato com precisão muito melhor." O segundo caso diz respeito
O Que Está Incluído no Curso?
O curso da Mentorpiece é projetado como uma visão geral introdutória para testadores que ainda não trabalharam com aplicações de IA mas querem rapidamente entender onde os novos riscos existem. O material não tenta sobrecarregar o leitor com detalhes matemáticos de modelos. Em vez disso, reúne as principais áreas de teste que mais frequentemente afetam o lançamento e operação de recursos de IA em um produto real. teste de custo e comparação de modelos por preço e taxa de erros teste de rastreabilidade e análise de caixa-preta testes de confiabilidade, resiliência e comporta
Delegate Deep Research, Coding & Workflows to an AI Agent
Deploy autonomous multi-step execution with NomadNet Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and complex task orchestration.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.