LLM no desenvolvimento: os 4 enfoques que as equipes usam e como eles diferem
LLMs no desenvolvimento não são mais um cenário único, e sim quatro modos de trabalho diferentes. Tudo depende de duas coisas: quanto código a equipe realmente delega ao modelo e como confere o resultado depois, no olho ou por meio de testes, tipos e especificações. É essa combinação que define se a IA acelera o produto ou gera bugs caros.
Processado por IA de Habr AI; editado por Hamidun News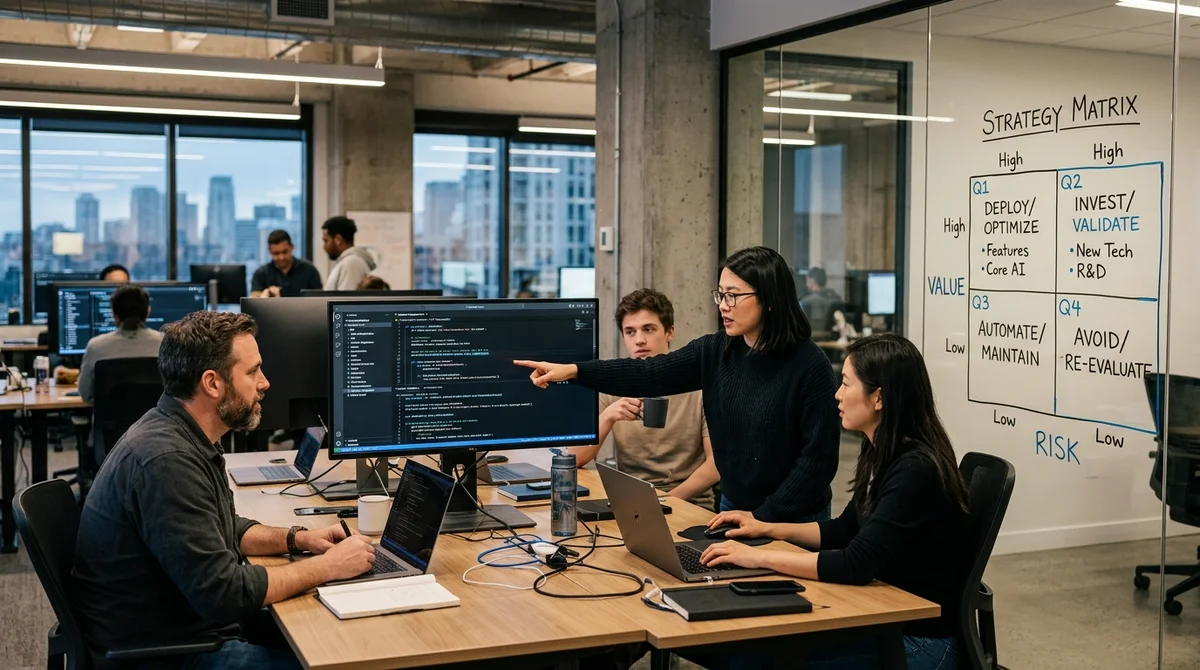
Os LLMs deixaram de ser um simples autocompletar inteligente e viraram uma ferramenta de desenvolvimento completa. Mas a expressão "programar com IA" abriga práticas bem diferentes, de sugestões pontuais até a delegação quase total do código ao modelo.
Os dois eixos principais
Para não misturar esses cenários numa categoria só, é útil olhar para dois parâmetros. O primeiro é o quanto a pessoa se envolve com o código: se escreve à mão, lê, edita e revisa, ou se na maior parte repassa a tarefa ao modelo e recebe trechos prontos ou módulos inteiros. O segundo é como a equipe verifica o resultado: pelo "feeling" e clicando manualmente, ou por mecanismos formais, como testes, tipos e especificações.
No cruzamento desses eixos surge uma matriz 2×2 simples. Ela é útil porque elimina o falso debate sobre ser "certo" ou "errado" usar IA no desenvolvimento. Na prática, a questão não é ideologia, mas modo de trabalho. A mesma ferramenta pode ser um acelerador seguro em um processo e fonte de caos em outro, se a equipe não souber quem responde pelo código e o que comprova que ele está correto.
Quatro modos de trabalho
Desse esquema saem quatro abordagens práticas, e cada uma parece normal à sua maneira para uma equipe. Elas diferem não só no grau de confiança no modelo, mas também na disciplina de engenharia exigida depois da geração. Em alguns casos o LLM continua sendo um ajudante prático ao lado do desenvolvedor; em outros, vira um executor quase autônomo. É aí que se vê por que as discussões sobre a utilidade da IA muitas vezes erram o alvo: as pessoas comparam processos que não são iguais.
- Código manual + verificação informal. O desenvolvedor escreve o essencial, e o LLM ajuda com autocompletar, refatoração e pequenos trechos. A verificação é uma execução rápida e uma inspeção visual.
- Código manual + verificação formal. A IA continua como assistente, mas toda alteração passa por testes, tipagem, linters e code review. É o modo mais previsível para uma equipe de produto.
- Código delegado + verificação informal. Funções, páginas ou serviços inteiros são confiados ao modelo, e a pessoa confere se "parece funcionar". A velocidade é alta, mas o risco de defeitos ocultos é ainda maior.
- Código delegado + verificação formal. A opção mais ambiciosa: o LLM gera grandes partes do sistema, e a qualidade se sustenta em um bom conjunto de testes, contratos e restrições rígidas do ambiente.
A principal diferença entre esses modos não é o volume de texto gerado, mas o custo do erro e a rapidez para detectá-lo. Enquanto o modelo ajuda em pontos locais, a pessoa em geral consegue notar estranhezas ao ler o código. Já quando grandes blocos de responsabilidade são entregues a ele, sem validação formal o projeto logo começa a acumular bugs, lógica duplicada e dependências pouco óbvias. Quanto maior a autonomia do modelo, mais cara fica a verificação superficial.
Por que a escolha importa
Muitas equipes confundem a velocidade do primeiro resultado com a velocidade do desenvolvimento como um todo. A verificação informal de fato dá sensação de progresso: a tela abriu, o botão clica, então está tudo pronto. Mas essa abordagem pega mal regressões, casos de borda e erros de arquitetura. Isso fica especialmente claro quando o LLM escreve com confiança um código num estilo estranho à equipe ou adiciona soluções que parecem plausíveis, mas divergem das regras internas do projeto.
Daí a conclusão prática: quanto mais se avança rumo à delegação, mais forte precisa ser a camada de verificação automática. Sem ela, a IA não reduz o trabalho, apenas o transfere no tempo: os problemas aparecem depois, quando o código já está embutido no produto. Se testes, tipos e especificações estiverem bem configurados, o modelo pode ser usado com muito mais ousadia: não só para sugestões, mas para implementações preliminares de tarefas inteiras.
O que isso significa
Não existe um jeito universal de "programar com LLM". Em vez de discutir a magia da IA, as equipes ganham mais ao escolher com honestidade o seu modo: onde a pessoa deve ler e editar o código e onde dá para delegar, e o que conta como verificação suficiente e o que não conta. É essa combinação, e não o volume das promessas, que decide se o LLM será um acelerador do desenvolvimento ou uma fábrica de erros caros.
Perguntas frequentes sobre a notícia
O que se sabe sobre Os dois eixos principais?
Para não misturar esses cenários numa categoria só, é útil olhar para dois parâmetros. O primeiro é o quanto a pessoa se envolve com o código: se escreve à mão, lê, edita e revisa, ou se na maior parte repassa a tarefa ao modelo e recebe trechos prontos ou módulos inteiros. O segundo é como a equipe verifica o resultado: pelo "feeling" e clicando manualmente, ou por mecanismos formais, como testes, tipos e especificações. No cruzamento desses eixos surge uma matriz 2×2 simples. Ela é útil porque elimina o falso debate sobre ser "certo" ou "errado" usar IA no desenvolvimento
O que se sabe sobre Quatro modos de trabalho?
Desse esquema saem quatro abordagens práticas, e cada uma parece normal à sua maneira para uma equipe. Elas diferem não só no grau de confiança no modelo, mas também na disciplina de engenharia exigida depois da geração. Em alguns casos o LLM continua sendo um ajudante prático ao lado do desenvolvedor; em outros, vira um executor quase autônomo. É aí que se vê por que as discussões sobre a utilidade da IA muitas vezes erram o alvo: as pessoas comparam processos que não são iguais. Código manual + verificação informal. O desenvolvedor escreve o essencial, e o LLM ajuda com a
Por que a escolha importa?
Muitas equipes confundem a velocidade do primeiro resultado com a velocidade do desenvolvimento como um todo. A verificação informal de fato dá sensação de progresso: a tela abriu, o botão clica, então está tudo pronto. Mas essa abordagem pega mal regressões, casos de borda e erros de arquitetura. Isso fica especialmente claro quando o LLM escreve com confiança um código num estilo estranho à equipe ou adiciona soluções que parecem plausíveis, mas divergem das regras internas do projeto. Daí a conclusão prática: quanto mais se avança rumo à delegação, mais forte precisa ser
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.