Leman Tech mostra como combinou LLM, RAG e ML clássico no suporte técnico
A Leman Tech contou como reformulou seu suporte após o aumento no número de chamados: a classificação em massa ficou com o ML clássico, e o LLM com RAG é acionado apenas para consultas complexas de domínio no ambiente corporativo. A abordagem elevou a classificação automatizada para 76%, acelerou as respostas bem-sucedidas em mais de 20 vezes e aliviou os especialistas mais caros, sem risco extra, atrasos ou automação cega.
Processado por IA de Habr AI; editado por Hamidun News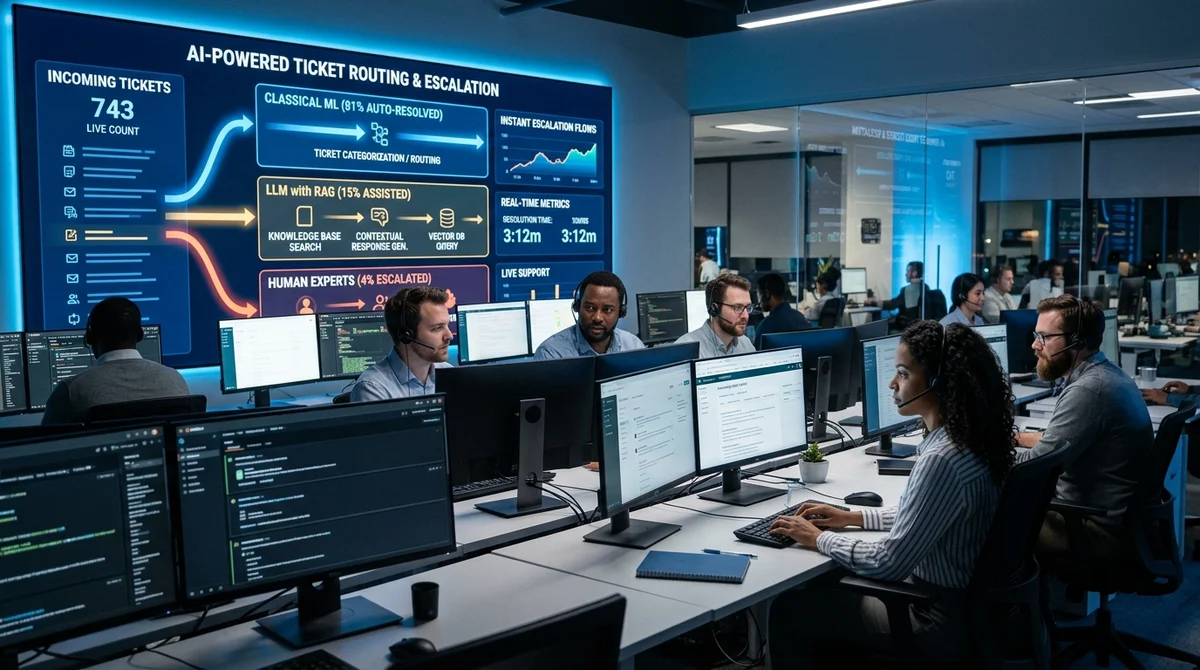
A Leman Tech contou como reformulou a automação do Service Desk após o crescimento do fluxo de chamados. A empresa não substituiu todo o suporte por um único modelo grande, e sim montou um esquema híbrido: deixou a classificação em massa para o ML clássico e acionou o LLM com RAG apenas onde ele realmente traz benefício.
Por que o ML antigo não basta
O ecossistema da Leman Tech tem mais de 500 sistemas de negócio, 2500 operações de serviço e cerca de 100 mil chamados de suporte por mês. Com essa carga, importam não só a qualidade do modelo, mas também o custo do erro, a velocidade de resposta e o custo de computação.
A stack básica com boosting e TF-IDF funcionou bem por muito tempo. Um modelo com atributos adicionais, como cargo, local de trabalho e horário do chamado, chegava a um F1 de cerca de 0,86 e cobria grande parte das rotas típicas. Mas, com o aumento do número de cenários, isso deixou de ser suficiente.
A equipe testou LSTM, GRU, BERT, RoBERTa, Electra, Yandex Foundation Models e adaptadores LoRA para LLMs abertos. Algumas abordagens perderam para o boosting nas métricas, e outras ficaram caras demais para treinar. No fim, o melhor resultado de classificação não veio de uma abordagem "pura" de LLM, mas de um transformer com atributos tabulares adicionais e additive attention: esse esquema elevou o F1 macro para 0,89 e levou melhor em conta o contexto de cada funcionário.
Onde o RAG é acionado
O LLM nessa arquitetura não tenta resolver tudo. Ele só é acionado nas classes de chamados em que o usuário precisa de uma resposta com sentido, baseada na documentação interna, e não apenas do roteamento correto do ticket.
Um exemplo é o suporte da plataforma de MLOps, em que os funcionários precisam de respostas sobre Kubeflow, Jenkins e pipelines internos. Aqui o pedido entra no chat, passa pelo classificador e cai num circuito RAG baseado em Qwen2.5 8B com um embedder personalizado. Se a resposta está na base de conhecimento, o usuário a recebe em cerca de 60 segundos. Se o modelo não tem certeza do resultado, ou a pessoa aciona o comando para falar com um especialista, o ticket vai direto para um especialista humano, sem esperar pelo SLA habitual.
Isso é importante: o LLM não é colocado como barreira extra diante da pessoa, e sim usado como uma primeira camada rápida, onde dá para economizar o tempo dos caros especialistas L4 sem perder o controle da qualidade.
- O Qwen2.5 8B é usado em versão quantizada para CPU
- O embedder personalizado foi treinado com 10 mil triplets
- A precisão da busca na base de conhecimento chegou a 92% em Hit@3
- A escalada é acionada quando o confidence score fica abaixo de 0,7
- O usuário pode migrar instantaneamente para um atendente humano
O que funcionou melhor
Uma parte à parte do caso são as autorresoluções. A equipe encontrou padrões recorrentes de chamados que podem ser encerrados sem a participação do suporte, mas não automatizou às cegas todas as respostas frequentes. Para a seleção, usou o Qwen2.5 14B: o modelo avaliava se uma pessoa conseguiria de fato resolver o problema sozinha seguindo a instrução, ou se sem um funcionário nada funcionaria. Isso eliminou falsos padrões, como a redefinição de senha, em que o e-mail é padrão, mas a ação ainda precisa ser executada por um especialista.
"Usar LLM em todo lugar, como está na moda agora, não vale a pena."
Depois dessa seleção, em produção volta a rodar não um LLM, mas um modelo leve: regressão logística. Ela aprende rápido, quase não custa nada na inferência e pode atender continuamente o fluxo de chamados.
Como resultado, a Leman Tech fala em aumento da classificação automatizada de 55% para 76%, precisão de classificação de até 92% considerando os limiares e aceleração de mais de 20 vezes nas autorresoluções bem-sucedidas e nas respostas do bot. O LLM não substituiu o ML clássico aqui, mas ocupou um lugar estreito, porém valioso, na cadeia.
O que isso significa
O caso da Leman Tech mostra bem a lógica madura atual de adoção de IA generativa no suporte: LLMs caros não precisam ser o núcleo de todo o sistema. Muitas vezes o melhor resultado vem de um híbrido, em que o ML clássico ordena rapidamente o fluxo, o RAG responde apenas em áreas de domínio complexas e uma pessoa entra sem atrito se a confiança do modelo for insuficiente. Para equipes corporativas, esse é provavelmente um caminho mais realista do que tentar migrar todo o Service Desk para um único modelo universal.
Perguntas frequentes sobre a notícia
Por que o ML antigo não basta?
O ecossistema da Leman Tech tem mais de 500 sistemas de negócio, 2500 operações de serviço e cerca de 100 mil chamados de suporte por mês. Com essa carga, importam não só a qualidade do modelo, mas também o custo do erro, a velocidade de resposta e o custo de computação. A stack básica com boosting e TF-IDF funcionou bem por muito tempo. Um modelo com atributos adicionais, como cargo, local de trabalho e horário do chamado, chegava a um F1 de cerca de 0,86 e cobria grande parte das rotas típicas. Mas, com o aumento do número de cenários, isso deixou de ser suficiente. A equ
Onde o RAG é acionado?
O LLM nessa arquitetura não tenta resolver tudo. Ele só é acionado nas classes de chamados em que o usuário precisa de uma resposta com sentido, baseada na documentação interna, e não apenas do roteamento correto do ticket. Um exemplo é o suporte da plataforma de MLOps, em que os funcionários precisam de respostas sobre Kubeflow, Jenkins e pipelines internos. Aqui o pedido entra no chat, passa pelo classificador e cai num circuito RAG baseado em Qwen2.5 8B com um embedder personalizado. Se a resposta está na base de conhecimento, o usuário a recebe em cerca de 60 segundos.
O que funcionou melhor?
Uma parte à parte do caso são as autorresoluções. A equipe encontrou padrões recorrentes de chamados que podem ser encerrados sem a participação do suporte, mas não automatizou às cegas todas as respostas frequentes. Para a seleção, usou o Qwen2.5 14B: o modelo avaliava se uma pessoa conseguiria de fato resolver o problema sozinha seguindo a instrução, ou se sem um funcionário nada funcionaria. Isso eliminou falsos padrões, como a redefinição de senha, em que o e-mail é padrão, mas a ação ainda precisa ser executada por um especialista. "Usar LLM em todo lugar, como está na
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.