Raiffeisenbank implanta assistente RAG em Kotlin, sem Python e sem novas competências
A equipe do Raiffeisenbank implantou um assistente de AI para usuários internos, como product owners, tech leads e CTOs. O sistema foi construído em Kotlin e Spring Boot, sem Python. O problema eram planilhas de Excel dispersas, e-mails e anotações. A solução foi um RAG que reuniu as respostas em um só lugar. A conclusão inesperada: a qualidade do assistente depende diretamente da qualidade da documentação. Antes de tudo, a equipe precisou colocá-la em ordem.
Processado por IA de Habr AI; editado por Hamidun News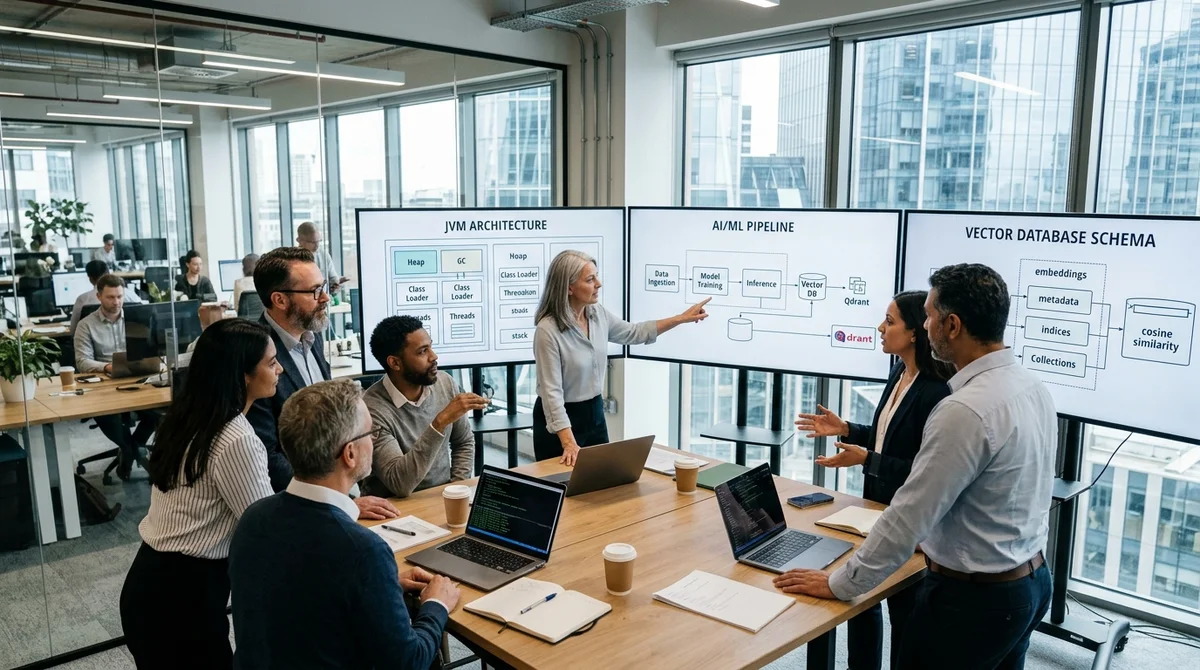
A equipe do Raiffeisenbank montou um assistente RAG em Kotlin e Spring Boot sem escrever uma única linha de Python. A experiência mostra que a stack JVM dá conta de tarefas de AI tão bem quanto a stack Python, desde que a equipe já trabalhe nela e não queira incorporar novas competências.
De onde surgiu a demanda
Os sistemas internos de um grande banco são camadas de documentos, planilhas e acordos que não estão reunidos em lugar nenhum. Product owners, tech leads, CTOs, gestores de nível B-1 e profissionais de gestão de custos perdem tempo procurando informação em vez de trabalhar no sistema: arquivos de Excel, e-mails, anotações locais, ligações para colegas. Para funcionários experientes, isso é apenas um atrito. Para os novos, é uma barreira real.
A ideia do assistente de AI é simples: reunir as respostas em um só lugar e entregá-las em linguagem comum. O objetivo é economizar de fato alguns minutos em cada consulta de trabalho, e não criar uma interface por si só. Para quem acabou de chegar, a dor é ainda maior: essas pessoas ainda não têm canais informais nem alguém a quem recorrer sem longas explicações.
Por que JVM, e não Python
Python é o padrão de fato no desenvolvimento de AI. LangChain, LlamaIndex, HuggingFace Transformers: todo o ecossistema maduro de AI cresceu em Python e funciona melhor lá. Parecia a escolha lógica para um projeto de AI.
Só que a equipe de produto do banco vive na JVM: Kotlin, Java, Spring Boot. Migrar para Python significaria contratar novos especialistas, montar uma nova stack em torno de um único produto, criar novas áreas de responsabilidade e assumir riscos adicionais na manutenção. A equipe optou por outro caminho: permanecer no ambiente que já conhece. Foi uma decisão consciente, não por inércia.
Os principais argumentos a favor da JVM:
- Manutenção e escalabilidade continuam dentro da equipe existente
- Não é preciso contratar desenvolvedores Python nem requalificar os atuais
- O Spring Boot oferece infraestrutura pronta: segurança, logging, deploy
- O LLM é conectado via API, então o modelo de linguagem não exige Python no servidor
- O ecossistema JVM tem bibliotecas funcionais para embeddings e bancos vetoriais
Resultado: um pipeline RAG completo em Kotlin, sem a necessidade de trazer novas competências por causa de uma única ferramenta interna.
A documentação como problema oculto
Uma das principais lições do projeto: o RAG funciona exatamente tão bem quanto os dados de origem. Quando o assistente começou a dar respostas imprecisas ou contraditórias, a equipe descobriu que a causa não estava no modelo nem na arquitetura do pipeline. Estava nos próprios documentos.
Planilhas de Excel dispersas com versões diferentes dos mesmos dados, instruções desatualizadas que ninguém revisava havia anos, registros duplicados vindos de fontes distintas: tudo isso ficou evidente assim que a AI passou a se apoiar nesse material. O projeto deu à equipe um motivo para organizar um conhecimento que antes apenas se acumulava, sem estrutura nem limpeza periódica.
Na prática, o assistente de AI virou uma ferramenta de auditoria da documentação, embora ninguém tivesse planejado isso no início. Parte do esforço foi para a organização das fontes, e não para o desenvolvimento. Esse é um componente pouco óbvio, mas praticamente inevitável, de qualquer implantação de RAG.
O que isso significa
Equipes JVM não são obrigadas a migrar para Python por causa de AI. Se a expertise e a infraestrutura já existem, dá para usá-las diretamente. Um pipeline RAG em Kotlin e Spring Boot pode ser montado sem perdas fundamentais de funcionalidade e com controle total dentro da stack habitual.
Para bancos e fintechs, onde a JVM é o padrão de fato, a experiência do Raiffeisenbank é um precedente importante: tarefas de AI podem ser resolvidas sem trocar de ferramentas.
- 1 de nov. de 2026Pika Labs lança o H3 Flex, modelo de vídeo aberto: 6 passos em vez de 50
- 1 de nov. de 2026Tokenizador do BERT na Hugging Face fica 50 vezes mais rápido ao eliminar trabalho desnecessário com ASCII
- 1 de nov. de 2026Universidade de Illinois reúne 12 151 problemas abertos e testa se a IA consegue resolvê-los
- 1 de nov. de 2026Duplicação de camadas no treinamento elevou o GSM8K de 12% para 19% em modelo de 3B
Perguntas frequentes sobre a notícia
O que se sabe sobre De onde surgiu a demanda?
Os sistemas internos de um grande banco são camadas de documentos, planilhas e acordos que não estão reunidos em lugar nenhum. Product owners, tech leads, CTOs, gestores de nível B-1 e profissionais de gestão de custos perdem tempo procurando informação em vez de trabalhar no sistema: arquivos de Excel, e-mails, anotações locais, ligações para colegas. Para funcionários experientes, isso é apenas um atrito. Para os novos, é uma barreira real. A ideia do assistente de AI é simples: reunir as respostas em um só lugar e entregá-las em linguagem comum. O objetivo é economizar d
Por que JVM, e não Python?
Python é o padrão de fato no desenvolvimento de AI. LangChain, LlamaIndex, HuggingFace Transformers: todo o ecossistema maduro de AI cresceu em Python e funciona melhor lá. Parecia a escolha lógica para um projeto de AI. Só que a equipe de produto do banco vive na JVM: Kotlin, Java, Spring Boot. Migrar para Python significaria contratar novos especialistas, montar uma nova stack em torno de um único produto, criar novas áreas de responsabilidade e assumir riscos adicionais na manutenção. A equipe optou por outro caminho: permanecer no ambiente que já conhece. Foi uma decisã
O que se sabe sobre A documentação como problema oculto?
Uma das principais lições do projeto: o RAG funciona exatamente tão bem quanto os dados de origem. Quando o assistente começou a dar respostas imprecisas ou contraditórias, a equipe descobriu que a causa não estava no modelo nem na arquitetura do pipeline. Estava nos próprios documentos. Planilhas de Excel dispersas com versões diferentes dos mesmos dados, instruções desatualizadas que ninguém revisava havia anos, registros duplicados vindos de fontes distintas: tudo isso ficou evidente assim que a AI passou a se apoiar nesse material. O projeto deu à equipe um motivo para
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.