Habr AI mostra como uma arquitetura de reflexos para agentes LLM elimina o lag e chega a 60 fps
O Habr AI mostrou como resolver o principal problema dos agentes de AI em games, assistentes e robótica: o atraso de 1–3 segundos. A equipe dividiu o sistema em dois circuitos, um reflexo e rápido, e outro mais lento, baseado em LLM, dedicado ao reasoning. Com isso, o agente consegue reagir em milissegundos, mudar de comportamento na hora e aprender durante a própria sessão. A sensação de interação viva se mantém mesmo em cenas dinâmicas.
Processado por IA de Habr AI; editado por Hamidun News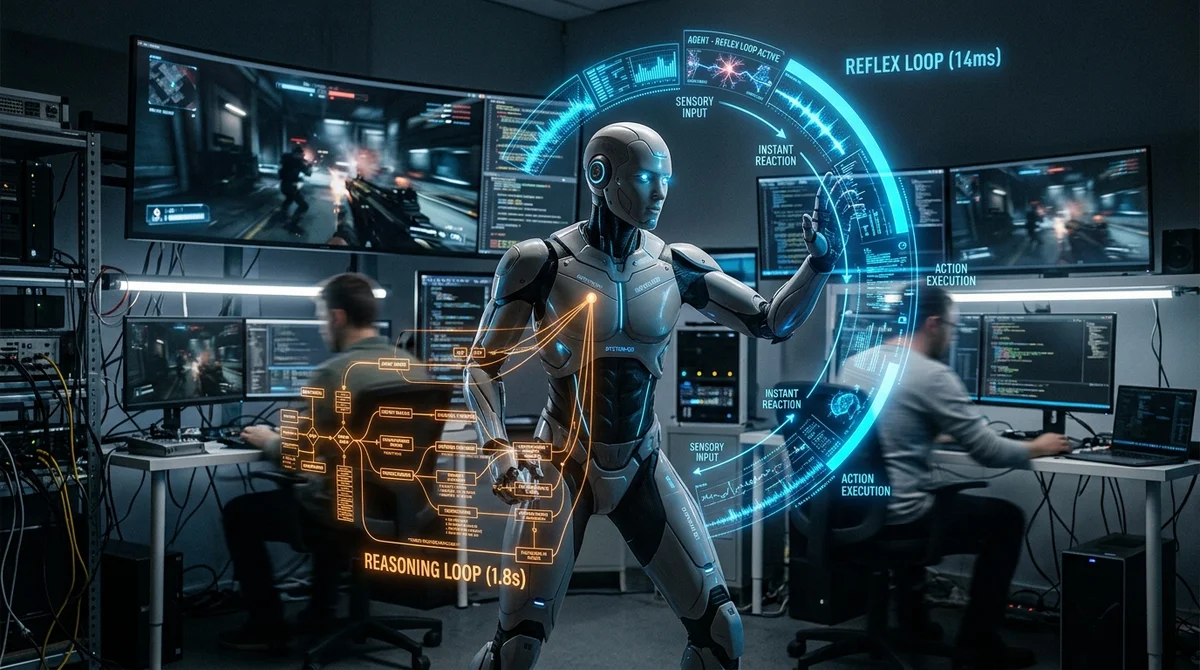
O Habr AI publicou uma análise de uma arquitetura que dá aos agentes LLM uma espécie de "medula espinhal": uma camada rápida de reflexos sobre o reasoning, que é mais lento. A ideia é eliminar a pausa habitual de 1–3 segundos e fazer com que NPCs de games, assistentes de voz e robôs reajam de forma quase instantânea.
Onde a velocidade quebra
O problema é conhecido por quem já tentou integrar um grande modelo de linguagem a um ambiente interativo. O agente recebe o áudio, monta o contexto, envia a requisição, espera a resposta do modelo e a converte em animação ou ação. Tudo isso leva tempo demais. Num chat, esse atraso é tolerável. Num jogo, num robô ou numa interface ao vivo, é um fracasso de UX: o usuário não enxerga inteligência, enxerga travamento. Por isso, mesmo um modelo forte muitas vezes passa a impressão de ser "inteligente, mas lento".
Os autores comparam esse tipo de integração a instalar um motor de ônibus espacial numa carroça: a potência computacional existe, mas não se converte em comportamento real. No protótipo deles, a atenção do público foi para a camada visual, e não para o motor em si. Em vez de discutir o inference, a equipe ouviu críticas à saída de debug ainda crua e à qualidade dos quadros. Ou seja, a discussão girou em torno da imagem, quando a verdadeira notícia era que o sistema já tentava acompanhar o ritmo do tempo real.
"É cedo para exibir '60 FPS de verdade'.
O que vocês têm aí é só um caleidoscópio de quadros desordenados, imagem borrada e dedos tortos."
Sistema 1 e 2
A saída foi a Dual-Process Architecture, que divide o agente em um circuito rápido e outro lento. A primeira camada funciona como um sistema reflexo: monitora eventos e dispara reações imediatas, sem esperar o raciocínio completo do modelo. A segunda fica a cargo do LLM e cuida das tarefas mais custosas: interpretar contextos complexos, planejar, escolher falas e reorganizar o comportamento. Assim, o agente pode reagir primeiro e só depois "pensar", como faz uma pessoa no mundo real.
Nessa abordagem, o ponto crítico é não obrigar o LLM a ser o único centro executivo. O reasoning lento funciona bem onde é preciso profundidade, mas é inadequado para movimentos, microgestos, giros rápidos de câmera, reações a colisões ou respostas de voz curtas. A arquitetura de duas velocidades elimina esse conflito: a interface e o corpo do agente operam em milissegundos, enquanto o sentido e a estratégia rodam num ciclo mais longo. É esse desacoplamento que permite não derrubar o frame rate nem fazer o usuário esperar por cada gesto ou fala.
Segundo os autores, o esquema também traz dois bônus difíceis de obter num pipeline monolítico: a personalidade pode ser trocada na hora, e novos padrões de comportamento podem ser absorvidos durante a execução. Isso é especialmente importante para NPCs, assistentes e robótica, em que o agente precisa não apenas responder, mas se adaptar continuamente ao ambiente. No esquema tradicional, essas mudanças exigem uma nova requisição ao modelo e esbarram de novo na latência.
Efeito prático da abordagem
Ao tirar os reflexos do pesado circuito do LLM, muda não só a latência, mas também a sensação de que o sistema está "vivo". O usuário deixa de esperar a inteligência completar a cadeia inteira e passa a ver um comportamento contínuo. Para as equipes de produto, é uma mudança relevante: a qualidade do agente passa a ser medida não pela beleza de um quadro de demo, mas pela naturalidade com que ele sustenta o ritmo da interação. Em produtos interativos, isso costuma pesar mais que um texto perfeito, porque a sensação de presença se desfaz antes que o usuário consiga avaliar a profundidade da resposta.
- Reações instantâneas a eventos, sons, obstáculos e comandos
- Integração fluida entre geração, animação e controle
- Troca rápida de papel, personalidade ou estilo de resposta
- Aprendizado e ajuste de comportamento sem reiniciar o agente por completo
Na prática, a equipe propõe enxergar o LLM não como o único cérebro do sistema, mas como uma de suas camadas. Isso muda a ótica de engenharia: em vez de uma luta interminável contra a latência de rede e o inference pesado, abre-se a possibilidade de projetar um motor separado para o tempo real. Sim, a visualização do protótipo pode estar crua. Mas, se a camada reflexa já sustenta o ritmo, o polimento de gráficos, mãos e quadros pode ficar para a próxima iteração.
O que isso significa
O caso mostra bem para onde caminham os agentes de AI: sistemas híbridos, em que reflexos rápidos ficam separados do reasoning lento. Para quem desenvolve games, assistentes de voz e embodied AI, esse é um passo quase obrigatório. Sem ele, até o melhor LLM vai parecer lento e desajeitado.
- 28 de out. de 2026Anthropic revela como constrói o Claude com o próprio Claude: cérebro separado das mãos
- 28 de out. de 2026Bayer lança mecanismo multiagente no AgentCore: 80% das dúvidas sem engenheiros
- 28 de out. de 2026Liquid AI lança o LFM2.5-24B-A2B: um modelo para agentes com 2B de parâmetros ativos
- 28 de out. de 2026AgentOrch: plano de IA feito com antecedência agora perde por apenas 8,5 pontos para a execução passo a passo
Perguntas frequentes sobre a notícia
Onde a velocidade quebra?
O problema é conhecido por quem já tentou integrar um grande modelo de linguagem a um ambiente interativo. O agente recebe o áudio, monta o contexto, envia a requisição, espera a resposta do modelo e a converte em animação ou ação. Tudo isso leva tempo demais. Num chat, esse atraso é tolerável. Num jogo, num robô ou numa interface ao vivo, é um fracasso de UX: o usuário não enxerga inteligência, enxerga travamento. Por isso, mesmo um modelo forte muitas vezes passa a impressão de ser "inteligente, mas lento". Os autores comparam esse tipo de integração a instalar um motor d
O que se sabe sobre Sistema 1 e 2?
A saída foi a Dual-Process Architecture, que divide o agente em um circuito rápido e outro lento. A primeira camada funciona como um sistema reflexo: monitora eventos e dispara reações imediatas, sem esperar o raciocínio completo do modelo. A segunda fica a cargo do LLM e cuida das tarefas mais custosas: interpretar contextos complexos, planejar, escolher falas e reorganizar o comportamento. Assim, o agente pode reagir primeiro e só depois "pensar", como faz uma pessoa no mundo real. Nessa abordagem, o ponto crítico é não obrigar o LLM a ser o único centro executivo. O reas
O que se sabe sobre Efeito prático da abordagem?
Ao tirar os reflexos do pesado circuito do LLM, muda não só a latência, mas também a sensação de que o sistema está "vivo". O usuário deixa de esperar a inteligência completar a cadeia inteira e passa a ver um comportamento contínuo. Para as equipes de produto, é uma mudança relevante: a qualidade do agente passa a ser medida não pela beleza de um quadro de demo, mas pela naturalidade com que ele sustenta o ritmo da interação. Em produtos interativos, isso costuma pesar mais que um texto perfeito, porque a sensação de presença se desfaz antes que o usuário consiga avaliar a
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.