OpenAI e Grok perdem para um RAG personalizado no Agentic RAG Legal Challenge
No Agentic RAG Legal Challenge, uma equipe comparou as bases prontas da OpenAI e do Grok, CAG, BM25 e seu próprio pipeline híbrido. Mesmo modelos fortes perdem sem grounding preciso: conta não só a resposta, mas também citar a página certa. O Mac Studio M3 Ultra local deu conta do parsing e dos embeddings, mas o contexto dos chunks precisou ser gerado por uma API externa.
Processado por IA de Habr AI; editado por Hamidun News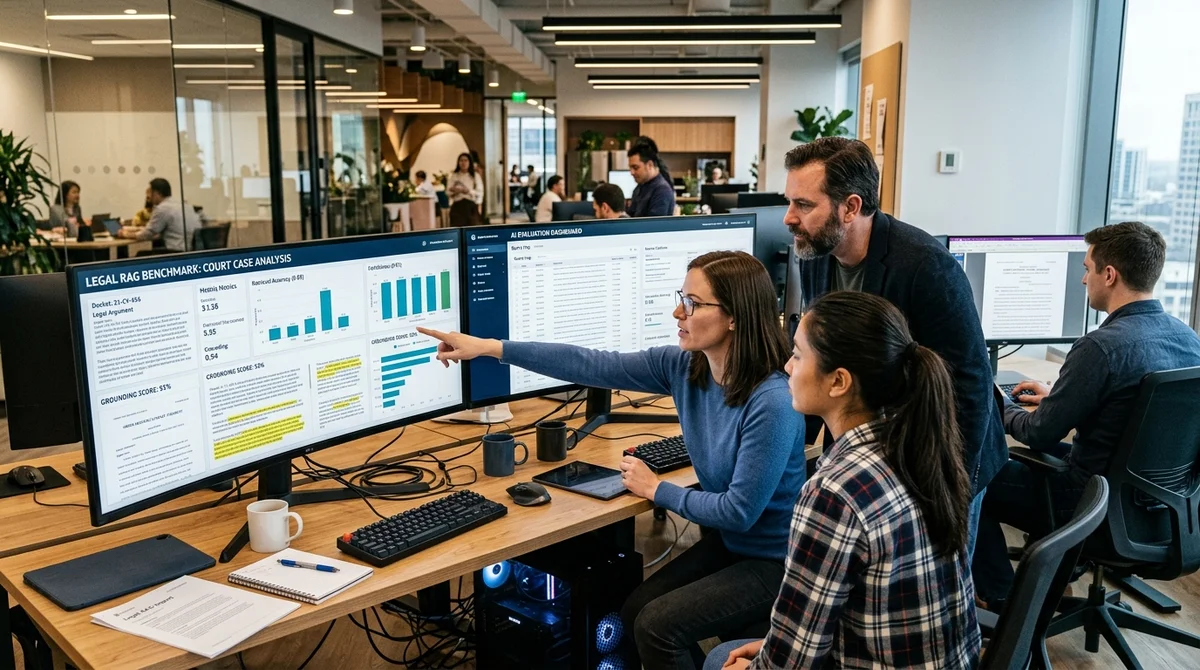
Os autores do artigo explicam como a equipe enfrentou o Agentic RAG Legal Challenge, uma competição internacional de perguntas e respostas baseadas em PDFs jurídicos. A conclusão principal é incômoda e prática: quem vence não é o nome famoso do modelo, mas a capacidade de vincular a resposta com precisão à página certa do documento.
Como os sistemas foram avaliados
Mais de 300 equipes participaram do desafio, e o corpus era formado por decisões judiciais reais, leis e atos regulatórios do DIFC em inglês. Primeiro, os participantes receberam 30 documentos e 100 perguntas de aquecimento; depois, quase 300 documentos e 900 perguntas para a final. As perguntas eram de vários tipos: datas, números, nomes, listas, sim ou não e respostas livres curtas. Mas o mais importante não era só a precisão da formulação, e sim a métrica Grounding: se as páginas indicadas coincidiam com aquelas de onde a resposta realmente saiu.
"Até uma resposta perfeita é zerada se indicar a página errada."
Para isso, a equipe montou seu próprio pipeline: converteu os PDFs em Markdown, dividiu-os em chunks semânticos, gerou contexto para cada um, calculou embeddings densos e esparsos (sparse) e guardou tudo no Qdrant. Parte do trabalho rodou localmente em um Mac Studio M3 Ultra. A máquina resolveu rápido o parsing de 30 PDFs e os embeddings locais, mas a geração de contexto para os chunks ficou lenta demais: por causa do prefill longo, cada chunk levava de 15 a 20 segundos, então essa etapa precisou ser transferida para uma API externa.
Quem falhou primeiro
Primeiro, os autores testaram o caminho mais preguiçoso: simplesmente carregar os documentos na base de conhecimento embutida da OpenAI. À primeira vista, o resultado parecia decente, mas as métricas deram Total de 0.362: as respostas muitas vezes eram boas, mas a citação das páginas estragava tudo.
Em seguida, testaram o CAG, em que quase todo o corpus é enviado ao modelo de uma vez, sem busca por trechos. Um experimento com Qwen 3.5 Flash e contexto de até 1 milhão de tokens mostrou que o CAG não é inútil: a precisão foi alta, mas o Grounding falhou de novo. O BM25 puro foi ainda pior e ficou como a tentativa mais fraca.
Dessa rodada saíram algumas conclusões desagradáveis, porém úteis:
- bases de conhecimento embutidas de grandes empresas não garantem boa citação;
- o CAG pode responder com precisão, mas, sem vinculação cuidadosa às páginas, perde na nota final;
- o BM25 clássico, sozinho, já não dá conta de perguntas jurídicas complexas;
- o RAG híbrido com um bom reranking se mostrou mais forte que as soluções embutidas da OpenAI e do Grok.
O sistema próprio, o MORAG, também não impressionou de início: um Qwen local pequeno mantinha mal a precisão e desandava principalmente em perguntas multidocumento. A virada veio com a mudança para o Grok via OpenRouter e uma seleção de chunks mais rigorosa. No aquecimento, a equipe subiu de um Total de 0.362 nas primeiras rodadas para 0.780 na tentativa final, e o Grounding passou de cerca de 0.45 para 0.90. Esse avanço, e não a troca de um modelo da moda por outro, foi o principal fator de progresso.
O que realmente ajudou
O maior ganho não veio de "melhorias de qualidade" abstratas, mas de algumas decisões de engenharia bem concretas. A equipe separou os modos reasoning e non-reasoning por tipo de pergunta, adicionou um ciclo agêntico com nova busca quando faltavam dados e montou separadamente um gold set para checar as respostas às 900 perguntas. Isso permitiu não atirar no escuro na final e achar rápido erros sistemáticos, como a interpretação equivocada da formulação sobre um recurso apresentado, mas rejeitado.
- o modelo reasoning foi mantido para boolean, name e names, em que o non-reasoning perdia de 8% a 16% de precisão;
- para date, number e free_text, usou-se o modo non-reasoning, mais rápido, sem queda perceptível;
- à busca foram adicionadas as primeiras 1–3 páginas dos documentos citados na pergunta, porque ali costumam estar os dados-chave do caso;
- os resumos e os vetores sparse foram refeitos para o domínio jurídico;
- os chunks foram reduzidos para caber no limite do embedder FRIDA, que corta tudo que passa de 512 tokens.
Na fase final, o MORAG ficou atrás do golden submission preparado no Total geral, 0.603 contra 0.631, mas o superou em três das cinco métricas: precisão das respostas determinísticas, qualidade das respostas livres e velocidade. A derrota veio, mais uma vez, do Grounding. É um detalhe importante: o sistema RAG em si já respondia melhor que o gabarito "manual", mas a vinculação técnica da resposta à página correta ainda ficava para trás.
O que isso significa
A história mostra que o CAG não matou o RAG, que o Mac Studio serve para parte de um pipeline local e que as bases prontas da OpenAI e do Grok não substituem o ajuste a um corpus específico. Se os dados são complexos, quem ganha não é a marca mais barulhenta, mas a equipe que sabe medir erros, controlar o chunking e levar o Grounding a um estado funcional.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Perguntas frequentes sobre a notícia
Como os sistemas foram avaliados?
Mais de 300 equipes participaram do desafio, e o corpus era formado por decisões judiciais reais, leis e atos regulatórios do DIFC em inglês. Primeiro, os participantes receberam 30 documentos e 100 perguntas de aquecimento; depois, quase 300 documentos e 900 perguntas para a final. As perguntas eram de vários tipos: datas, números, nomes, listas, sim ou não e respostas livres curtas. Mas o mais importante não era só a precisão da formulação, e sim a métrica Grounding: se as páginas indicadas coincidiam com aquelas de onde a resposta realmente saiu. "Até uma resposta perfei
O que se sabe sobre Quem falhou primeiro?
Primeiro, os autores testaram o caminho mais preguiçoso: simplesmente carregar os documentos na base de conhecimento embutida da OpenAI. À primeira vista, o resultado parecia decente, mas as métricas deram Total de 0.362: as respostas muitas vezes eram boas, mas a citação das páginas estragava tudo. Em seguida, testaram o CAG, em que quase todo o corpus é enviado ao modelo de uma vez, sem busca por trechos. Um experimento com Qwen 3.5 Flash e contexto de até 1 milhão de tokens mostrou que o CAG não é inútil: a precisão foi alta, mas o Grounding falhou de novo. O BM25 puro f
O que realmente ajudou?
O maior ganho não veio de "melhorias de qualidade" abstratas, mas de algumas decisões de engenharia bem concretas. A equipe separou os modos reasoning e non-reasoning por tipo de pergunta, adicionou um ciclo agêntico com nova busca quando faltavam dados e montou separadamente um gold set para checar as respostas às 900 perguntas. Isso permitiu não atirar no escuro na final e achar rápido erros sistemáticos, como a interpretação equivocada da formulação sobre um recurso apresentado, mas rejeitado. o modelo reasoning foi mantido para boolean, name e names, em que o non-reason
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.