Rutube deixa o piloto com Whisper e passa a ter plataforma própria de legendas e reconhecimento de fala
A Rutube mostrou por que simplesmente rodar o Whisper não bastou para gerar legendas em vídeos de usuários. Depois do piloto, o serviço precisou lidar com milhões de vídeos novos, gravações de até 24 horas, áudio com ruído e vários idiomas. A equipe acabou adotando uma arquitetura de microsserviços e um sistema ASR próprio, chegando a cerca de 1200 vídeos por hora por ASR.
Processado por IA de Habr AI; editado por Hamidun News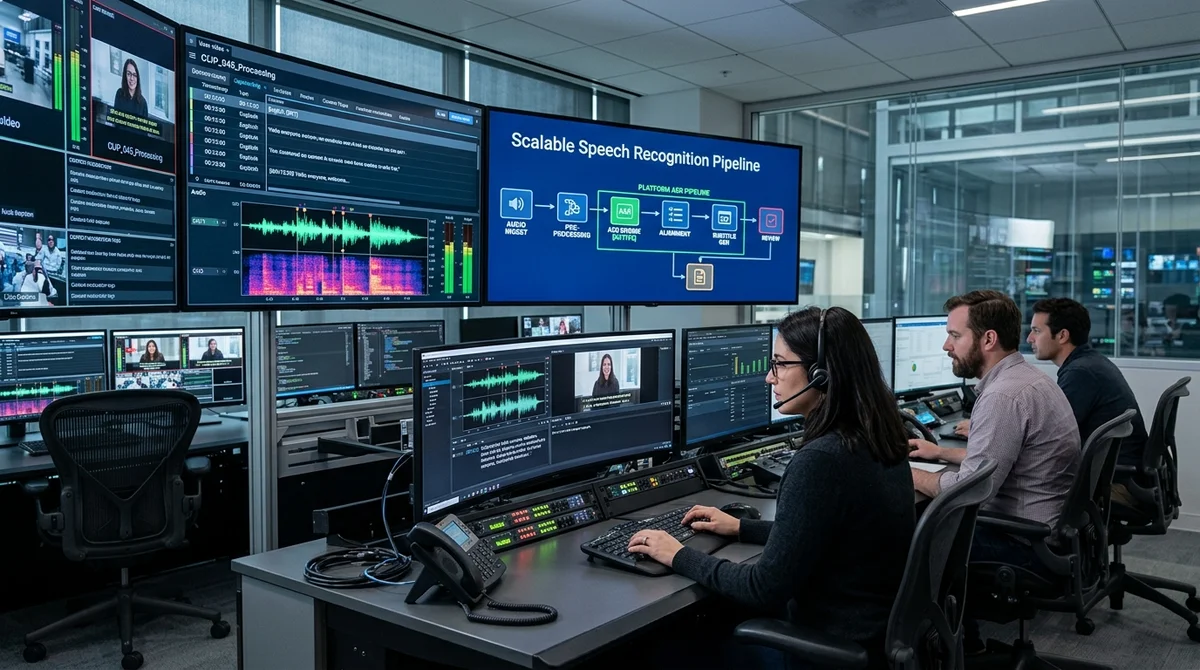
A Rutube descreveu como lançou legendas automáticas para vídeos de usuários: primeiro com um piloto rápido no Whisper e depois com uma plataforma ASR própria. A equipe chegou a isso ao perceber que reconhecer fala em uma demo e processar de forma estável todo o fluxo de conteúdo são tarefas muito diferentes.
Por que o Whisper não bastou
No início, o Whisper se mostrou uma opção prática para testar a hipótese. Ele permitiu montar rapidamente um primeiro serviço, colocar as legendas em produção e entender que a função realmente era necessária para os usuários. Mas, depois do lançamento, surgiram limitações difíceis de enxergar na fase de piloto: a plataforma recebe milhões de vídeos novos, alguns com até 24 horas, o áudio pode ter ruído e o idioma não é conhecido de antemão. Somam-se a isso os requisitos de qualidade do texto e limites rígidos de velocidade de processamento, pois as legendas precisam aparecer não em algum momento futuro, mas no ritmo de trabalho do serviço.
Entre "reconhecer fala" e "fazer legendas para todo o conteúdo" existe
uma enorme camada de trabalho.
Essa distância foi a principal conclusão da equipe. Para vídeos de usuários, não basta passar a faixa de áudio por um modelo pronto e salvar o resultado. É preciso toda a estrutura em volta do reconhecimento: tratamento de arquivos longos, resistência a áudio ruim, controle de qualidade do texto, gerenciamento de filas e desempenho previsível sob grande fluxo. Caso contrário, até um bom modelo de ASR vira um gargalo que não aguenta a carga industrial.
No que o sistema se transformou
No fim, a tarefa deixou de ser "mais um serviço baseado em ASR" e virou uma plataforma de legendas completa. A Rutube diz que, para isso, teve de adotar uma arquitetura de microsserviços e um sistema próprio de reconhecimento de fala. A abordagem não é por causa de uma stack da moda, mas pela separação de responsabilidades: uma parte do sistema cuida do recebimento e da preparação do vídeo, outra do reconhecimento em si, e uma terceira da montagem e da entrega do resultado. Em grandes volumes isso é crítico, porque permite escalar componentes de forma independente e evita derrubar todo o pipeline por sobrecarga em um ponto.
Uma plataforma assim precisa atender a vários requisitos ao mesmo tempo:
- Receber um fluxo de milhões de vídeos novos sem intervenção manual
- Processar vídeos de até 24 horas sem quebrar o pipeline
- Trabalhar com idioma desconhecido e áudio ruidoso de usuários
- Manter a qualidade do texto em nível suficiente para publicação
- Respeitar os limites de velocidade e custo de processamento
Nesse contexto, migrar para um ASR próprio parece lógico. Quando o produto roda sobre UGC em massa, um modelo externo universal ajuda a começar, mas serve mal para ajuste fino a dados reais, restrições de infraestrutura e métricas-alvo. Um sistema próprio dá mais controle sobre velocidade, qualidade, recursos e sobre como exatamente o reconhecimento se comporta em casos difíceis, que para uma plataforma de vídeo são a norma, e não a exceção.
Como a velocidade foi alcançada
O número mais marcante da história da Rutube é o desempenho de cerca de 1200 vídeos por hora por ASR. É uma referência importante, porque em produção a qualidade do reconhecimento não pode ser vista separada da capacidade de vazão. Se o sistema entrega bom texto, mas acumula uma fila de milhares de vídeos, o usuário ganha pouco. Se o pipeline é rápido, mas instável com vídeos longos ou áudio ruim, o produto volta a quebrar na operação real. Por isso, a arquitetura é tão importante quanto o próprio modelo.
Por trás desse número não há um único algoritmo bem-sucedido, mas uma série de decisões de engenharia: como cortar e alimentar o áudio, como distribuir as tarefas, como não perder tempo em etapas ineficientes e como manter os recursos sob controle. O aspecto econômico também pesa. Quanto maior o throughput por instância de ASR, mais fácil é escalar o serviço sem um salto nos custos de infraestrutura. Para plataformas com fluxo constante de UGC, isso já não é questão de conveniência, mas a economia básica do produto.
O que isso significa
A história da Rutube mostra bem a fronteira entre um protótipo rápido de IA e um produto maduro. Um modelo pronto como o Whisper ajuda a começar depressa, mas um serviço de massa exige arquitetura própria, controle de qualidade e otimização para cargas reais. Para quem constrói funções de IA sobre conteúdo de usuários, é um sinal direto: o gargalo normalmente não está em um único modelo, mas em todo o pipeline ao redor dele.
Perguntas frequentes sobre a notícia
Por que o Whisper não bastou?
No início, o Whisper se mostrou uma opção prática para testar a hipótese. Ele permitiu montar rapidamente um primeiro serviço, colocar as legendas em produção e entender que a função realmente era necessária para os usuários. Mas, depois do lançamento, surgiram limitações difíceis de enxergar na fase de piloto: a plataforma recebe milhões de vídeos novos, alguns com até 24 horas, o áudio pode ter ruído e o idioma não é conhecido de antemão. Somam-se a isso os requisitos de qualidade do texto e limites rígidos de velocidade de processamento, pois as legendas precisam aparece
O que se sabe sobre No que o sistema se transformou?
No fim, a tarefa deixou de ser "mais um serviço baseado em ASR" e virou uma plataforma de legendas completa. A Rutube diz que, para isso, teve de adotar uma arquitetura de microsserviços e um sistema próprio de reconhecimento de fala. A abordagem não é por causa de uma stack da moda, mas pela separação de responsabilidades: uma parte do sistema cuida do recebimento e da preparação do vídeo, outra do reconhecimento em si, e uma terceira da montagem e da entrega do resultado. Em grandes volumes isso é crítico, porque permite escalar componentes de forma independente e evita d
Como a velocidade foi alcançada?
O número mais marcante da história da Rutube é o desempenho de cerca de 1200 vídeos por hora por ASR. É uma referência importante, porque em produção a qualidade do reconhecimento não pode ser vista separada da capacidade de vazão. Se o sistema entrega bom texto, mas acumula uma fila de milhares de vídeos, o usuário ganha pouco. Se o pipeline é rápido, mas instável com vídeos longos ou áudio ruim, o produto volta a quebrar na operação real. Por isso, a arquitetura é tão importante quanto o próprio modelo. Por trás desse número não há um único algoritmo bem-sucedido, mas uma
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.