Sistema baseado em LLM reduz de 2 horas para 5 minutos o preparo de cartas de controle em uma siderúrgica
Em uma usina metalúrgica, um sistema de LLM foi treinado para ler digitalizações de normas GOST e montar cartas de controle em 3–5 minutos, em vez de duas horas. O prompt universal fracassou. A solução que funcionou foi um conjunto de regras separado para cada documento, 20 GOSTs prioritários e nove iterações de ajuste. O processo ficou 24 vezes mais rápido, e as regras foram levadas para o Excel para que os próprios tecnólogos possam editá-las.
Processado por IA de Habr AI; editado por Hamidun News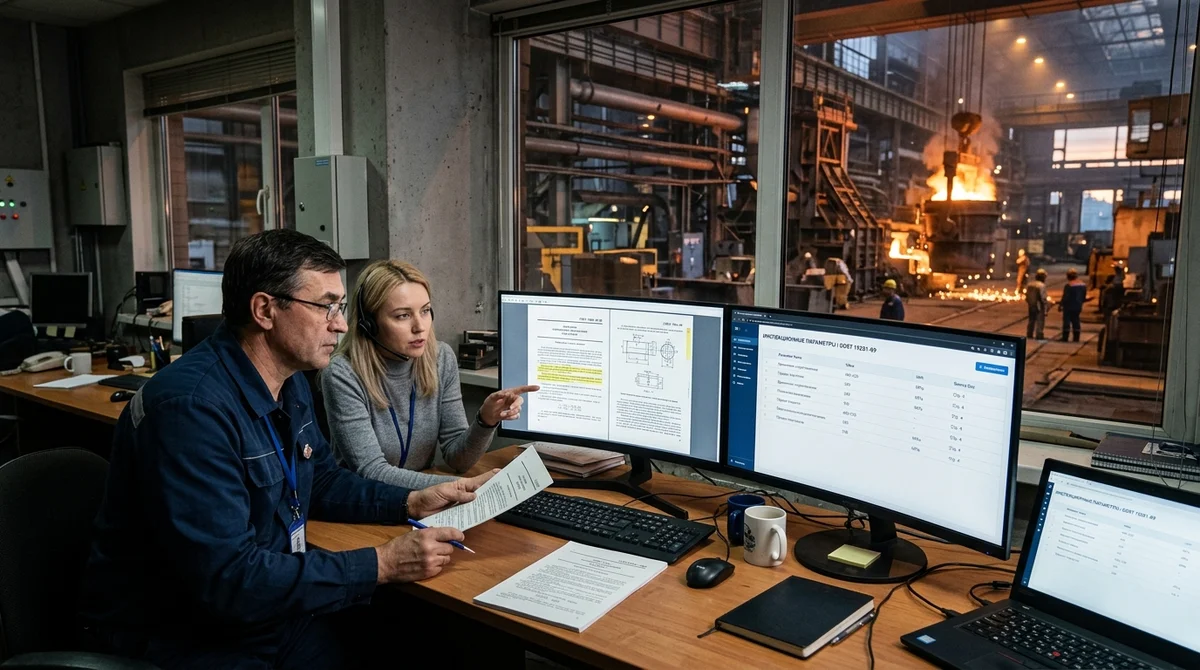
Um caso prático de uma empresa metalúrgica mostra que os grandes modelos de linguagem já fazem mais do que responder perguntas: também conseguem tirar dos engenheiros a pesada rotina normativa. Um sistema foi treinado para ler digitalizações de GOSTs da era soviética e montar automaticamente cartas de controle em 3–5 minutos, em vez de mais de duas horas de trabalho manual. Em esforço de trabalho, segundo o autor do projeto, isso elimina um volume de tarefas comparável ao de três tecnólogos.
O problema era bem concreto. A empresa de ciclo completo tem cerca de 3200 funcionários, e sua nomenclatura passa de 4500 itens e não para de crescer. Para cada item, o tecnólogo precisava abrir um GOST, um OST ou outro documento normativo, localizar as tabelas e notas relevantes, inserir parâmetros como a classe do aço, o diâmetro do tarugo e o grupo, e depois preencher manualmente mais de 40 parâmetros de controle.
A dificuldade é que há mais de duzentos documentos, e boa parte deles existe como PDFs digitalizados pouco práticos, da época soviética. A primeira ideia foi um parser comum, mas ela logo foi descartada. O formato das normas é heterogêneo demais: em um documento os valores necessários estão em linhas de tabelas, em outro ficam escondidos nas notas, em um terceiro estão espalhados pelo texto com remissões a outras seções.
Um esquema simples de extração por modelo quebra aqui, porque a tarefa exige entender o sentido do documento, e não só sua estrutura visual. Por isso o autor partiu para os LLMs e montou um esquema em que o modelo recebe o PDF da norma, os parâmetros da nomenclatura e um conjunto de regras sobre como determinar cada parâmetro de controle. A hipótese seguinte parecia lógica: criar um único prompt universal para todos os documentos normativos.
No primeiro teste, a abordagem deu um resultado razoável. Segundo o autor, o Claude Sonnet 4.6 em modo thinking identificou corretamente 85% dos parâmetros de um GOST, e o GPT 5.
4, 72%. Mas, nos documentos seguintes, a universalidade desmoronou. Os modelos se confundiam com tabelas aninhadas, interpretavam mal condições de contorno como «no mínimo» e «no máximo», e às vezes pulavam constantes ou vínculos entre seções.
Ficou claro que uma abordagem geral elegante era pior aqui do que uma arquitetura mais estreita, porém controlável. A solução surgiu após analisar a nomenclatura pelo princípio de Pareto. Descobriu-se que 80% dos itens da usina são descritos por cerca de 18% dos GOSTs.
Para o piloto, foram escolhidos os 20 documentos mais usados e, para cada um, criado um prompt próprio com regras concretas: onde procurar o parâmetro, em que tabela ou seção ele está descrito e como interpretar os casos duvidosos. O sistema recebia o PDF e as características do produto e devolvia uma tabela com o parâmetro, o valor e a referência ao ponto da norma. Quando aparecia um erro, o autor enviava uma captura de tela à conversa, mostrava a resposta correta e pedia que a regra fosse atualizada para que a falha não se repetisse.
O ajuste levou nove iterações e 14 dias úteis, e depois disso a extração de parâmetros dos GOSTs selecionados passou a funcionar sem erros. Agora o projeto sai do modo experimental para um formato mais adequado à produção. As regras estão sendo tiradas dos prompts e levadas para uma planilha Excel, para que os tecnólogos possam editar a lógica sem mergulhar em engenharia de prompts.
O modelo passa a receber não só o PDF e os parâmetros do produto, mas também essa tabela de regras, e entrega os dados em formato pronto para carga no sistema de informação interno da empresa. Essa camada torna a solução escalável: dá para incluir novas normas aos poucos sem amarrar todo o suporte a um único desenvolvedor. A principal conclusão do caso é simples: na indústria, os LLMs funcionam melhor não como uma «inteligência universal para todas as situações», mas como uma ferramenta bem ajustada a uma classe específica de documentos.
Se a empresa começa pelas normas mais frequentes, obriga o modelo a indicar a fonte de cada parâmetro e mantém as regras editáveis por especialistas da área, a IA deixa de ser demonstração e vira um mecanismo de produção com economia clara. Essa abordagem pode muito bem se repetir não só na metalurgia, mas também na engenharia mecânica, na construção, na química, na farmacêutica e na energia — em qualquer lugar onde pessoas ainda transferem dados de regulamentos para sistemas de trabalho à mão.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.