ClawRouter reduziu o gasto com a API de LLM de US$ 47 para US$ 1,80 em uma semana: análise do roteador inteligente
Uma conta semanal de US$ 47 com a API de LLM caiu para US$ 1,80 após a instalação do ClawRouter, um roteador open source que analisa cada prompt com 15 parâmetros e o envia ao modelo adequado mais barato. Metade das requisições se mostrou trivial e foi atendida por modelos econômicos sem perda de qualidade. O ClawRouter é compatível com a API da OpenAI, funciona como proxy e não exige mudanças no código da aplicação.
Processado por IA de Habr AI; editado por Hamidun News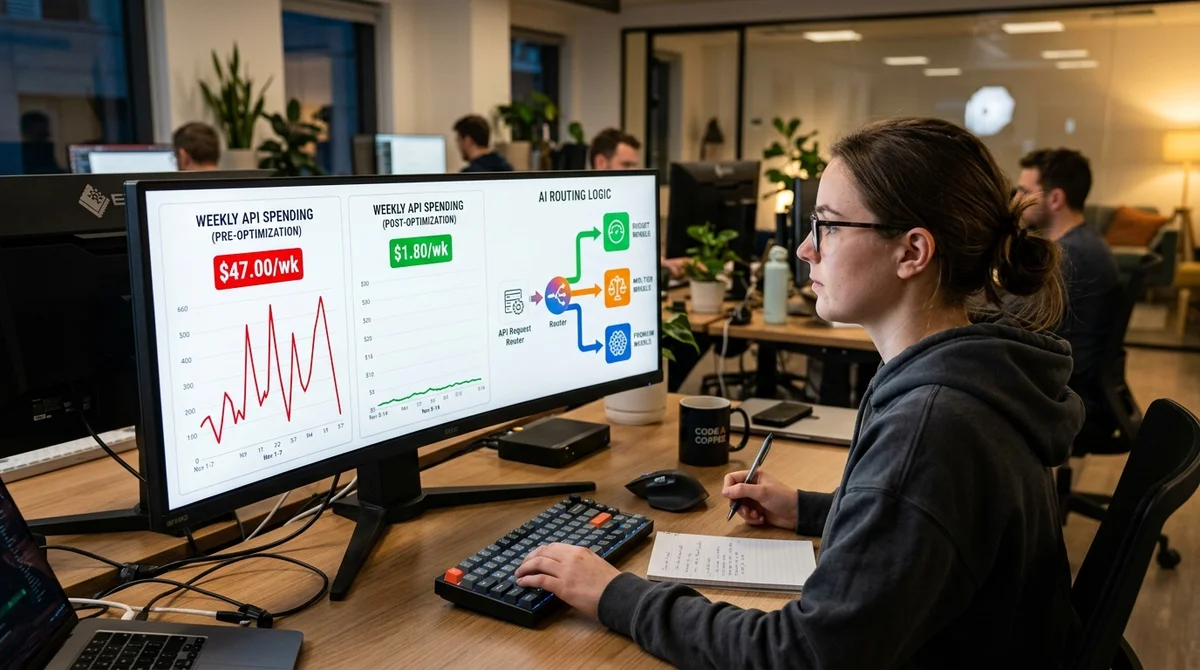
Desenvolvedores que usam APIs de LLM em projetos de produção costumam ter uma surpresa desagradável: boa parte das requisições a modelos de ponta caros são tarefas elementares que um modelo econômico resolveria. Foi o que descobriu um autor do Habr: em uma única semana de trabalho, ele gastou US$ 47 com APIs de LLM, embora, pela própria estimativa, metade dos prompts fosse trivial. Depois de instalar o ClawRouter, um roteador open source para requisições a LLMs, ele reproduziu a mesma semana por US$ 1,80. A economia foi de mais de 96%.
A lógica por trás desse número é simples: nem todas as tarefas têm a mesma complexidade, mas, sem roteamento, cada requisição é cobrada pela tarifa do modelo escolhido, independentemente da complexidade real. Se você usa Claude Sonnet ou GPT-4o como padrão para tudo, paga preço premium por respostas a perguntas triviais e transformações simples de texto.
O custo das APIs de LLM fica mais crítico à medida que os desenvolvedores passam dos experimentos para cargas de produção. Na fase de protótipo o gasto é desprezível, mas em produção ele cresce na proporção da atividade dos usuários. Uma requisição ao GPT-4o custa de 20 a 30 vezes mais que uma equivalente ao GPT-4o Mini, e na maioria das tarefas a diferença de qualidade passa despercebida. A arquitetura de "um prompt, um modelo caro" é a mais comum, embora seja a menos otimizada.
O ClawRouter é um servidor proxy open source que fica entre a sua aplicação e os provedores de LLM. Cada prompt recebido passa por uma análise em 15 parâmetros: complexidade da tarefa, tamanho e estrutura do contexto, necessidade de raciocínio passo a passo, trabalho com código, requisitos de formatação da saída, sensibilidade a erros e outros sinais. Com base nessa classificação, a requisição é encaminhada automaticamente ao modelo mais barato capaz de resolver a tarefa com qualidade aceitável.
Uma pergunta simples vai para o GPT-4o Mini ou o Claude Haiku. Uma requisição complexa, em várias etapas, vai para o GPT-4o ou o Claude Sonnet. Tarefas que exigem raciocínio muito preciso ou um trabalho delicado com código são enviadas aos modelos de topo.
A integração é mínima: o ClawRouter é compatível com o formato da API da OpenAI, então basta alterar a URL base no código da aplicação. Não é preciso mudar a lógica. Há suporte a OpenAI, Anthropic, Google e outros provedores.
Como pontos positivos, o roteamento é previsível, e logs detalhados explicam por que uma requisição específica foi para determinado modelo, o que ajuda a entender e melhorar a classificação. As regras são configuráveis de forma flexível para cada projeto e tipo de tarefa.
Como limitações, casos de borda às vezes são classificados de forma imprecisa: o roteador subestima a complexidade da tarefa e a envia a um modelo mais barato, o que reduz a qualidade da resposta. Esses casos exigem ajuste manual dos limiares.
Entre as alternativas há várias ferramentas maduras. O LiteLLM oferece amplos recursos de gerenciamento de vários provedores, balanceamento de carga, lógica de fallback e análises detalhadas, mas tem barreira de entrada maior. O RouteLLM, da Lmarena, usa um classificador treinado com dados reais. O OpenRouter é uma opção na nuvem que dispensa montar infraestrutura própria. Cada solução envolve seus próprios compromissos entre complexidade de configuração, nível de controle e custo da camada de roteamento.
A conclusão principal: cargas de trabalho reais são heterogêneas. A requisição "projete a arquitetura de um sistema distribuído" e a requisição "corrija um erro de digitação no texto" exigem recursos radicalmente diferentes, mas, sem roteamento, ambas são processadas pelo mesmo modelo caro. O roteamento inteligente elimina esse desequilíbrio automaticamente, sem mudanças na lógica da aplicação e sem perda de qualidade em tarefas complexas.
Para desenvolvedores individuais e equipes pequenas que gastam a partir de US$ 50 por mês com APIs de LLM, ferramentas como o ClawRouter se pagam já na primeira semana. Em cargas maiores, a economia pode ser ainda mais expressiva.
- 2 de nov. de 2026TJ Digital: 23% das páginas citadas por IA começam com resposta direta, contra 14% das não citadas
- 2 de nov. de 2026Arca entrega a agentes de IA tarefas financeiras de até 10 dias e deixa as transações com humanos
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.