T1 Cloud: H200 e L40S — análise técnica das GPUs para IA generativa
Nem toda tarefa de IA precisa da H200, a topo de linha. A T1 Cloud publicou uma análise técnica dos seus servidores com NVIDIA H200 e L40S, acompanhada de fotos do data center. A H200, com 141 GB de memória HBM3e, é voltada para o treinamento de modelos grandes e a geração de vídeo. A L40S, baseada na arquitetura Ada Lovelace, atende inferência, sistemas RAG e chatbots corporativos. O provedor ampliou seu portfólio de GPUs para que os clientes não paguem a mais por capacidade ociosa.
Processado por IA de Habr AI; editado por Hamidun News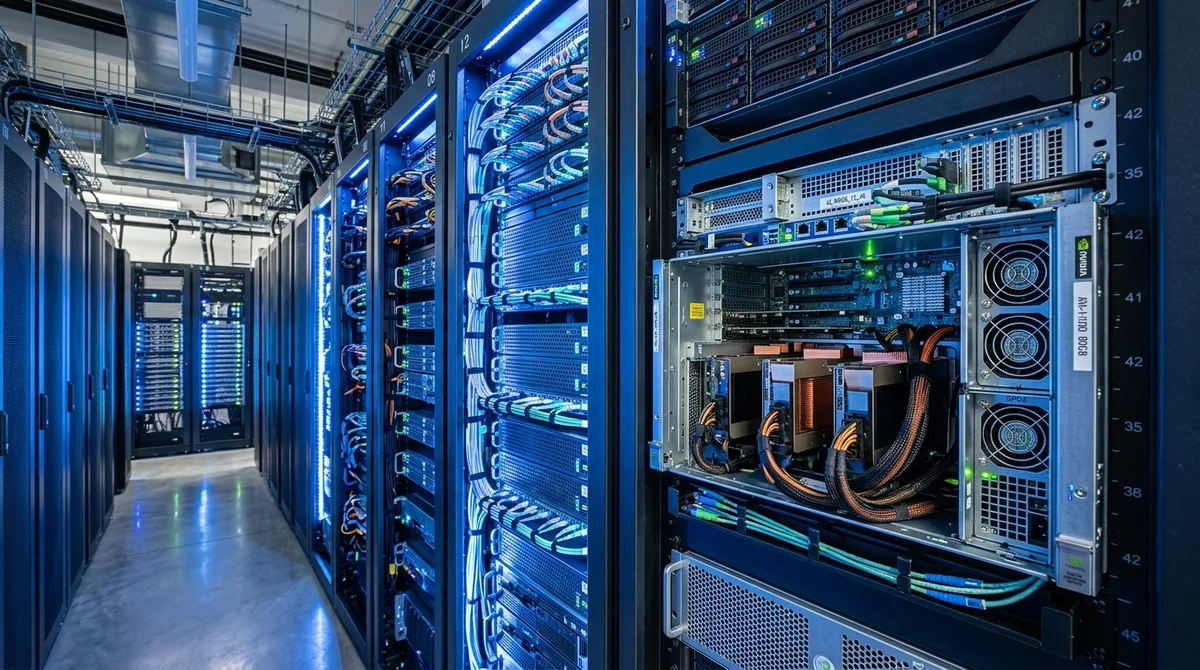
Escolher uma GPU para IA vai além da questão do orçamento. O ponto central é adequar a ferramenta à tarefa: contratar exatamente o poder computacional que cada cenário exige, sem pagar por especificações que nunca serão usadas. Foi esse princípio que orientou a expansão do portfólio de GPUs da T1 Cloud.
A empresa publicou uma análise técnica detalhada dos servidores com aceleradores NVIDIA H200 e L40S, com fotos tiradas diretamente do data center. O material chega em meio à demanda crescente por computação em GPU: à medida que os LLMs deixam de ser ferramentas experimentais e viram infraestrutura padrão nas empresas, as companhias enfrentam cada vez mais uma pergunta prática — qual acelerador serve para cada tarefa. A H200 ocupa o topo do mercado de GPUs.
Sucessora da H100, ela traz memória de nova geração HBM3e, com largura de banda de 4,8 TB/s, e capacidade ampliada: 141 GB, contra 80 GB da antecessora. É a placa para cargas que exigem manter modelos enormes na memória: grandes redes multimodais que geram texto, imagem e vídeo, treinamento do zero com centenas de bilhões de parâmetros e processamento de vídeo em alta resolução. A H200 suporta NVLink para conectar várias GPUs dentro do servidor e a interconexão de alta velocidade Infiniband entre nós — algo crítico em treinamentos de grande escala, em que os dados precisam circular rapidamente entre dezenas de nós.
A L40S é outra história. Trata-se de um acelerador da arquitetura Ada Lovelace com 48 GB de memória GDDR6 e Tensor Cores de quarta geração, otimizados para operações FP8 e BF16. Seu ponto forte está na versatilidade, e não em uma largura de banda de memória recorde.
A L40S lida igualmente bem com inferência de modelos de linguagem de porte médio, renderização, processamento de vídeo, visão computacional e design generativo. Se uma empresa precisa colocar no ar um chatbot corporativo baseado em documentos internos, montar um sistema RAG para uma base de conhecimento ou automatizar o processamento de imagens, a L40S resolve sem que seja preciso pagar pelas especificações de topo da H200. A T1 Cloud ampliou o portfólio de GPUs justamente para não empurrar aos clientes uma ferramenta cara demais onde ela não é necessária.
O data center da empresa agora conta com servidores para diferentes classes de carga: da inferência leve e sistemas RAG ao treinamento distribuído pesado. É um passo importante em um mercado no qual muitos provedores historicamente ofereciam apenas configurações topo de linha — o que levava as empresas a pagar por computação de que simplesmente não precisavam. O valor prático dessa abordagem é evidente.
Uma empresa que precisa de uma base de conhecimento corporativa com milhares de documentos internos e busca semântica não deveria alugar um cluster de H200. Uma ou duas L40S dão conta do recado. Já a mesma empresa, se estiver treinando um modelo multimodal especializado próprio ou trabalhando com vídeo em 8K, só terá ganho real com a H200 — e, nesse caso, economizar no hardware significa perder tempo e qualidade.
O formato da publicação também merece destaque: fotos detalhadas de data center são raridade no mercado russo de nuvem. A maioria dos provedores se limita a PDFs com especificações e slides de marketing. Mostrar o equipamento real junto com a descrição técnica traz transparência e ajuda engenheiros e equipes de compras a entender melhor como a infraestrutura funciona — algo especialmente relevante na hora de escolher um parceiro tecnológico de longo prazo.
A conclusão é clara: o crescimento do mercado de aceleradores de IA obriga os provedores de nuvem a pensar em uma segmentação bem feita, e não só em capacidade topo de linha. H200 e L40S não competem entre si; são ferramentas para tarefas fundamentalmente diferentes. As empresas que entendem isso e oferecem as duas opções com recomendações claras de uso ganham uma vantagem competitiva real: o cliente paga exatamente pelo que precisa — nem mais, nem menos.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.