Como um autor do Habr transformou sete fluxos do n8n em um sistema autônomo de notícias de IA
Um desenvolvedor mostrou como, em um mês e meio, transformou um frágil pipeline de notícias baseado em sete workflows do n8n em um sistema de IA quase autônomo. Em vez de controle manual, agora funcionam 11 workers, 5 agentes, um LLM local e um orquestrador no Telegram. O banco de dados já tem 7127 registros, e o sistema puxa 160 fontes únicas sem intervenção constante. A ideia central é abandonar um conjunto de automações dispersas e adotar um único sistema gerenciável, ao qual é possível passar tarefas diretamente por chat.
Processado por IA de Habr AI; editado por Hamidun News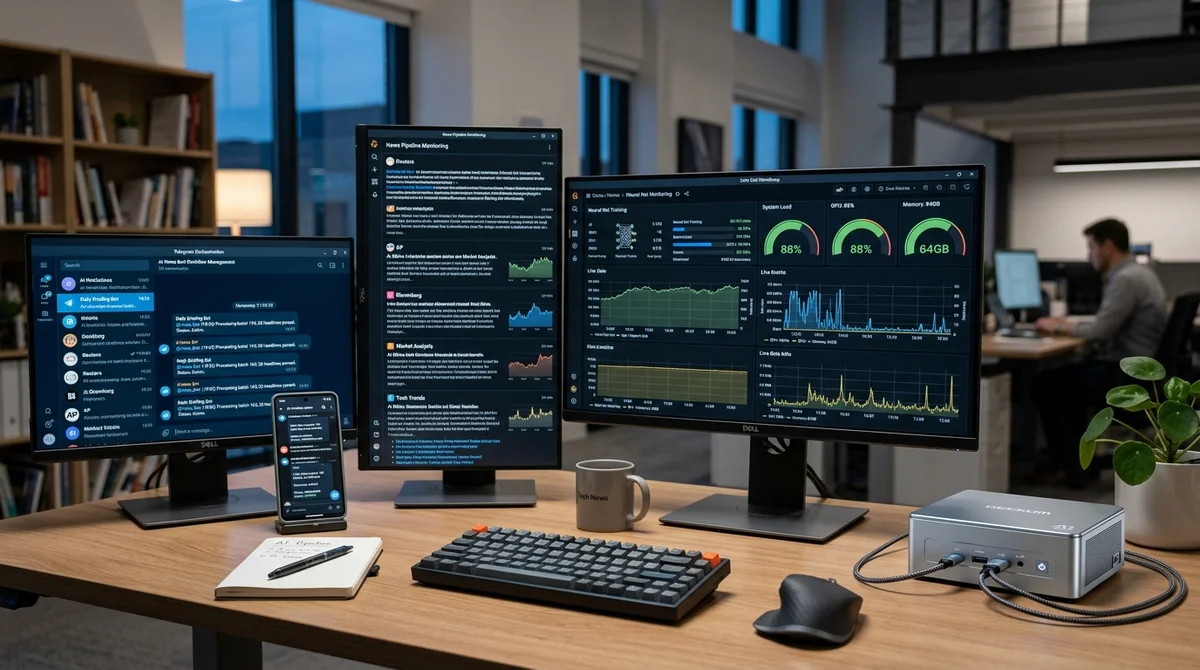
A história mostra como uma frágil montagem no-code pode virar, em poucas semanas, um sistema editorial completo: o autor abandonou sete fluxos separados no n8n e construiu um único pipeline em Python que coleta, filtra, traduz, formata e publica notícias de IA quase sem intervenção manual.
O ponto de partida foi o caos clássico das automações. Cada workflow do n8n cuidava de uma etapa: coleta de notícias, limpeza de duplicatas, tradução, preparo de imagens e publicação. Formalmente, tudo funcionava, mas qualquer erro virava uma longa caça à falha: um fluxo podia terminar "com sucesso" sem entregar nada, e a cadeia inteira desmoronava. Em certo momento, o autor percebeu que o principal problema não estava nas funções isoladas, mas na arquitetura: sete processos significavam sete pontos de falha distintos e observabilidade quase nula.
A nova versão foi montada como um único projeto. Segundo ele, ferramentas de IA aceleraram a transição: o Cursor ajudou a configurar o mini PC doméstico e a infraestrutura local, o Perplexity entrou na discussão de decisões de arquitetura, e o Claude Code ajudou a migrar o conjunto de workflows para Python e a subir um serviço em contêineres.
Assim surgiu um pipeline em que 11 workers executam uma tarefa cada. A cadeia básica é esta: o collector coleta dados de RSS e APIs de cerca de 160 fontes a cada 15 minutos, o scraper busca o texto completo, o deduplicator remove duplicatas semânticas, o ai_filter avalia a relevância, o translator traduz os materiais para o russo, o llm_editor ajusta os textos ao estilo desejado, o image_worker encontra ou gera ilustrações e o publisher publica os posts conforme o cronograma. Além disso, há processos em segundo plano para buscar repositórios no GitHub, trabalhar com vídeo e fazer moderação manual.
Há ênfase especial no modelo local. Em vez de arcar com custos contínuos de APIs na nuvem para tradução, o autor levou essa tarefa para um mini PC doméstico com Qwen 3.5, executado via llama.cpp e otimizado para Vulkan. Isso resolveu dois problemas de uma vez: reduziu o custo de processar um grande volume de notícias e manteve os dados dentro da própria infraestrutura.
Pelos números atuais, o sistema acumulou 7127 registros no banco, e o fluxo semanal de entrada chega a cerca de 1000 materiais. Mas a saída não é um feed infinito: após a filtragem por relevance_score, a revisão editorial e a distribuição por slots, são publicados apenas oito posts por dia. Segundo o autor, essa abordagem se mostrou mais eficaz que as 28 publicações diárias anteriores, quando o público via ruído demais e ignorava a maior parte do canal.
Outra camada importante é a orquestração de agentes. As decisões de publicação e os ajustes operacionais ficam no OpenClaw, onde atuam um coordenador e outros agentes de IA: editor, gerente do pipeline, auditor de fontes e analista. Basta escrever ao coordenador no Telegram, por exemplo pedindo para reduzir o limite diário de publicações, e ele mesmo chama a API, altera a configuração e confirma o resultado.
Em torno disso cresceu também um dashboard completo: ele mostra o status dos workers, a passagem de cada notícia pelas etapas, a eficácia das fontes, as filas, o cronograma de slots e os materiais publicados. Esse nível de transparência permite entender rápido onde o conteúdo travou e quais fontes vale desativar. Por exemplo, já na primeira semana ficou claro que cerca de 20 fontes não geram sinal útil, e o pass rate ajuda a separar as fontes ruidosas das realmente valiosas.
A principal conclusão não é que o no-code seja ruim e o Python seja bom. É antes um exemplo de como muda rápido a barreira de entrada para sistemas de IA complexos. O autor não escreve código por conta própria, mas conseguiu montar um produto funcional definindo tarefas, verificando soluções e conduzindo a arquitetura. A combinação de programação com IA, LLMs locais, infraestrutura doméstica barata e orquestração clara transforma um projeto pessoal de notícias em uma redação quase autônoma. Para mídias independentes e canais de nicho, é um sinal: o valor agora não vem da automação em si, mas da qualidade da seleção, da observabilidade do sistema e da capacidade de montar um pipeline robusto com as ferramentas disponíveis.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.