OpenGrall apresenta arquitetura para robôs com IA em que o modelo de linguagem cuida da estratégia
O OpenGrall propõe não entregar a motricidade diretamente ao LLM. O modelo de linguagem toma apenas decisões de alto nível, enquanto um circuito TinyML assume a execução e os reflexos de emergência. Os dados dos sensores são coletados de forma assíncrona e ponderados por atualidade e confiabilidade, e situações repetitivas são guardadas em cache. Com isso, o robô não trava a cada passo e pode funcionar até com modelos locais compactos.
Processado por IA de Habr AI; editado por Hamidun News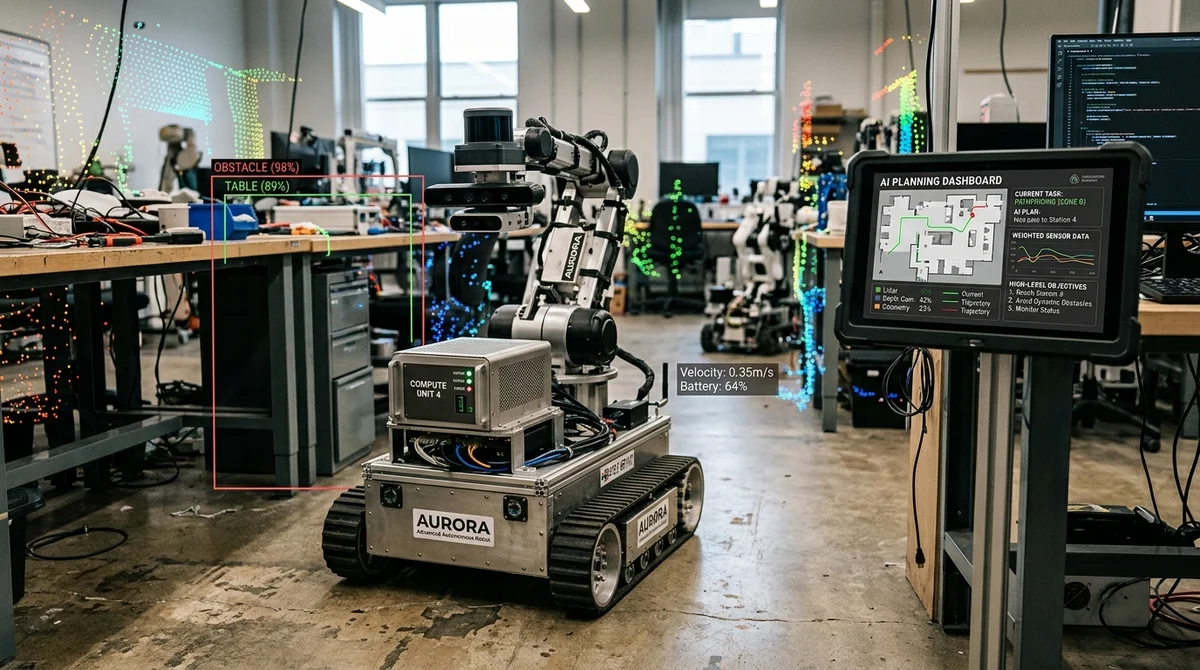
O OpenGrall propõe uma mudança simples, mas importante, na robótica: um LLM não deve controlar um robô no nível dos motores e das reações instantâneas. Aqui o modelo de linguagem responde apenas pelo sentido, pelo plano e pela escolha do próximo passo, enquanto a segurança, o movimento e os reflexos de baixo nível ficam em um circuito separado. Com isso, o projeto tenta eliminar o principal problema da maioria das demonstrações de «robôs com GPT», em que a máquina conversa bem, mas depois trava por alguns segundos antes de cada ação.
Os autores começam pelo ponto mais sensível: a segurança. O LLM é não determinístico: a mesma requisição pode gerar respostas diferentes, então confiar a ele o controle direto dos motores é perigoso. O OpenGrall introduz um esquema híbrido em que um modelo TinyML, ou outro circuito de execução rígido em um microcontrolador, faz o papel de «medula espinhal».
É ele que conhece a física da plataforma específica, controla a suspensão e a transposição de obstáculos, e tem direito de veto sobre qualquer comando. Se o operador ou o LLM mandam seguir em frente, mas o telêmetro vê um objeto a menos de 10 centímetros, o comando simplesmente não será executado. O tempo de reação declarado para uma parada de emergência é de menos de 10 milissegundos.
A lógica é totalmente pragmática: o LLM pensa, o módulo executor age e pode interromper uma ação perigosa a qualquer momento.
O segundo ponto forte do OpenGrall é a modularidade. O projeto separa «pensar» e «fazer» para que as duas partes possam ser trocadas de forma independente. No papel de cérebro pode atuar um LLM local, um VLM ou um modelo na nuvem, se for necessária uma tarefa mais complexa, como um plano em várias etapas ou uma busca na web.
No papel de executor, TinyML, um modelo VLA ou até um algoritmo comum escrito à mão, se a plataforma for simples. O sistema inteiro se conecta por um servidor WebSocket, e os dispositivos entram como clientes comuns, com papéis como agent, operator, lidar ou esp. Isso permite adicionar novos sensores sem reescrever o núcleo e até montar um esquema em que um agente trabalha com vários corpos ao mesmo tempo: por exemplo, uma plataforma com rodas e um drone.
Para um projeto de código aberto em hardware fraco, esse é um ponto especialmente importante: a arquitetura não está presa a um tipo de robô nem a um modelo específico.
O bloco de engenharia central é a dupla SensorMemory e WeightCalculator. Em vez de enviar ao LLM todos os fluxos brutos sem critério, o sistema coleta os dados de forma assíncrona, avalia sua atualidade e confiabilidade e depois os transforma em um prompt curto. Se o lidar sujar ou o VLM ficar cego com o sol, o peso deles cai antes de a decisão ser tomada. Se algum sensor é lento, isso não bloqueia os demais. O artigo traz um exemplo ilustrativo: a nuvem de pontos do lidar é condensada em oito setores, e objetos próximos são descritos por ângulo, distância, tamanho e velocidade. Para o LLM, isso deixa de ser ruído e vira uma situação estruturada.
Um detalhe importante é que o OpenGrall não tenta escrever à mão regras complexas de fusão de dados. O árbitro é o próprio LLM, que vê a fonte, a idade e o peso de cada sinal e, com base nisso, escolhe a ação em formato JSON. O prompt de sistema é embutido no modelo com antecedência, por exemplo via Ollama, de modo que, no ciclo de trabalho, vai na requisição apenas a parte operacional «nua». Pela estimativa do autor, isso reduz o prompt de cerca de 450 para 150 tokens.
Outro foco do artigo é o combate à lentidão. Em muitos frameworks clássicos, o robô espera o sensor mais lento, e por isso a telemetria rápida fica, na prática, ociosa. O OpenGrall abandona essa sincronização: lidar, VLM e odometria gravam dados na memória de forma independente, e o agente pega os valores mais recentes e confiáveis do momento. Mas, mesmo assim, o LLM ainda leva centenas de milissegundos para pensar, então no lado do ESP32 foi adicionado movimento inercial: se ainda não há um novo comando, o robô não fica parado feito um poste, mas continua suavemente a última ação segura, com a velocidade diminuindo gradualmente.
Outra camada de otimização é o cache de decisões por hash do contexto. Se o robô se depara de novo com o mesmo corredor vazio, o sistema não chama o modelo outra vez, e sim pega a decisão já validada no cache. Essa ideia evolui depois para hábitos e reflexos de alto nível: estratégias bem-sucedidas podem ser executadas sem o LLM, e o feedback humano aumenta o peso delas. Além disso, o projeto guarda uma memória episódica das instruções humanas e até admite a definição autônoma de objetivos, em que o robô ocioso escolhe sozinho o que explorar, o que memorizar ou com quem iniciar um diálogo.
Numa visão mais ampla, o OpenGrall é interessante não como mais uma tentativa de «acoplar o GPT a um robô», mas como uma tentativa de levar a robótica com LLM a uma arquitetura mais madura. Não há promessa de um cérebro universal mágico, mas há uma divisão clara de responsabilidades, trabalho com hardware limitado, proteção contra ações perigosas e um caminho para aprendizado gradual sem retreinar todo o sistema. Para os desenvolvedores, isso significa uma forma mais realista de construir robôs com modelos atuais: usar o LLM onde ele é forte e não obrigá-lo a fazer aquilo para que um circuito de execução pequeno, rápido e previsível é mais adequado.
- 2 de nov. de 2026DeepSeek abre o código do protótipo Super-agent: p95 de tempo de execução de 15,7 min, contra 29,5
- 2 de nov. de 2026Criador do Bun migra 750 mil linhas de Zig para Rust em 11 dias com Claude Code
- 2 de nov. de 2026Microsoft lança Mage-VL-Cowork, modelo de 4B que resolve 66,0% das tarefas do OSWorld-Verified
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.