Habr AI: como o Pipeline Triad monta um pipeline de agentes de IA no lugar de uma equipe de desenvolvimento
Em vez de um único «superagente» para desenvolver, propõe-se um pipeline de trios: criador, crítico e árbitro. O Pipeline Triad Pattern divide o SDLC em 14 etapas e deixa para a pessoa apenas quatro pontos de controle. Para uma tarefa corporativa típica, isso pode significar cerca de uma hora de tempo humano em vez de semanas. O modelo só funciona onde há regulamentos claros, validação forte e regras de segurança rígidas.
Processado por IA de Habr AI; editado por Hamidun News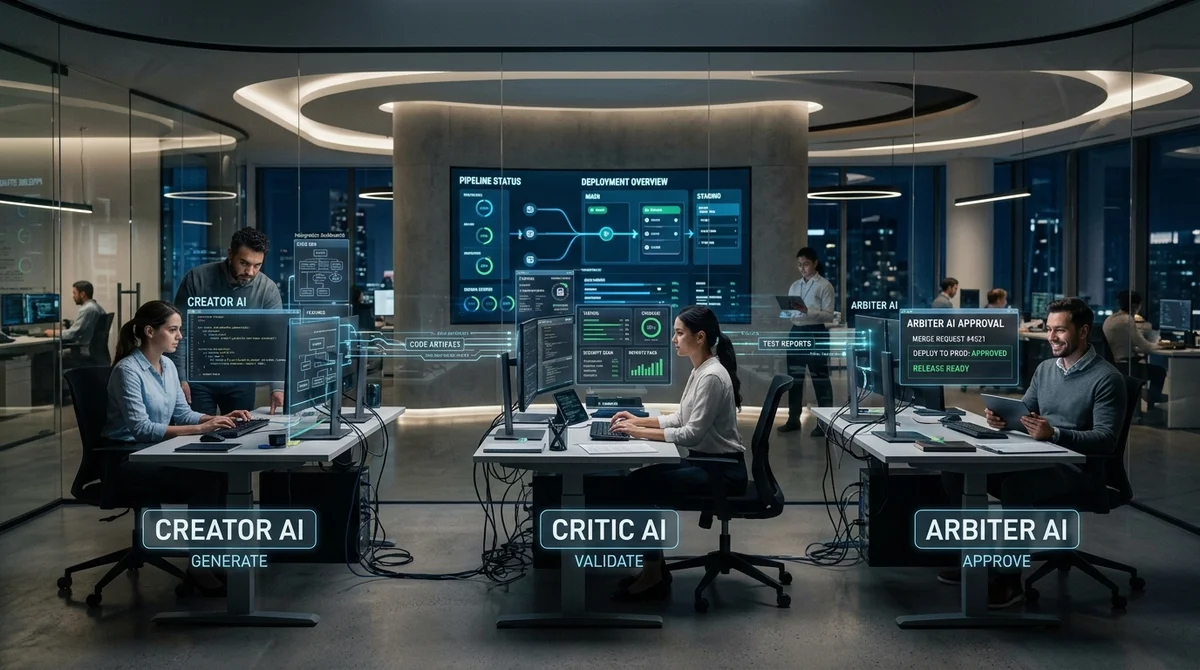
A ideia de um único desenvolvedor de IA universal vem cedendo espaço a um esquema mais prático: em vez de um «superagente», um pipeline de trios especializados, em que um agente gera o resultado, outro procura erros e um terceiro decide. É assim que funciona o Pipeline Triad Pattern, um modelo de desenvolvimento pensado não para demonstrações, mas para tarefas corporativas típicas, nas quais requisitos, padrões e regras já estão descritos e a pessoa mantém o controle em alguns dos pontos mais caros do processo.
O esquema se apoia em três papéis: Criador, Crítico e Árbitro. O primeiro gera um artefato, o segundo verifica lógica, qualidade e riscos, e o terceiro decide se o resultado segue adiante ou volta para ajustes. A abordagem parte de uma ideia simples: modelos de linguagem corrigem mal os próprios erros sem verificação externa, então é mais confiável não reforçar um único agente indefinidamente, e sim montar um trio independente com funções diferentes. O autor do padrão leva para o desenvolvimento com agentes o conhecido princípio corporativo maker-checker-approver e o estende a todo o SDLC.
O Pipeline Triad não é proposto como substituto do CI/CD. Os pipelines automáticos continuam compilando, testando e publicando o código, mas surge uma camada a mais por cima: a de delegação a agentes, em que as decisões não seguem um script rígido, e sim levam em conta contexto, regulamentos e regras de negócio.
O esquema completo tem 14 etapas, da definição da tarefa até a produção. Sete delas são etapas de agentes: análise, desenvolvimento, code review, testes, regressão, segurança e preparação dos artefatos de release. Outros quatro pontos ficam com humanos: validação de requisitos, aprovação de prontidão, confirmação do deploy e verificação final antes da produção.
Em cada etapa, o trio deve entregar não apenas uma resposta em texto, mas um pacote formalizado: o próprio artefato, critérios PASS ou FAIL, o registro de observações do Crítico e a decisão do Árbitro: aprovar, devolver ou aprovar parcialmente. Assim, o pipeline deixa de ser um conjunto de prompts e vira um processo reproduzível, com rastreabilidade das decisões. A etapa seguinte só começa quando recebe uma entrada válida, o que permite montar auditorias, medir a qualidade e analisar erros depois do fato.
O valor prático do padrão aparece melhor em uma tarefa típica. Como exemplo, o autor usa um endpoint bancário para congelar uma conta. Primeiro, o trio esclarece requisitos e cenários extremos. Depois, trios separados escrevem o código, verificam permissões de acesso, adicionam testes de condições de corrida e executam regressão e segurança. Em seguida, a pessoa apenas confirma algumas decisões-chave. Nesse cenário, a participação humana é estimada em cerca de uma hora no total, contra duas a três semanas em um processo corporativo clássico.
Sobre o custo, o autor calcula que uma execução completa via API envolve cerca de 42–84 chamadas ao modelo, 1–2 milhões de tokens de entrada e 200–400 mil de saída, o que dá uma referência de aproximadamente 6–12 dólares por tarefa. Para pilotos e ambientes pessoais, uma assinatura pode sair mais barata, mas para um fluxo de produção estável ainda será preciso calcular limites, orçamento e consumo real de tokens.
O modelo, porém, tem limites rígidos. Ele serve bem para change requests, bugfixes, tarefas de CRUD e API, integrações e mudanças de infraestrutura, em que o domínio é formalizado e o resultado pode ser verificado com testes e artefatos. O Pipeline Triad funciona pior onde há muita incerteza: discovery, arquitetura greenfield sem padrões maduros, P&D e grandes refatorações entre equipes.
Os riscos também são bem terrenos: o agente pode inventar uma regra de negócio inexistente, um Crítico mal configurado vai deixar erros passarem ou barrar tudo, e o trabalho paralelo em várias tarefas logo esbarra em conflitos de contexto, migrações e branches.
A segurança do próprio pipeline é um capítulo à parte. Se os agentes ganham acesso ao repositório, aos segredos e ao deploy sem restrições rígidas, o novo processo vira uma superfície de ataque adicional. Por isso o autor defende o princípio do menor privilégio, permissões separadas por papel, audit log completo, policy engine para o uso de ferramentas e filtragem de dados sensíveis antes de chegarem ao contexto do modelo.
Na prática, a ideia de uma «equipe de agentes» deixa de ser fantasia sobre um funcionário de IA universal e vira um modelo de engenharia mais pé no chão, em que a aceleração vem de especialização, entradas formalizadas e controle nas etapas caras. Mas o material também mostra com honestidade os limites da abordagem: ela não elimina aprovações organizacionais, não resolve o problema de uma especificação fraca e não tira a responsabilidade de pessoas experientes, que precisam validar o resultado. Se esses pipelines se tornarem padrão de trabalho, será primeiro em domínios corporativos previsíveis, onde o custo do erro é alto e as regras já podem ser transformadas em um processo verificável.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.