Google DeepMind apresenta o Gemini Robotics-ER 1.6 para autonomia de robôs e leitura de instrumentos
O Google DeepMind atualizou o Gemini Robotics-ER para a versão 1.6, uma camada cognitiva para robôs que entende melhor o espaço, identifica quando uma tarefa foi concluída e lê instrumentos industriais complexos. Nos testes de leitura de instrumentos, o modelo obteve 86% sem agentic vision e 93% com ela. Ele já está disponível pela Gemini API e pelo Google AI Studio.
Processado por IA de MarkTechPost; editado por Hamidun News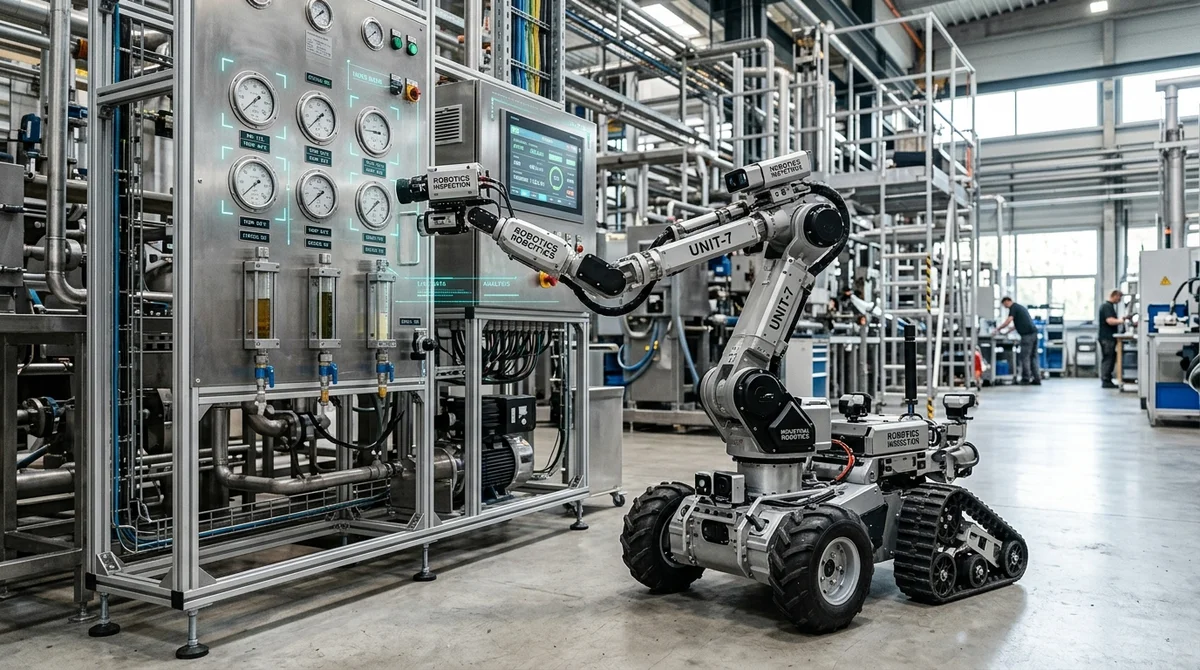
Em 14 de abril de 2026, o Google DeepMind apresentou o Gemini Robotics-ER 1.6, atualização do seu modelo de raciocínio que funciona como camada cognitiva superior para robôs no mundo físico. O objetivo da versão 1.6 não é acrescentar mais um VLA, mas dar ao robô um raciocínio espacial mais preciso: o modelo entende melhor a cena, conta objetos, determina se uma tarefa foi cumprida e, pela primeira vez, lê com confiança instrumentos complexos, como manômetros, medidores de nível e displays digitais.
O DeepMind chama o Gemini Robotics-ER de modelo reasoning-first para IA incorporada (embodied AI). Ele é pensado para situações em que não basta ao robô reconhecer um objeto: é preciso entender as relações entre os itens, escolher um ponto de preensão, verificar restrições e decidir o que fazer em seguida. A versão 1.6 reforça de forma notável o pointing, a capacidade de apontar objetos e usar esses pontos como etapa intermediária do raciocínio. Isso ajuda a contar itens com mais precisão, comparar tamanhos, traçar trajetórias e seguir instruções com condições espaciais.
O modelo também ganhou um multi-view understanding melhor: ele monta com mais eficiência uma visão única a partir de várias câmeras, por exemplo uma superior e outra instalada no manipulador. Para desenvolvedores, o Gemini Robotics-ER 1.6 já está disponível pela Gemini API e pelo Google AI Studio, com exemplos em Colab para configuração e prompt engineering.
A habilidade nova mais notável é a leitura de instrumentos, fruto da colaboração com a Boston Dynamics. Em instalações industriais, os robôs lidam com frequência com termômetros, manômetros circulares, visores e indicadores verticais de nível, nos quais importa não apenas classificar a imagem, mas extrair o valor com exatidão. Para isso, o Gemini Robotics-ER 1.6 usa agentic vision, que combina raciocínio visual e execução de código. O modelo primeiro aproxima o trecho relevante, depois marca pontos-chave, estima intervalos e proporções e, por fim, compara tudo com a escala, as unidades de medida e o contexto.
Segundo o Google DeepMind, na tarefa de leitura de instrumentos a versão 1.5 marcou 23%, o Gemini 3.0 Flash 67%, o próprio Robotics-ER 1.6 86% e, com agentic vision, 93%. Não se trata mais de demonstrar que o robô "vê" um instrumento, mas de um passo rumo a um cenário em que ele faz a própria ronda, lê as medições e entende o que elas significam.
Outro bloco importante é a detecção de sucesso e a segurança. Para um robô autônomo, não basta saber iniciar uma tarefa; é preciso entender quando ela foi de fato concluída e quando a tentativa deve ser repetida. O DeepMind afirma que o modelo lida melhor com a detecção de sucesso mesmo em cenas dinâmicas, com oclusões parciais e ângulos ambíguos.
Também melhorou o cumprimento de restrições físicas: por exemplo, o sistema deve respeitar melhor proibições como "não pegar líquidos" ou "não levantar objetos com mais de 20 kg". Nos testes de reconhecimento de situações perigosas a partir de texto e vídeo, a família Gemini Robotics-ER melhorou o resultado do Gemini 3.0 Flash em 6% e 10%, respectivamente.
O próprio Google faz uma ressalva separada: o modelo não se destina a aplicações críticas para a segurança, como medicina, transporte e outros ambientes em que um erro possa causar lesões ou danos.
O sentido prático do lançamento é que o Google vem transformando o raciocínio incorporado de tema de pesquisa em camada de infraestrutura para a robótica. O Gemini Robotics-ER 1.6 não controla o hardware diretamente, mas dá aos robôs um nível superior de raciocínio mais forte, que pode ser combinado com modelos VLA, busca e funções externas. Para o setor, é também um sinal de que a interface entre modelos de linguagem e robôs está mais próxima do uso comercial. Se essa combinação se provar fora do laboratório, o mercado terá robôs que não apenas seguem um roteiro, mas interpretam o ambiente, verificam o resultado e leem instrumentos reais sem um humano no circuito.
- 2 de nov. de 2026Criador do Bun migra 750 mil linhas de Zig para Rust em 11 dias com Claude Code
- 2 de nov. de 2026Jornalista da The Verge monta um rival do Meta Muse Charm por $50 com ajuda do Claude Code
- 1 de nov. de 2026Teste com 16 modelos em 7 buscadores: Exa fez em média 10,5 pontos de 14; SearXNG, cerca de 3
- 1 de nov. de 2026Agente de vídeo StreamVibe, do Google, supera outros modelos em 10,7% em timing e qualidade das respostas
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.