Claude e Qwen Omni: como um desenvolvedor ligou análise de vídeo a um pipeline de trabalho
Um desenvolvedor mostrou como transformar o Claude em uma ferramenta prática para analisar vídeo, conectando-o ao Qwen Omni. Em vez de fatiar o vídeo em quadros, o que faz o movimento se perder, a dupla de modelos descreveu e classificou automaticamente 29 referências de animação de um personagem. O ponto prático é simples: a boa lógica do Claude pode ser complementada por uma camada multimodal externa, eliminando de uma hora a uma hora e meia de rotina manual.
Processado por IA de Habr AI; editado por Hamidun News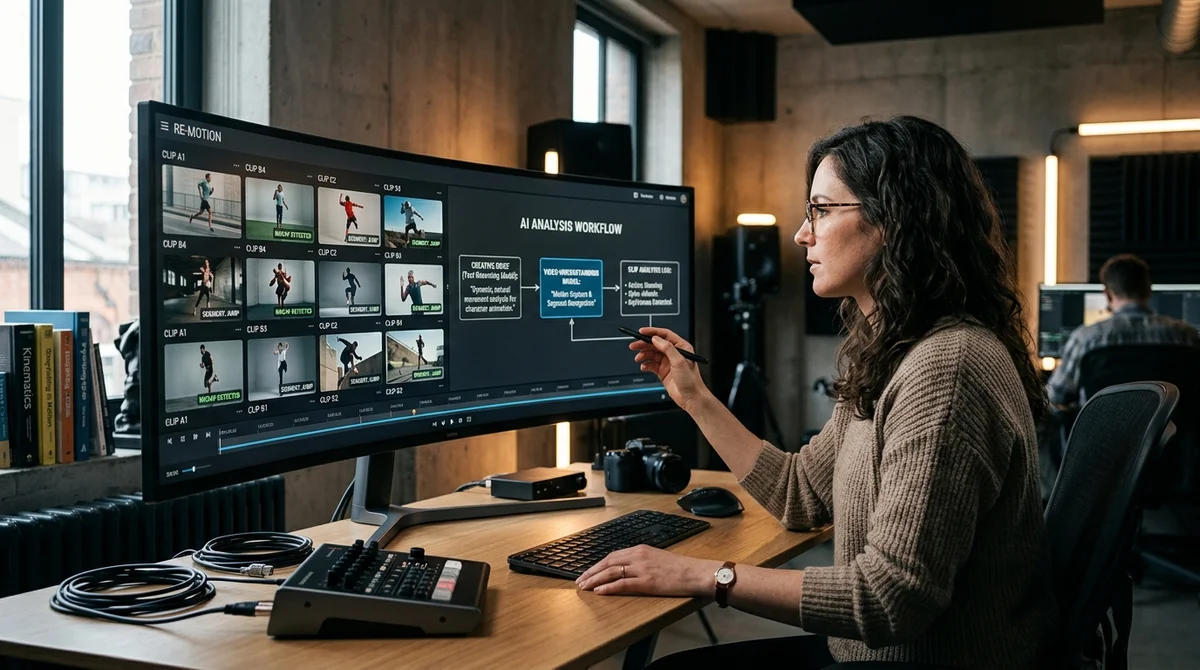
Em uma nova publicação no Habr, um desenvolvedor mostrou uma forma simples, mas útil, de ampliar as capacidades do Claude em tarefas que exigem analisar vídeo, e não imagens isoladas. Em vez de esperar que a Anthropic ofereça suporte nativo a vídeos, ele montou uma combinação de dois modelos: o Qwen Omni cuida da percepção multimodal, enquanto o Claude faz a análise, a estruturação e a redação do resultado. Na prática, isso transformou uma tarefa manual tediosa em um pipeline automatizado que economiza tempo e preserva melhor o contexto do movimento.
O problema que ele enfrentou é conhecido por quem trabalha com animação, motion design e referências visuais. Se você corta o vídeo em quadros e os envia ao modelo um a um, perde o que mais importa: a relação entre os estados, o ritmo, a trajetória da câmera, as transições entre poses e o desenho geral da ação. Em cenas estáticas, esse atalho ainda é tolerável, mas na análise de movimento ele rapidamente esbarra em limites.
Para tarefas como analisar técnicas de câmera, sincronizar gestos, acompanhar trocas de plano e avaliar o design final de um personagem, esse compromisso é quase inútil. O modelo enxerga um conjunto de imagens, e não um evento completo, e a pessoa ainda precisa reconstruir o sentido manualmente.
A tarefa concreta era bem prática: na pasta do projeto havia 29 vídeos de referência gerados, de animação de um personagem, que precisavam ser divididos em categorias e descritos brevemente do ponto de vista do movimento. Fazer isso à mão levaria cerca de uma hora ou uma hora e meia, em um trabalho de pouco valor agregado: abrir o arquivo, assistir, entender o tipo de movimento, anotar a descrição e passar para o próximo. Para profissionais criativos, essa rotina é especialmente penosa, porque consome tempo não para criar, mas para inventariar o material já criado.
A solução veio do Qwen Omni, que o autor já usava em outro projeto: um assistente digital em forma de personagem, que funciona em tempo real. A ideia se mostrou lógica: se um modelo entende bem entradas multimodais e outro é forte em interpretação e em produzir texto bem cuidado, dá para ligá-los em um único fluxo de trabalho. Nesse esquema, o Qwen Omni primeiro recebe o vídeo e extrai dele características relevantes e uma descrição do que acontece; depois o Claude usa esse material como base para uma categorização mais prática, comparações e conclusões em texto.
A partir daí, é possível obter não só um resumo bruto, mas descrições padronizadas, listas, rótulos e breves conclusões sobre cada vídeo da pasta. Não é uma transformação «mágica» do Claude em um modelo de vídeo completo, e sim uma composição prática de ferramentas especializadas.
Do ponto de vista da engenharia, o que importa é a abordagem. Em vez de procurar um modelo universal para todas as tarefas, o autor monta uma pilha de componentes com especializações diferentes. Para os usuários, isso indica um caminho mais realista para a multimodalidade: em vez de esperar que o LLM favorito aprenda tudo de uma vez, acrescentam-se sensores externos e camadas intermediárias.
Esse padrão é especialmente útil onde se valoriza não só o reconhecimento, mas também o raciocínio posterior: análise de cenas, descrição do comportamento do personagem, identificação de padrões típicos de movimento, preparação de anotações para a produção ou para a comunicação dentro da equipe. Pelo mesmo esquema, é possível analisar storyboards, vídeos de treinamento, gravações de interfaces e gerações de teste antes da edição.
A história do Claude com o Qwen Omni mostra que a limitação de um modelo nem sempre significa um beco sem saída para todo o processo. Se a tarefa for dividida em etapas (percepção, descrição, classificação e conclusão), fica claro qual parte já pode ser coberta por uma ferramenta de terceiros. Para criadores de conteúdo visual, animadores e artistas de IA, é um bom sinal: o valor nasce cada vez menos de um único modelo «mais inteligente» e cada vez mais de uma combinação bem montada, em que cada sistema faz aquilo em que realmente é bom.
- 2 de nov. de 2026Karpathy montou em duas horas um clone do YouTube com 6454 vídeos indicados no Hacker News
- 2 de nov. de 2026Karpathy usa o Claude para criar o HackerTube, com 6454 vídeos recomendados no Hacker News
- 2 de nov. de 2026Arca entrega a agentes de IA tarefas financeiras de até 10 dias e deixa as transações com humanos
- 2 de nov. de 2026Anthropic precisa crescer a receita 32% ao ano para cobrir contratos de US$ 850 bilhões
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.