Habr AI: por que modelos de linguagem precisam de guardrails e como se proteger de prompt hacking
Os LLMs estão deixando a fase de experimento e virando infraestrutura, e com isso o custo dos erros também sobe. Os guardrails se tornam uma camada de proteção obrigatória: filtram conteúdo tóxico, detectam prompt injection, restringem o acesso a ferramentas e reduzem o risco de vazamentos. Para desenvolvedores, o tema deixou de ser opcional. Virou uma área de engenharia própria, com um stack crescente de soluções, testes e verificações automáticas.
Processado por IA de Habr AI; editado por Hamidun News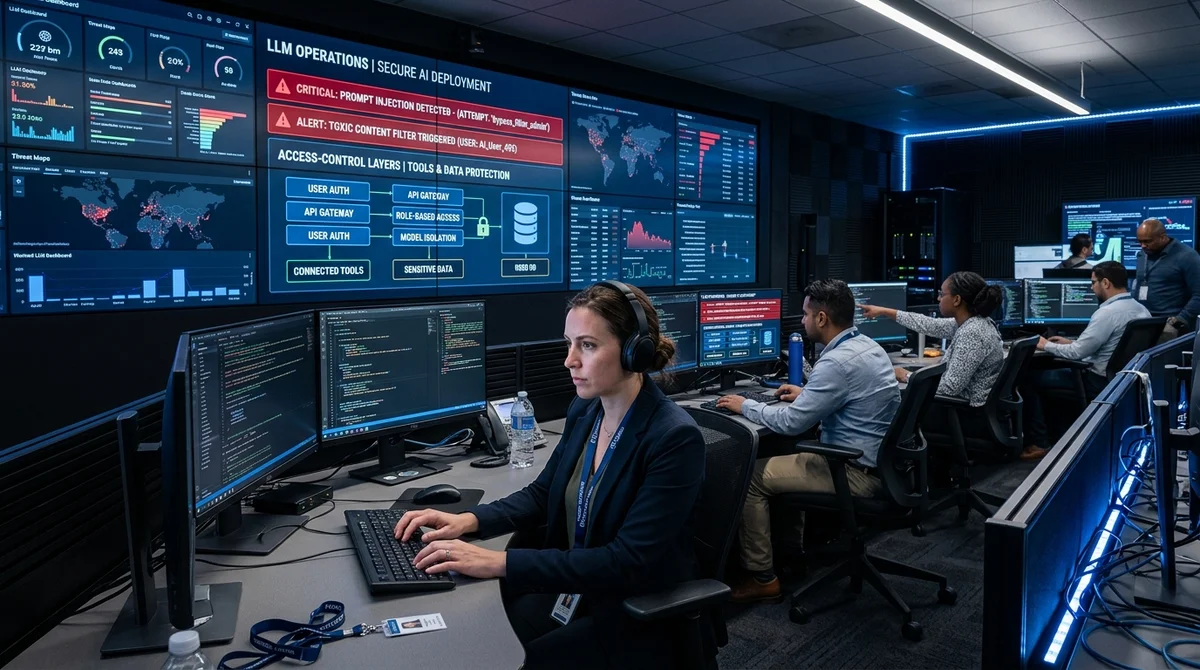
Os modelos de linguagem estão deixando de ser brinquedo de demo e se tornando uma camada de infraestrutura que afeta busca, suporte, análise de dados, vendas e processos internos das empresas. Nesta fase, o problema central passa a envolver, além da qualidade das respostas, a capacidade de controlar o comportamento do modelo. Se é possível tirar um LLM das regras, fazê-lo gerar texto tóxico, revelar instruções internas ou executar uma ação perigosa por meio de uma ferramenta conectada, um bom prompt não basta: o negócio precisa de um sistema completo de restrições de proteção, os chamados guardrails.
O termo costuma designar um conjunto de mecanismos que controlam o modelo na entrada, durante o processamento e na saída. E o assunto vai muito além de moderar palavrões ou bloquear pedidos claramente proibidos. As vulnerabilidades dos LLMs são bem mais amplas: ataques de prompt injection e jailbreak, contorno de instruções de sistema, alucinações, vazamento de dados pessoais ou corporativos, uso inseguro de APIs externas e documentos, além de manipulação via contexto que o modelo recebe de e-mails, CRM, páginas web ou bases de conhecimento.
Mesmo sem má intenção, um usuário pode formular uma solicitação de modo que o modelo ultrapasse os limites aceitáveis e, se tiver acesso a ferramentas, comece a executar ações que ninguém aprovou explicitamente. Quanto mais as empresas conectam LLMs a dados e ações reais, maior o risco de um erro do modelo deixar de ser só uma resposta estranha e virar um incidente de segurança, um dano à reputação ou um prejuízo financeiro direto. Por isso, um stack tecnológico próprio está se formando rapidamente em torno dos guardrails.
Ele inclui filtros de requisições de entrada, classificadores de intenção, detectores de instruções maliciosas, políticas de acesso a ferramentas, restrições por papel, mascaramento de dados sensíveis, checagem de fatos, validação de saída estruturada e pós-processamento da resposta antes do envio ao usuário. Em cenários com agentes, essa camada ganha ainda mais peso: o modelo deixa de apenas escrever texto e passa a chamar funções, fazer buscas, ler arquivos, criar tarefas ou alterar registros em sistemas. Aqui, os guardrails funcionam como um despachante de regras: definem quais ações são permitidas, em que ordem, com quais parâmetros e diante de quais sinais a cadeia precisa ser interrompida.
Na prática, a indústria está chegando à conclusão de que a segurança de LLMs não se resume a uma configuração no modelo: trata-se de uma arquitetura com várias verificações independentes. Daí o interesse por frameworks especializados, policy engines, plataformas de observability e práticas de red team voltadas a LLMs. Para desenvolvedores, isso abre uma nova especialização na interseção entre IA aplicada, engenharia de backend e segurança.
Saber montar um chat sobre a API de um modelo não basta: é preciso entender a superfície de ataque, projetar pipelines seguros, separar fontes de contexto confiáveis e não confiáveis, registrar em log respostas questionáveis, construir conjuntos de eval e verificar regularmente como o sistema se comporta sob a pressão de solicitações fora do padrão. Na prática, isso significa adotar alguns passos básicos desde o início: restringir rigidamente o acesso do modelo a dados e ferramentas pelo princípio do menor privilégio, separar instruções de sistema da entrada do usuário, tratar todos os documentos recebidos e o conteúdo web como potencialmente hostis, validar JSON e comandos antes da execução e manter um humano no circuito para operações arriscadas. Cresce também a demanda por equipes capazes de transformar essas verificações em parte do CI/CD e da análise de produto, em vez de uma auditoria pontual antes do lançamento.
As empresas que adotarem essas práticas mais cedo terão produtos mais seguros e, de quebra, uma economia de operação de LLMs mais previsível. A conclusão principal é simples: os guardrails deixam de ser um "complemento para os cautelosos" opcional e se tornam um nível obrigatório de maturidade para qualquer produto sério baseado em LLM. Quanto mais profundamente o modelo está integrado aos processos de negócio, menos importa o quão convincente ele soa e mais importa a confiabilidade com que o sistema resiste a entradas maliciosas, erros de contexto e à tentação de dar ao modelo permissões além do necessário.
Por isso, a demanda vai crescer pelos próprios modelos e, junto com ela, por ferramentas, testes e engenheiros capazes de manter a IA dentro de limites seguros.
- 18 de nov. de 2026Criador do Digg lança alternativa open source ao DocuSign: $240 por ano em vez de $8 100
- 18 de nov. de 2026AI Scientist, da Sakana, travava em 42% das execuções: o código era escrito pelo próprio modelo
- 18 de nov. de 2026Modelo de linguagem no ESP32-S3 chega a 406 tokens/s, 18 vezes mais rápido
- 12 de nov. de 2026Sindicato de Oakland garante requalificação em vez de demissões por causa da IA: 94,1% votaram a favor da greve
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.