Wildberries & Russ descreve o nível de maturidade de dados necessário para agentes de IA precisos
A Wildberries & Russ propôs um modelo de maturidade para a documentação de dados, de Rare a Well-Done, e mostrou por que agentes de IA passam a alucinar até em tarefas simples de SQL quando os metadados são ruins. No nível básico, são necessários um responsável, um modelo físico e tags de confidencialidade. No intermediário, um glossário e uma camada lógica. No nível-alvo, uma camada semântica completa para text-to-SQL e métricas de negócio precisas.
Processado por IA de Habr AI; editado por Hamidun News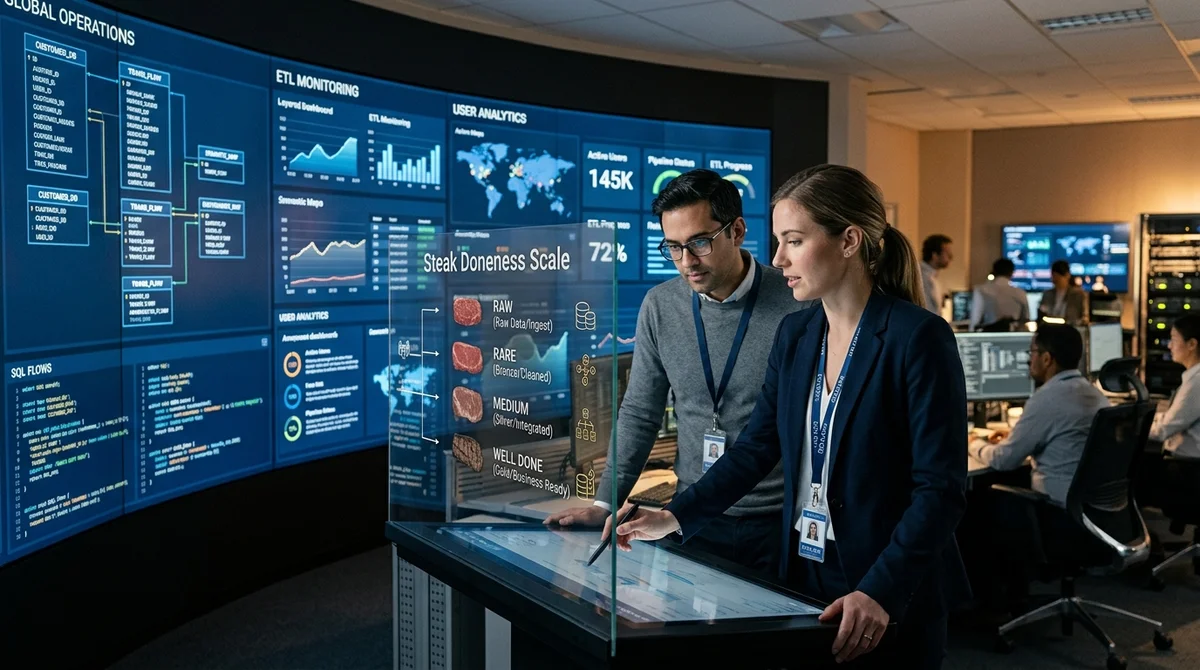
A Wildberries & Russ propõe avaliar a qualidade da documentação de dados com o mesmo pragmatismo do ponto de um bife: de Rare a Well-Done. A ideia é simples: quanto melhor a empresa descreve suas tabelas, campos, termos de negócio e métricas, menos os agentes de IA alucinam e mais se aproximam de insights de negócio reais, em vez de respostas plausíveis, porém inúteis.
A companhia afirma que o principal problema do big data hoje não é a falta de modelos, mas a manutenção fraca dos próprios dados. Em uma grande organização, novas tabelas surgem mais rápido do que as equipes conseguem documentá-las manualmente. Com isso, os analistas perdem tempo procurando as fontes certas, os indicadores passam a divergir entre relatórios e o acesso a conjuntos de dados sem classificação vira um risco de segurança. Isso é especialmente grave onde há dados pessoais e exigências rígidas de controle de acesso. Nesse ambiente, a abordagem manual simplesmente deixa de escalar.
O primeiro nível de maturidade, Rare, é considerado o mínimo suficiente para trabalhar com dados com segurança. Nele, cada conjunto deve ter um responsável, um modelo físico e uma classificação de confidencialidade. O modelo físico pode ser extraído automaticamente de tabelas de sistema e catálogos de dados e, se as descrições dos campos estiverem vazias, a IA pode tentar reconstruí-las a partir de convenções de nomenclatura e bases de conhecimento corporativas.
Com os responsáveis, a automação funciona pior: o modelo pode sugerir um candidato, mas a responsabilidade ainda é atribuída manualmente. Já a classificação de dados sensíveis parece uma das primeiras tarefas práticas para LLMs: o modelo pode analisar nomes de tabelas, colunas e termos de negócio e atribuir tags de segurança antes de uma varredura profunda do conteúdo.
No nível Medium, o foco passa da estrutura técnica para o significado de negócio. Aqui surgem o glossário e a camada lógica, que traduz a linguagem de tabelas e colunas para entidades e atributos compreensíveis para o negócio. Essa camada esconde prefixos de serviço, joins complexos e detalhes de armazenamento, e os data stewards podem usar a IA como copiloto para vincular campos a termos existentes e encontrar lacunas nas descrições.
Se o agente estiver conectado ao catálogo de metadados via MCP, ele consegue buscar sob demanda os esquemas necessários, compará-los com o glossário e acelerar um trabalho que antes levava horas. Além disso, a Wildberries & Russ propõe extrair relações não só da estrutura do data warehouse, mas também dos logs de consultas SQL: eles mostram quais tabelas os analistas mais combinam, quais filtros usam e como os dados são de fato consumidos.
O nível mais alto, Well-Done, serve não apenas para navegar pelos dados, mas para que text-to-SQL e sistemas agênticos funcionem de verdade. Aqui, uma camada semântica é construída sobre a descrição física e lógica: fatos, métricas, dimensões, relações, filtros e consultas verificadas em linguagem natural com respostas SQL prontas. É essa camada que explica ao modelo o que o negócio entende por "cliente ativo", "receita bruta" ou outra métrica, em vez de obrigá-lo a adivinhar o sentido pelos nomes dos campos.
O artigo traz um exemplo revelador. Se perguntarem a uma IA quantos clientes ativos houve em março, um modelo sem semântica pode simplesmente contar as linhas com status active, embora, pelas regras da empresa, cliente ativo seja aquele que fez ao menos um pedido acima de um limite definido. Segundo o autor, é aqui que padrões abertos como o OSI se tornam críticos, pois permitem descrever o significado dos dados em um formato portátil, compatível com ferramentas modernas de camada semântica.
O efeito prático também é citado: nos materiais da Snowflake para o Cortex Analyst, menciona-se um ganho de precisão de cerca de 20 por cento ao trabalhar com semântica corretamente descrita, e a meta para cenários reais é mais de 90 por cento de precisão em SQL.
O que isso significa na prática: o mercado vai se afastando da ideia de que basta conectar um LLM ao banco de dados e esperar mágica. A abordagem da Wildberries & Russ mostra uma trajetória mais sóbria: primeiro organizar responsáveis, estrutura e classificação dos dados, depois montar um dicionário lógico e só então construir a camada semântica para os agentes. Para empresas que querem levar assistentes de IA à análise de dados, é uma verdade desagradável, mas útil: a qualidade da resposta do modelo agora depende não só do modelo em si, mas da maturidade da documentação de dados dentro do negócio.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.